Understanding Deep Learning – Zusammenfassung und Einordnung
Simon J. D. Prince, Understanding Deep Learning (2023)
Einleitung
Géron zeigt, wie man Deep Learning anwendet. Prince erklärt, warum es funktioniert, und, ebenso wichtig, wo man es noch nicht versteht. Understanding Deep Learning ist ein Lehrbuch im besten Sinn: präzise, mit Mathematik, aber mit so vielen Abbildungen und Intuition, dass man die Formeln versteht, statt sie nur nachzurechnen.
Autor und Kontext
Simon J. D. Prince ist Honorarprofessor an der University of Bath und war zuvor in der Forschung bei Borealis AI und in der Industrie tätig. Bekannt ist er auch durch ein früheres Lehrbuch zum maschinellen Sehen. Understanding Deep Learning erschien Ende 2023 bei MIT Press. Das vollständige Buch steht als kostenloses PDF auf udlbook.com, unter einer Creative-Commons-Lizenz für nicht-kommerzielle Nutzung, und wird laufend korrigiert. Dazu gibt es rund 70 Python-Notebooks mit Übungen.
Die Kernthese
Deep Learning lässt sich aus wenigen Grundideen verstehen: Netze sind zusammengesetzte Funktionen, Verlustfunktionen folgen aus Wahrscheinlichkeiten, Training ist Optimierung in einer hochdimensionalen Landschaft. Gleichzeitig ist Prince ungewöhnlich ehrlich: Ein eigenes Kapitel fragt, warum Deep Learning überhaupt funktioniert, und räumt ein, dass viele Antworten noch offen sind.
Aufbau
| Bereich | Kapitel | Inhalt |
|---|---|---|
| Grundlagen | 1–9 | überwachtes Lernen, flache und tiefe Netze, Verlustfunktionen, Optimierung, Gradienten und Initialisierung, Leistung messen, Regularisierung |
| Architekturen | 10–13 | Faltungsnetze, Restnetze, Transformer, Graphnetze |
| Generative Modelle | 14–18 | unüberwachtes Lernen, GANs, Normalizing Flows, Variational Autoencoder, Diffusionsmodelle |
| Ausblick | 19–21 | Reinforcement Learning, warum Deep Learning funktioniert, Deep Learning und Ethik |
| Anhänge | Notation, Mathematik, Wahrscheinlichkeit |
Rund 540 Seiten. Vorausgesetzt werden lineare Algebra, Analysis und Wahrscheinlichkeitsrechnung auf Niveau eines Bachelorstudiums; die Anhänge frischen das Nötigste auf.
Überwachtes Lernen und flache Netze
Die Grundbegriffe
Prince beginnt mit einer klaren Sprache, die das ganze Buch trägt:
| Begriff | Bedeutung |
|---|---|
| Modell | eine Familie von Funktionen f(x, φ), die Eingaben x auf Ausgaben abbildet |
| Parameter | die Werte φ, die eine bestimmte Funktion aus der Familie auswählen |
| Verlustfunktion | eine Zahl, die misst, wie schlecht das Modell zu den Trainingsdaten passt |
| Training | die Suche nach Parametern mit kleinem Verlust |
| Test | die Prüfung auf neuen Daten: Verallgemeinert das Modell? |
So betrachtet ist ein neuronales Netz nichts Geheimnisvolles: eine besonders flexible Funktionsfamilie.
Flache Netze als stückweise lineare Funktionen
Das dritte Kapitel enthält die zentrale Intuition des Buchs. Ein flaches Netz mit einer verborgenen Schicht und ReLU-Aktivierung, die negative Werte auf null setzt, berechnet eine stückweise lineare Funktion: Jede verborgene Einheit fügt einen Knick hinzu. Mit D Einheiten entstehen bei einer Eingabe höchstens D + 1 lineare Abschnitte.
// Ein flaches Netz mit einer Eingabe: Summe von ReLU-Knicken
// y = phi0 + Σ phi[i] * ReLU(theta0[i] + theta1[i] * x)
record ShallowNet(double phi0, double[] phi, double[] theta0, double[] theta1) {

    double apply(double x) {
        double y = phi0;
        for (int i = 0; i < phi.length; i++) {
            double h = Math.max(0, theta0[i] + theta1[i] * x);   // ReLU: verborgene Einheit i
            y += phi[i] * h;
        }
        return y;
    }

    // Die Knickstellen: dort, wo eine Einheit von 0 auf positiv wechselt
    DoubleStream joints() {
        return IntStream.range(0, phi.length)
            .filter(i -> theta1[i] != 0)
            .mapToDouble(i -> -theta0[i] / theta1[i])
            .sorted();
    }
}
Mit genügend Einheiten kann ein solches Netz jede stetige Funktion beliebig genau annähern; das ist der universelle Approximationssatz. Bei mehreren Eingaben werden aus den Abschnitten konvexe Regionen im Eingaberaum, in denen die Funktion jeweils linear ist; Prince macht das mit vielen Abbildungen anschaulich.
Einordnung
Diese Sichtweise ist für Entwickler besonders zugänglich: Ein ReLU-Netz ist im Kern eine riesige, gelernte Fallunterscheidung, die den Eingaberaum in Regionen aufteilt und in jeder Region linear rechnet. Das macht verständlich, warum Netze zwischen Trainingsbeispielen oft sinnvoll interpolieren und außerhalb der Trainingsdaten oft unsinnig extrapolieren.
Tiefe Netze
Netze hintereinanderschalten
Wenn ein flaches Netz bereits jede Funktion annähern kann, warum dann tiefe Netze? Prince beantwortet das mit einem anschaulichen Bild: Schaltet man zwei Netze hintereinander, faltet das erste den Eingaberaum, und das zweite wendet seine Funktion auf jede gefaltete Lage an. Dadurch wiederholt sich das Muster des zweiten Netzes mehrfach.
Die Folge: Die Zahl der linearen Regionen wächst bei tiefen Netzen viel schneller mit der Zahl der Parameter als bei flachen. Mit gleich vielen Parametern kann ein tiefes Netz eine weit komplexere Funktion darstellen.
Tief gegen flach
| Gesichtspunkt | Flache Netze | Tiefe Netze |
|---|---|---|
| Ausdrucksstärke | universell, aber unter Umständen extrem breit | universell und deutlich effizienter |
| Lineare Regionen pro Parameter | wenige | sehr viele |
| Struktur | keine Hierarchie | Merkmale bauen aufeinander auf, etwa Kanten, Formen, Objekte |
| Training | einfacher | braucht Techniken gegen verschwindende Gradienten |
| Praxis | selten die beste Wahl | dominieren bei Bildern, Sprache, Audio |
Prince weist darauf hin, dass die Effizienzargumente zwar überzeugend sind, aber nicht vollständig erklären, warum tiefe Netze in der Praxis so gut verallgemeinern. Diese Frage greift er im vorletzten Kapitel wieder auf.
Matrizenschreibweise
Im Kern ist jede Schicht dieselbe Operation: Matrix mal Vektor, Verschiebung addieren, Aktivierungsfunktion anwenden. Ein tiefes Netz ist eine Verkettung dieser Operationen. Das erklärt, warum Grafikkarten, die Matrizenrechnung extrem parallel ausführen, für Deep Learning so wichtig sind.
Einordnung
Das Faltungsbild ist eine elegante Antwort auf eine Frage, die bei Géron offen bleibt. Für Softwareentwickler gibt es eine Parallele: Wie Funktionskomposition kleine, wiederverwendbare Bausteine zu mächtigen Abläufen verbindet, so verbinden tiefe Netze einfache Schichten zu komplexen Funktionen. Weidigs funktionaler Stil und Prince‘ Netze teilen dieselbe Grundidee.
Verlustfunktionen aus Wahrscheinlichkeiten
Das fünfte Kapitel gehört zu den erhellendsten des Buchs. Viele Einführungen stellen Verlustfunktionen als Rezepte vor: quadratischer Fehler für Zahlen, Kreuzentropie für Klassen. Prince leitet sie aus einem einzigen Prinzip her.
Das Prinzip
Statt das Netz direkt die Antwort vorhersagen zu lassen, betrachtet man es so, dass es die Parameter einer Wahrscheinlichkeitsverteilung über mögliche Antworten vorhersagt. Training bedeutet dann: Parameter so wählen, dass die tatsächlich beobachteten Antworten möglichst wahrscheinlich werden. Das ist das Prinzip der maximalen Likelihood. Der Verlust ist der negative Logarithmus dieser Wahrscheinlichkeit.
Was daraus folgt
| Art der Antwort | Angenommene Verteilung | Resultierender Verlust |
|---|---|---|
| eine reelle Zahl | Normalverteilung | quadratischer Fehler |
| ja oder nein | Bernoulli-Verteilung | binäre Kreuzentropie |
| eine von mehreren Klassen | kategoriale Verteilung, über Softmax | Kreuzentropie |
| eine Zahl mit wechselnder Unsicherheit | Normalverteilung mit vorhergesagter Streuung | Fehler, gewichtet nach Unsicherheit |
| eine Richtung oder ein Winkel | Verteilung auf dem Kreis | angepasster Verlust |
So erklärt sich, warum Raschkas Sprachmodell mit Kreuzentropie trainiert wird: Es sagt eine kategoriale Verteilung über das Vokabular vorher. Und es wird klar, wie man vorgeht, wenn keine Standardfunktion passt: eine geeignete Verteilung wählen und daraus den Verlust ableiten.
Einordnung
Für Entwickler ist das ein schönes Beispiel für Ousterhouts Rat, Sonderfälle wegzudefinieren: Statt vieler einzelner Rezepte gibt es eine allgemeine Regel, aus der die Rezepte folgen. Praktisch wichtig ist die Folgerung, dass ein Modell, das eine Verteilung vorhersagt, auch seine Unsicherheit ausdrücken kann; eine Voraussetzung für die Kalibrierung, die Huyen bei der Offline-Evaluation fordert.
Training: Optimierung, Gradienten, Initialisierung
Die Verlustlandschaft
Training heißt, in einer Landschaft mit Millionen oder Milliarden Dimensionen einen tiefen Punkt zu finden. Prince zeigt, warum das schwieriger ist als bei einfachen Modellen: Es gibt lokale Minima, flache Ebenen und vor allem Sattelpunkte, an denen es in manche Richtungen bergab, in andere bergauf geht. Gleichzeitig zeigt die Praxis, dass man in großen Netzen meist trotzdem gute Lösungen findet.
Optimierer
| Verfahren | Idee |
|---|---|
| Gradientenabstieg | in Richtung des steilsten Abstiegs gehen |
| Stochastischer Gradientenabstieg | den Gradienten auf kleinen, zufälligen Teilmengen schätzen; schneller und durch das Rauschen weniger anfällig für schlechte Stellen |
| Momentum | eine Art Trägheit: die bisherige Bewegungsrichtung teilweise beibehalten |
| Adam | Momentum und eine eigene Schrittweite pro Parameter, angepasst an die bisherige Größe der Gradienten |
// Ein Schritt des Adam-Optimierers für einen Parametervektor
final class Adam {
    private final double lr, beta1 = 0.9, beta2 = 0.999, eps = 1e-8;
    private final double[] m, v;      // gleitende Mittel von Gradient und quadriertem Gradient
    private int t = 0;

    Adam(int size, double lr) { this.lr = lr; m = new double[size]; v = new double[size]; }

    void step(double[] params, double[] grad) {
        t++;
        for (int i = 0; i < params.length; i++) {
            m[i] = beta1 * m[i] + (1 - beta1) * grad[i];               // Momentum
            v[i] = beta2 * v[i] + (1 - beta2) * grad[i] * grad[i];     // Größe der Gradienten
            double mHat = m[i] / (1 - Math.pow(beta1, t));             // Korrektur für den Anfang
            double vHat = v[i] / (1 - Math.pow(beta2, t));
            params[i] -= lr * mHat / (Math.sqrt(vHat) + eps);          // Schrittweite pro Parameter
        }
    }
}
Rückpropagation
Das siebte Kapitel erklärt, wie man die Gradienten berechnet. Die Rückpropagation läuft in zwei Durchgängen: vorwärts durch das Netz, wobei alle Zwischenergebnisse gespeichert werden, dann rückwärts, wobei mit der Kettenregel Schicht für Schicht die Ableitungen berechnet werden. Prince zeigt, dass das ein Spezialfall der algorithmischen Differentiation ist, die PyTorch automatisch ausführt. Die gespeicherten Zwischenergebnisse erklären, warum Training viel mehr Speicher braucht als Inferenz.
Initialisierung
Werden die Gewichte zu klein gewählt, schrumpfen die Signale von Schicht zu Schicht, sind sie zu groß, wachsen sie unkontrolliert. Prince leitet her, wie man die Streuung der Startwerte abhängig von der Schichtbreite wählt, damit Signale vorwärts und Gradienten rückwärts in vernünftiger Größe bleiben. Das ist die Begründung für die Standardeinstellungen, die Géron empfiehlt.
Einordnung
Hier werden Gérons Empfehlungen und Raschkas Trainingsschleife begründet. Der Speicherbedarf der Rückpropagation erklärt eine Kostenfrage, die Huyen aus Betriebssicht beschreibt: Finetuning braucht ein Vielfaches des Speichers der Inferenz.
Leistung messen und Regularisierung
Woher Testfehler kommen
Prince zerlegt den Testfehler in drei Quellen:
| Quelle | Bedeutung | Gegenmittel |
|---|---|---|
| Rauschen | Zufälligkeit in den Daten selbst | keines; das ist die untere Grenze |
| Verzerrung | das Modell ist zu unflexibel, um die wahre Funktion darzustellen | mehr Kapazität |
| Varianz | das Ergebnis hängt stark von den zufällig gezogenen Trainingsdaten ab | mehr Daten, Regularisierung |
Die klassische Lehre lautet: Mehr Kapazität senkt die Verzerrung, erhöht aber die Varianz; daraus ergibt sich die U-Kurve, die Géron zeigt.
Doppelter Abstieg
Prince beschreibt ein Phänomen, das dieser Lehre widerspricht und in den letzten Jahren viel Aufmerksamkeit bekam:
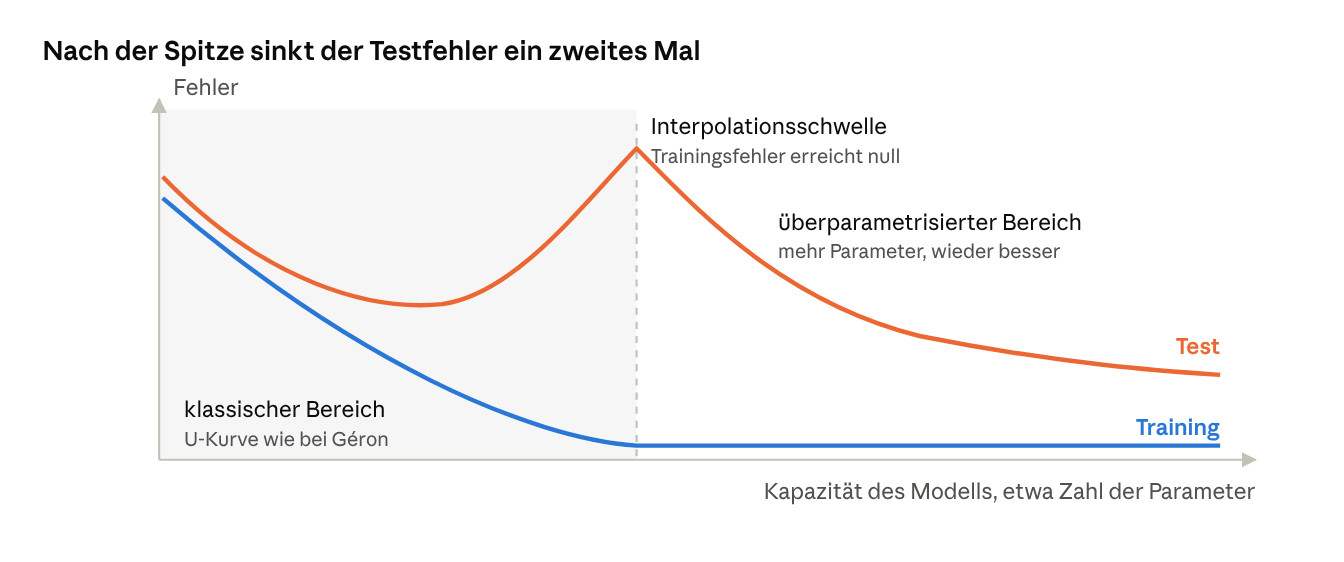
schematisch: doppelter Abstieg des Testfehlers bei wachsender Modellgröße
Wenn ein Modell gerade genug Parameter hat, um die Trainingsdaten exakt nachzubilden, ist der Testfehler besonders hoch. Erhöht man die Kapazität weiter, sinkt er wieder, oft unter das klassische Minimum. Das erklärt, warum riesige Netze mit mehr Parametern als Trainingsbeispielen trotzdem gut verallgemeinern. Warum genau, ist nicht vollständig geklärt; eine Vermutung ist, dass unter den vielen Funktionen, die die Daten exakt treffen, das Training bevorzugt glatte findet.
Regularisierung
Regularisierung umfasst alles, was die Verallgemeinerung verbessert, ohne die Trainingsdaten zu ändern:
| Art | Beispiele |
|---|---|
| Explizit | eine Strafe für große Gewichte im Verlust |
| Implizit | stochastischer Gradientenabstieg bevorzugt durch sein Rauschen von sich aus bestimmte, gut verallgemeinernde Lösungen |
| Heuristisch | frühes Stoppen, Ensembles, Dropout, Rauschen in Eingaben oder Gewichten |
| Über Daten | Datenerweiterung, Transfer Learning, Lernen mehrerer Aufgaben gleichzeitig, selbstüberwachtes Vortraining |
Einordnung
Der doppelte Abstieg ist eines der Ergebnisse, die zeigen, warum man moderne KI nicht allein mit klassischer Statistik verstehen kann. Er hilft auch, den Erfolg der Skalierung zu deuten, die Huyen beschreibt: Größere Modelle sind nicht nur ausdrucksstärker, sondern verallgemeinern unter Umständen auch besser.
Architekturen
Prince stellt die vier wichtigsten Architekturfamilien unter einem gemeinsamen Gedanken vor: induktive Verzerrung. Jede Architektur baut Annahmen über die Daten ein, die das Lernen erleichtern, weil das Netz bestimmte Muster nicht erst aus Daten lernen muss.
| Architektur | Eingebaute Annahme | Typische Daten |
|---|---|---|
| Faltungsnetze | lokale Muster sind überall im Bild gleich bedeutsam | Bilder, Audio |
| Restnetze | jede Schicht verändert ihre Eingabe nur ein wenig | sehr tiefe Netze aller Art |
| Transformer | Beziehungen zwischen Elementen hängen vom Inhalt ab, nicht von festen Positionen | Text, inzwischen auch Bilder und mehr |
| Graphnetze | Daten bestehen aus Knoten und Kanten, deren Reihenfolge keine Rolle spielt | Moleküle, soziale Netze, Verkehrsnetze |
Faltungsnetze
Prince unterscheidet Invarianz, das Ergebnis ändert sich nicht, wenn man das Bild verschiebt, etwa bei der Frage „ist eine Katze im Bild?“, und Äquivarianz, das Ergebnis verschiebt sich mit, etwa bei der Frage „wo ist die Katze?“. Faltungen sind äquivariant; durch Verdichtung werden sie schrittweise invariant.
Restnetze
Abkürzungsverbindungen addieren die Eingabe einer Schicht zu ihrer Ausgabe. Prince zeigt, warum das tiefe Netze trainierbar macht: Die Verlustlandschaft wird glatter, Gradienten fließen leichter, und das Netz kann einzelne Schichten nahezu überspringen, wenn sie nicht helfen. Ohne diese Idee gäbe es keine Transformer mit Dutzenden Schichten.
Transformer
Das Transformer-Kapitel ist knapper als Raschkas, aber mathematisch präziser. Prince zeigt, dass Selbstaufmerksamkeit gegenüber der Reihenfolge der Eingaben unempfindlich ist und deshalb Positionsinformation braucht, und behandelt Varianten für lange Sequenzen sowie Vision Transformer.
Graphnetze
Graphnetze sind in den anderen Büchern der Reihe kaum vertreten. Jeder Knoten sammelt Information von seinen Nachbarn, Schicht für Schicht; nach mehreren Schichten weiß er etwas über seine weitere Umgebung. Anwendungen reichen von Medikamentenforschung bis Betrugserkennung in Zahlungsnetzwerken.
Einordnung
Induktive Verzerrung ist für Architekten ein vertrautes Prinzip: Gute Abstraktionen bauen Wissen über die Domäne ein, wie Evans‘ Domänenmodell. Restnetze sind eine weitere Bestätigung von Becks und Fowlers Weisheit, dass kleine Änderungen leichter zu beherrschen sind als große; hier gilt das sogar für das Training selbst.
Generative Modelle
Der dritte Teil ist mit fünf Kapiteln der ausführlichste und der mathematisch anspruchsvollste. Prince beginnt mit einer Einordnung: Was sollte ein gutes generatives Modell können?
| Eigenschaft | Frage |
|---|---|
| Effizientes Erzeugen | Lassen sich neue Beispiele schnell ziehen? |
| Hohe Qualität | Sehen die Ergebnisse echt aus? |
| Abdeckung | Erzeugt das Modell die ganze Vielfalt der Daten, oder nur einen Ausschnitt? |
| Wahrscheinlichkeit berechenbar | Kann man sagen, wie wahrscheinlich ein Beispiel ist, etwa zur Anomalieerkennung? |
| Gut strukturierter innerer Raum | Führen kleine Änderungen der inneren Darstellung zu sinnvollen Änderungen im Ergebnis? |
Kein Verfahren erfüllt alles; jedes hat ein anderes Profil.
Die Verfahren
| Verfahren | Idee | Stärke | Schwäche |
|---|---|---|---|
| GANs | Erzeuger gegen Prüfer | scharfe, realistische Ergebnisse | instabiles Training, deckt oft nur einen Teil der Vielfalt ab |
| Normalizing Flows | umkehrbare Transformationen einer einfachen Verteilung | Wahrscheinlichkeiten exakt berechenbar | eingeschränkte Architektur |
| Variational Autoencoder | verdichten und wiederherstellen, mit einer Verteilung im inneren Raum | gut strukturierter innerer Raum | eher unscharfe Ergebnisse |
| Diffusionsmodelle | schrittweise Rauschen hinzufügen und lernen, es wieder zu entfernen | höchste Qualität und Vielfalt | langsames Erzeugen über viele Schritte |
Diffusionsmodelle
Das Kapitel über Diffusionsmodelle ist eine der besten Herleitungen, die es dazu gibt. Prince zeigt, wie man den Vorwärtsprozess, der ein Bild Schritt für Schritt verrauscht, mathematisch beschreibt, und warum es genügt, ein Netz zu trainieren, das in jedem Schritt das hinzugefügte Rauschen schätzt. Dazu kommen Verfahren, die die Erzeugung beschleunigen, und die Steuerung durch Text, wie sie Bildgeneratoren verwenden.
Einordnung
Für die meisten Leser der Reihe ist dieser Teil eher Hintergrund. Praktisch relevant ist die Abwägung zwischen den Eigenschaften: Wer generative Modelle zur Anomalieerkennung einsetzen will, braucht berechenbare Wahrscheinlichkeiten; wer Bilder erzeugen will, Qualität und Vielfalt. Das ist eine typische Architekturentscheidung mit Zielkonflikten, wie Richards und Ford sie beschreiben.
Reinforcement Learning
Das Kapitel über Reinforcement Learning ist präziser als Gérons. Prince beschreibt die Grundbegriffe, Zustände, Handlungen, Belohnungen, Strategien, und die Familien von Verfahren:
| Familie | Idee |
|---|---|
| Wertbasiert | lernen, wie viel Gesamtbelohnung eine Handlung in einem Zustand erwarten lässt, und dann die beste wählen |
| Strategiebasiert | die Strategie direkt so verändern, dass gute Handlungen wahrscheinlicher werden |
| Akteur und Kritiker | beides kombinieren: ein Netz handelt, ein anderes bewertet |
| Offline | aus vorhandenen Aufzeichnungen lernen, ohne selbst auszuprobieren |
Er verweist auch auf die Verbindung zu Sprachmodellen: Präferenz-Finetuning mit menschlichen Rückmeldungen ist eine Anwendung von Reinforcement Learning.
Warum funktioniert Deep Learning?
Das vorletzte Kapitel ist das ungewöhnlichste und vielleicht wertvollste des Buchs. Prince sammelt die Fragen, auf die es noch keine vollständigen Antworten gibt, und die Erklärungsversuche dazu.
Warum lassen sich Netze überhaupt trainieren?
Die Verlustlandschaft ist hochdimensional und nicht konvex; theoretisch könnte das Training ständig in schlechten Tälern stecken bleiben. In der Praxis passiert das selten. Erklärungsansätze: Mit sehr vielen Parametern gibt es so viele gute Lösungen, dass man fast immer eine findet; viele Minima sind über Pfade mit niedrigem Verlust miteinander verbunden; Sattelpunkte lassen sich verlassen.
Warum verallgemeinern sie?
Netze mit mehr Parametern als Beispielen könnten alles auswendig lernen, sogar zufällige Beschriftungen, was Experimente zeigen. Trotzdem verallgemeinern sie bei echten Daten gut. Erklärungsansätze:
- Implizite Regularisierung durch stochastischen Gradientenabstieg.
- Flache Minima, die gegenüber kleinen Änderungen robust sind und besser verallgemeinern sollen.
- Architektur mit passenden induktiven Verzerrungen.
- Der doppelte Abstieg im überparametrisierten Bereich.
Braucht man so viele Parameter?
Nach dem Training lassen sich oft große Teile eines Netzes entfernen, ohne Leistung zu verlieren. Die Lotterielos-Hypothese besagt, dass große Netze kleine Teilnetze enthalten, die allein ebenso gut trainierbar wären, wenn man sie nur von Anfang an kennen würde. Große Netze würden dann vor allem helfen, diese zu finden.
Einordnung
Das Kapitel ist ein Lehrstück in intellektueller Ehrlichkeit, wie man es aus Brooks‘ No Silver Bullet kennt: Es trennt, was man weiß, von dem, was man vermutet. Für Architekten folgt daraus eine nüchterne Haltung: Deep Learning ist empirisch erfolgreich, aber nicht vollständig verstanden; deshalb sind Tests, Monitoring und Evaluation, wie Huyen sie fordert, unverzichtbar.
Deep Learning und Ethik
Das letzte Kapitel hat Prince gemeinsam mit dem Philosophen Travis LaCroix geschrieben. Es ist kein Pflichtanhang, sondern ein durchdachter Überblick, der die Verantwortung der Entwickler ins Zentrum stellt.
Die Themenfelder
| Feld | Fragen |
|---|---|
| Wertausrichtung | Tun Systeme, was wir eigentlich wollen? Verzerrung und Fairness, Durchschaubarkeit, Erklärbarkeit |
| Absichtlicher Missbrauch | Gesichtserkennung zur Überwachung, militärische Nutzung, Betrug und Fälschungen, Verletzung der Privatsphäre |
| Weitere Folgen | geistiges Eigentum, übermäßiges Vertrauen in automatisierte Entscheidungen, Energie- und Umweltkosten, Auswirkungen auf Arbeit, Machtkonzentration |
Keine wertfreie Wissenschaft
Die Autoren wenden sich gegen die Vorstellung, Forschung und Technik seien wertneutral und nur ihre Anwendung sei moralisch zu bewerten. Schon die Wahl, welche Probleme man löst, mit welchen Daten und für wen, enthält Wertentscheidungen. Verantwortung lässt sich deshalb nicht vollständig an Gesetzgeber oder Anwender abgeben.
Ein Problem kollektiven Handelns
Ein einzelner Entwickler, der etwas Bedenkliches nicht baut, wird oft einfach ersetzt. Daraus folgt nicht, dass Einzelne machtlos sind, sondern dass es gemeinsame Normen braucht: in Berufsverbänden, Forschungsgemeinschaften, Unternehmen. Die Autoren nennen konkrete Schritte: Folgen früh mitdenken, Grenzen von Systemen offen dokumentieren, sich in der eigenen Organisation einbringen.
Einordnung
Das Kapitel schließt an Martins Clean Coder an, der Professionalität auch als Bereitschaft zum Nein beschreibt, und an Huyens Kapitel zu verantwortungsvoller KI, das konkreter, aber weniger grundsätzlich ist. Es ist die beste Vorbereitung auf Christians The Alignment Problem, das die Frage der Wertausrichtung zum Hauptthema macht.
Kritik und Einordnung
Stärken
- Verständnis statt Rezepte: Prince erklärt, warum Techniken funktionieren, und leitet sie aus wenigen Prinzipien her.
- Abbildungen: Hunderte sorgfältige Abbildungen machen Mathematik anschaulich, besonders bei stückweise linearen Funktionen, Verlustlandschaften und Diffusion.
- Ehrlichkeit: Das Kapitel über offene Fragen ist in Lehrbüchern selten.
- Aktuell und breit: Transformer, Diffusion, Graphnetze und Ethik in einem kohärenten Band.
- Kostenlos: Das vollständige PDF und die Notebooks sind frei verfügbar und werden gepflegt.
Kritikpunkte
1. Mathematik als Eintrittskarte. Wer lineare Algebra und Wahrscheinlichkeitsrechnung lange nicht genutzt hat, muss Zeit investieren. Die Anhänge helfen, ersetzen aber keinen Kurs.
2. Kaum Praxis. Kein Kapitel über Daten, Betrieb oder Evaluation in Produktion; die Notebooks sind Übungen, keine Projekte.
3. Sprachmodelle nur als Architektur. Wie man große Sprachmodelle trainiert, ausrichtet und einsetzt, kommt nur am Rand vor. Das Buch erschien zu einem Zeitpunkt, als sich das Feld gerade schnell veränderte.
4. Generative Modelle sehr ausführlich. Fünf Kapitel zu generativen Modellen sind für Leser, die vor allem Anwendungen bauen, mehr als nötig; Flows und Variational Autoencoder spielen in der Praxis heute eine kleinere Rolle.
Gesamturteil
Das beste aktuelle Lehrbuch, um Deep Learning wirklich zu verstehen. Für Java-Entwickler und Architekten ist es kein Arbeitsbuch, aber ein Gewinn für das Urteilsvermögen: Wer die Kapitel über Verlustfunktionen, Verallgemeinerung und offene Fragen gelesen hat, bewertet KI-Versprechen nüchterner. Weil es kostenlos ist, lohnt es sich auch als Nachschlagewerk zu einzelnen Kapiteln.
Bezüge zur Reihe
Wie, warum, was
| Frage | Buch |
|---|---|
| Wie wende ich Machine Learning an? | Géron |
| Warum funktioniert Deep Learning, und wo verstehen wir es nicht? | Prince |
| Wie funktioniert ein Sprachmodell im Detail? | Raschka |
| Was kann ich damit praktisch tun? | Alammar und Grootendorst |
| Wie baue und betreibe ich Systeme damit? | Huyen, beide Bücher |
Weitere Bezüge
| Thema bei Prince | Bezug in der Reihe |
|---|---|
| Netz als Funktionsfamilie, Komposition | Weidig: Funktionskomposition |
| ReLU-Netze als stückweise lineare Fallunterscheidung | Géron: Aktivierungsfunktionen |
| Verlustfunktionen aus maximaler Likelihood | Raschka: Kreuzentropie; Ousterhout: Sonderfälle wegdefinieren |
| Unsicherheit vorhersagen | Huyen: Kalibrierung |
| Adam, Initialisierung | Géron: Standardeinstellungen; Raschka: AdamW |
| Speicherbedarf der Rückpropagation | Huyen AI Engineering: Kosten des Finetunings |
| Doppelter Abstieg | Géron: U-Kurve; Huyen: Skalierung |
| Induktive Verzerrung | Evans: Domänenwissen im Modell |
| Restnetze und kleine Änderungen | Beck, Fowler: kleine Schritte |
| Zielkonflikte generativer Modelle | Richards und Ford: Architekturentscheidungen als Abwägungen |
| Offene Fragen ehrlich benennen | Brooks: No Silver Bullet; Accelerate: Empirie |
| Ethik als kollektive Aufgabe | Martin: Clean Coder; Huyen: verantwortungsvolle KI |
Diskussionsfragen
- Verstehen oder anwenden: Wie viel Theorie braucht ein Architekt, der KI-Systeme verantwortet? Reicht Géron, oder lohnt Prince?
- Fallunterscheidung: Hilft dir die Sicht auf ReLU-Netze als gelernte Fallunterscheidung, ihr Verhalten außerhalb der Trainingsdaten einzuschätzen?
- Unsicherheit: Liefern die Modelle in euren Systemen eine Einschätzung ihrer Unsicherheit? Wird sie genutzt?
- Größer ist besser? Wie verändert der doppelte Abstieg deine Einschätzung von „kleines Modell reicht“?
- Offene Fragen: Beunruhigt es dich, dass niemand vollständig erklären kann, warum Deep Learning verallgemeinert? Welche Konsequenzen ziehst du für Tests und Betrieb?
- Graphen: Gibt es bei euch Daten mit Netzstruktur, etwa Zahlungsflüsse oder Abhängigkeiten, für die Graphnetze interessant wären?
- Ethik: Wo verläuft für dich die Grenze, an der ein Entwickler Nein sagen sollte?
- Weiter: Als Nächstes Goodfellow, Bengio und Courville, Deep Learning, das Standardwerk von 2016, und die Frage, was davon heute noch trägt.