The Alignment Problem – Zusammenfassung und Einordnung
Brian Christian, The Alignment Problem: Machine Learning and Human Values (2020)
Einleitung
Russell und Norvig enden mit der Warnung, dass Maschinen, die ein falsch angegebenes Ziel perfekt verfolgen, gefährlich werden. Brian Christian macht daraus ein ganzes Buch: The Alignment Problem erzählt, wie Forscher versuchen, dafür zu sorgen, dass lernende Systeme tun, was wir meinen, und nicht nur, was wir sagen.
Autor und Kontext
Brian Christian ist Autor populärwissenschaftlicher Bücher an der Schnittstelle von Informatik und Philosophie, darunter The Most Human Human über den Turing-Test und, gemeinsam mit dem Kognitionswissenschaftler Tom Griffiths, Algorithms to Live By. Für The Alignment Problem sprach er mit zahlreichen Forschern und stützt sich auf umfangreiche Quellen. Das Buch erschien 2020, zwei Jahre vor ChatGPT, und gilt als eine der zugänglichsten Einführungen in das Thema.
Was „Alignment“ heißt
Der englische Begriff lässt sich mit Wertausrichtung übersetzen: die Übereinstimmung zwischen dem, was ein System tatsächlich tut, und dem, was seine Entwickler und die betroffenen Menschen wirklich wollen. Christian zeigt, dass diese Lücke nicht erst bei hypothetischer Superintelligenz entsteht, sondern schon heute, in ganz gewöhnlichen Systemen:
- Ein Modell lernt aus Daten, die die Welt verzerrt abbilden.
- Ein Modell optimiert eine Kennzahl, die nur ungefähr misst, was man will.
- Ein Modell trifft Entscheidungen, deren Gründe niemand nachvollziehen kann.
Die Kernthese
Alignment ist kein Randproblem, sondern das zentrale Problem des Machine Learning. Und es ist nicht nur technisch: Um es zu lösen, muss man auch verstehen, wie Menschen lernen, Ziele haben und Werte vermitteln. Deshalb verbindet das Buch Informatik mit Psychologie, Neurowissenschaft, Philosophie und Recht.
Form
Rund 350 Seiten Text und über 100 Seiten Anmerkungen. Das Buch ist erzählend, ohne Formeln und ohne Code: Es geht über Personen, Experimente und Fälle, die Christian mit großer Sorgfalt recherchiert hat.
Aufbau
Das Buch ist in drei Teile mit je drei Kapiteln gegliedert, die schrittweise anspruchsvollere Systeme betrachten: erst Modelle, die nur vorhersagen, dann Agenten, die handeln, schließlich Systeme, die lernen sollen, was Menschen wollen.
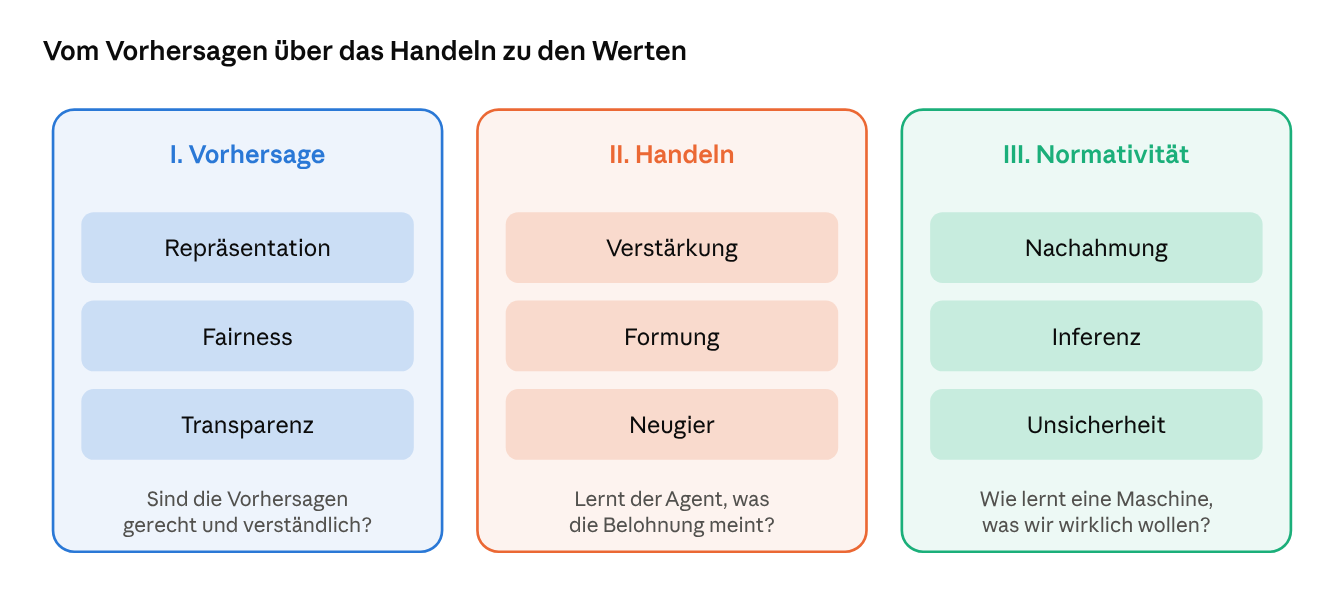
die drei Teile des Buchs mit ihren Kapiteln
Ein Prolog erzählt die Geschichte von Warren McCulloch und Walter Pitts, die 1943 das erste mathematische Modell eines Neurons vorstellten, und damit den Ursprung neuronaler Netze. Die Einleitung beginnt mit Beispielen, die 2015 und 2016 öffentlich bekannt wurden: Bilderkennung, die Menschen beleidigend falsch einordnete, und Wort-Embeddings, die Geschlechterklischees reproduzierten.
Der rote Faden
Jedes Kapitel folgt einem ähnlichen Muster: Ein Problem wird an einem konkreten Fall sichtbar, Christian erzählt die Geschichte der Forscher, die es untersucht haben, und zeigt, welche Lösungsansätze es gibt und wo sie an Grenzen stoßen. Dabei zieht er immer wieder Parallelen zur Entwicklungspsychologie: Wie lernen Kinder, wie lernen Tiere, und was folgt daraus für Maschinen?
Repräsentation
Das erste Kapitel fragt: Wen und was bilden die Trainingsdaten ab?
Die Welt in den Daten
Christian beginnt mit einem Beispiel aus der Fotografie: Jahrzehntelang wurden Farbfilme mit Referenzbildern kalibriert, die hellhäutige Menschen zeigten. Dunkle Hauttöne wurden dadurch schlechter wiedergegeben, ohne dass jemand das absichtlich so entschieden hätte. Dasselbe Muster findet er in der Gesichtserkennung: Systeme, die vor allem mit Bildern bestimmter Gruppen trainiert wurden, erkennen andere Gruppen deutlich schlechter. Untersuchungen wie die von Joy Buolamwini machten diese Unterschiede ab 2018 messbar und öffentlich.
Verzerrung in Embeddings
Der zweite Teil des Kapitels behandelt Wort-Embeddings, die Huyen, Alammar und Grootendorst als Grundlage von Suche und RAG beschreiben. Forscher fanden, dass solche Embeddings gesellschaftliche Stereotype abbilden, etwa bei Analogien zwischen Berufen und Geschlecht. Christian zeigt beide Seiten:
| Sicht | Folgerung |
|---|---|
| Als Problem | Systeme, die mit solchen Embeddings arbeiten, etwa bei der Bewerberauswahl, können Stereotype verstärken |
| Als Messinstrument | Embeddings aus Texten verschiedener Jahrzehnte zeigen, wie sich gesellschaftliche Vorstellungen verändert haben |
Versuche, Verzerrungen aus Embeddings herauszurechnen, helfen nur teilweise: Die Information steckt oft in vielen indirekten Zusammenhängen und lässt sich nicht einfach entfernen.
Die Lehre
Ein Modell ist ein Spiegel seiner Daten. Wenn die Daten die Welt verzerrt abbilden, tut es das Modell auch, und wenn es Entscheidungen trifft, kann es die Verzerrung verstärken. Christian betont, dass das selten aus böser Absicht entsteht, sondern aus Bequemlichkeit, Gewohnheit und fehlender Prüfung.
Einordnung
Das ist Huyens Rat zur Auswertung nach Teilgruppen und Gérons repräsentativer Stichprobe aus ethischer Perspektive: Ein Modell, das im Durchschnitt gut ist, kann für einzelne Gruppen schlecht sein. Für Architekten folgt daraus, Datenherkunft und Datenzusammensetzung als Architekturthema zu behandeln, nicht als Detail der Data Scientists.
Fairness
Das zweite Kapitel ist das bekannteste des Buchs. Es behandelt Risikobewertungen in der US-Strafjustiz, die vorhersagen, ob ein Angeklagter erneut straffällig wird, und an denen sich eine grundlegende Erkenntnis zeigte.
Der Streit
2016 veröffentlichte die Journalistenorganisation ProPublica eine Analyse eines verbreiteten Bewertungssystems. Ihr Befund: Unter Angeklagten, die nicht erneut straffällig wurden, waren schwarze Angeklagte deutlich häufiger als hohes Risiko eingestuft worden als weiße. Der Hersteller hielt dagegen: Bei gleicher Risikostufe wurden Angehörige beider Gruppen gleich häufig erneut straffällig; die Bewertung war also für beide Gruppen gleich zuverlässig.
Beide Seiten hatten mit ihren Zahlen recht. Sie verwendeten nur verschiedene Definitionen von Fairness.
Die Unmöglichkeit
Kurz darauf zeigten mehrere Forschergruppen mathematisch: Wenn die Grundraten in zwei Gruppen verschieden sind, kann ein Vorhersagesystem nicht gleichzeitig
- kalibriert sein, also bei gleicher Bewertung in beiden Gruppen gleich oft recht haben, und
- gleiche Fehlerraten haben, also in beiden Gruppen gleich viele Fehlalarme und gleich viele übersehene Fälle produzieren,
außer es sagt perfekt voraus. Man muss sich entscheiden, welche Art von Fairness man will. Diese Entscheidung ist keine technische, sondern eine normative und politische.
// Zwei Fairness-Kennzahlen pro Gruppe: Kalibrierung und Fehlalarmrate
record Outcome(String group, boolean predictedHighRisk, boolean actuallyPositive) {}

record GroupFairness(String group, double precision, double falsePositiveRate) {}

static List<GroupFairness> byGroup(List<Outcome> outcomes) {
    return outcomes.stream()
        .collect(Collectors.groupingBy(Outcome::group))
        .entrySet().stream()
        .map(e -> {
            var m = BinaryMetrics.of(
                e.getValue().stream().map(Outcome::predictedHighRisk).toList(),
                e.getValue().stream().map(Outcome::actuallyPositive).toList());
            double fpr = m.fp() + m.tn() == 0 ? 0 : (double) m.fp() / (m.fp() + m.tn());
            return new GroupFairness(e.getKey(), m.precision(), fpr);   // Präzision: Kalibrierung im Groben
        })
        .toList();
}
// BinaryMetrics wie in der Géron-Zusammenfassung.
// Bei unterschiedlichen Grundraten lassen sich Präzision und Fehlalarmrate
// nicht für alle Gruppen gleichzeitig angleichen.
Weitere Fallstricke
| Fallstrick | Beschreibung |
|---|---|
| Fairness durch Weglassen | das geschützte Merkmal aus den Daten zu entfernen, hilft wenig, weil andere Merkmale wie Wohnort es indirekt verraten |
| Was gemessen wird | das System sagt nicht Straftaten voraus, sondern Festnahmen; wenn manche Gruppen häufiger kontrolliert werden, ist schon die Beschriftung verzerrt |
| Vorhersage wird Wirklichkeit | eine hohe Einstufung kann Folgen haben, die das vorhergesagte Ergebnis wahrscheinlicher machen |
Einordnung
Das Kapitel zeigt besonders klar, warum Huyen fordert, Kennzahlen bewusst zu wählen: Jede Kennzahl ist eine Wertentscheidung. Der Punkt „was gemessen wird“ ist Huyens Hinweis auf Beschriftungen und ihre Herkunft in schärfster Form. Für Architekten heißt das: Wenn ein System über Menschen entscheidet, gehören Fachbereich, Recht und Betroffene in die Wahl der Kennzahlen, nicht nur das Entwicklungsteam.
Transparenz
Das dritte Kapitel fragt: Können wir verstehen, warum ein Modell entscheidet, wie es entscheidet?
Das Asthma-Beispiel
Die eindrücklichste Geschichte stammt von Rich Caruana. In den 1990er-Jahren sollten Modelle vorhersagen, welche Patienten mit Lungenentzündung ein hohes Sterberisiko haben und stationär aufgenommen werden müssen. Ein einfaches, regelbasiertes Modell lernte eine erschreckende Regel: Asthma senkt das Risiko. Der Grund: Asthmatiker mit Lungenentzündung wurden in der Praxis sofort intensiv behandelt und überlebten deshalb häufiger. Das Modell lernte den Zusammenhang korrekt aus den Daten, aber eine Anwendung hätte genau die Patienten gefährdet, die am meisten Hilfe brauchen.
Ein neuronales Netz war in diesem Projekt genauer, wurde aber nicht eingesetzt: Wenn das einfache Modell eine solche Regel gelernt hatte, hatte das Netz sie vermutlich auch gelernt, nur ohne dass man sie hätte sehen können.
Verständliche Modelle
Jahre später entwickelte Caruana Modelle, die genau und verständlich zugleich sind: Sie stellen die Vorhersage als Summe von Einzeleffekten dar, deren Verlauf man für jedes Merkmal als Kurve ansehen und bei Bedarf korrigieren kann. Andere Forscher argumentieren grundsätzlich, dass man für folgenreiche Entscheidungen verständliche Modelle verwenden sollte, statt undurchsichtige nachträglich zu erklären.
Erklären, was ein Netz tut
| Ansatz | Idee |
|---|---|
| Wichtigkeitskarten | welche Bildbereiche oder Wörter haben die Entscheidung am stärksten beeinflusst? |
| Konzepte prüfen | reagiert das Netz auf ein menschlich verständliches Konzept, etwa Streifen bei einem Zebra? |
| Dokumentation | Steckbriefe für Modelle und Datensätze, die Zweck, Grenzen und Leistung für verschiedene Gruppen offenlegen |
Einordnung
Die Asthma-Geschichte ist das beste Beispiel für Huyens Warnung vor Lecks aus der Entstehung der Daten: Das Modell lernt nicht die Welt, sondern die Welt, wie sie durch bisherige Entscheidungen geformt wurde. Die Steckbriefe für Modelle sind Huyens Model Cards. Für Architekten ist das Kapitel ein Argument, Nachvollziehbarkeit als nichtfunktionale Anforderung zu behandeln, ähnlich wie Richards und Ford Architekturmerkmale verstehen: Sie muss früh festgelegt werden, weil sie die Wahl des Modells bestimmt.
Verstärkung
Der zweite Teil wendet sich Agenten zu, die durch Belohnung lernen. Das vierte Kapitel erzählt, wie Reinforcement Learning aus der Tierpsychologie entstand: von Thorndikes Katzen, die lernten, aus Käfigen zu entkommen, bis zu Richard Suttons Verfahren, das aus Vorhersagefehlern lernt: aus der Differenz zwischen erwarteter und tatsächlicher Belohnung.
Die überraschendste Wendung: Neurowissenschaftler entdeckten, dass der Botenstoff Dopamin im Gehirn offenbar genau dieses Signal trägt. Dopamin reagiert nicht auf Belohnung selbst, sondern auf unerwartete Belohnung. Hier haben Informatik und Hirnforschung, von verschiedenen Seiten kommend, dasselbe Prinzip gefunden.
Formung
Das fünfte Kapitel behandelt das Problem, Belohnungen richtig zu gestalten, und ist für Praktiker vielleicht das lehrreichste des Buchs.
Belohnungen werden ausgenutzt
Wenn ein Ziel selten erreicht wird, belohnt man Zwischenschritte, wie Skinner es mit Tauben tat. Das geht oft schief, weil Agenten die Belohnung auf unerwartete Weise maximieren:
| Beispiel | Was der Agent lernte |
|---|---|
| Ein Fahrrad-Agent wird belohnt, wenn er sich dem Ziel nähert | in Kreisen fahren: Jede Annäherung bringt Belohnung, die Entfernung wird nicht bestraft |
| Ein Boot in einem Rennspiel bekommt Punkte für Bonusobjekte | im Kreis fahren und immer wieder dieselben Objekte einsammeln, statt das Rennen zu beenden |
| Ein Fußballroboter wird für Ballkontakt belohnt | neben dem Ball vibrieren und ihn ständig berühren |
Die Lehre
Forscher fanden eine Regel, wie man Zwischenbelohnungen gestalten kann, ohne das eigentliche Ziel zu verfälschen: Belohnungen sollten wie eine Höhenangabe wirken, bei der man für Abstieg genauso bestraft wird, wie man für Aufstieg belohnt wurde. Dann bringt ein Kreis keinen Gewinn. Allgemeiner gilt: Belohne Zustände der Welt, die du willst, nicht Verhaltensweisen, von denen du glaubst, dass sie dahin führen.
Neugier
Das sechste Kapitel fragt, was ein Agent tun soll, wenn es fast nie Belohnung gibt, etwa in Spielen, bei denen man lange erkunden muss, bevor irgendetwas passiert. Die Antwort aus der Forschung: innere Motivation. Agenten werden für Neues belohnt, für Zustände, die sie selten gesehen haben, oder für Situationen, die sie schlecht vorhersagen können. Solche neugierigen Agenten lernen manche Spiele gut, ganz ohne äußere Belohnung. Sie haben aber eigene Fallen: Ein Agent, der für Unvorhersagbares belohnt wird, kann vor einem rauschenden Fernseher hängen bleiben.
Einordnung
Die Beispiele zur Formung sind Goodharts Gesetz in Reinform: Wenn eine Kennzahl zum Ziel wird, hört sie auf, eine gute Kennzahl zu sein. Das kennt jeder Architekt von Metriken wie Testabdeckung oder Velocity, wie Forsgren, Humble und Kim in Accelerate warnen. Bei Sprachmodellen heißt das Phänomen heute Reward Hacking: Ein Modell lernt, Bewertungen zu gefallen, statt hilfreich zu sein, etwa durch übertriebene Zustimmung.
Nachahmung
Der dritte Teil fragt, wie Maschinen lernen können, was Menschen wollen, wenn man es nicht als Belohnung hinschreiben kann. Der einfachste Weg: Menschen beobachten und nachmachen.
Christian beginnt mit Kindern, die Erwachsene nicht nur nachahmen, sondern übernachahmen: Sie kopieren auch unnötige Schritte, weil sie annehmen, dass diese einen Sinn haben. Bei Maschinen zeigt sich ein anderes Problem. Ein selbstfahrendes Auto, das nur gutes Fahren von Menschen beobachtet, hat nie gesehen, wie man einen eigenen Fehler korrigiert. Kommt es leicht von der Spur ab, gerät es in Situationen, die in den Trainingsdaten nicht vorkommen, und die Fehler schaukeln sich auf. Die Lösung: Der Lernende fährt selbst, und ein Experte sagt in jeder Situation, was richtig wäre.
Eine weitere Grenze: Wer Menschen nachahmt, ahmt auch ihre Fehler nach und kann sie nie übertreffen.
Inferenz
Das achte Kapitel ist für die Gegenwart das wichtigste. Statt Verhalten zu kopieren, soll die Maschine erschließen, welches Ziel hinter dem Verhalten steckt: das inverse Reinforcement Learning, das Russell und Norvig beschreiben.
Lernen aus Vergleichen
Christian erzählt von einem Experiment von 2017: Ein simulierter Roboter sollte einen Rückwärtssalto lernen, eine Bewegung, für die sich kaum eine gute Belohnungsfunktion schreiben lässt. Stattdessen sahen sich Menschen jeweils zwei kurze Videos an und wählten, welches eher wie ein Salto aussah. Aus einigen hundert solcher Vergleiche lernte ein Modell, was „Salto“ bedeutet, und der Roboter lernte, ihn auszuführen.
Dieses Verfahren, Lernen aus menschlichen Präferenzen, wurde wenige Jahre später zur Grundlage des Präferenz-Finetunings, mit dem Sprachmodelle zu hilfreichen Assistenten werden.
Zusammenarbeit
Russells Assistenzspiel geht einen Schritt weiter: Mensch und Maschine arbeiten zusammen, der Mensch kennt das Ziel, die Maschine nicht. Daraus folgt, dass es für den Menschen sinnvoll ist, das Ziel bewusst lehrreich vorzuführen, statt nur selbst möglichst gut zu handeln, und für die Maschine, nachzufragen, wenn sie unsicher ist.
Unsicherheit
Das neunte Kapitel behandelt, was ein System tun soll, wenn es nicht weiß, ob es richtig liegt.
| Thema | Kernidee |
|---|---|
| Eigene Unsicherheit erkennen | Netze sind oft auch bei völlig fremden Eingaben sehr selbstsicher; Ensembles und Dropout bei der Vorhersage helfen, Unsicherheit zu schätzen |
| Nebenwirkungen begrenzen | einen Agenten bestrafen, wenn er die Welt stärker verändert als nötig, besonders irreversibel |
| Korrigierbarkeit | ein System, das sich stoppen und korrigieren lässt, statt sich dagegen zu wehren; Russells Argument zum Abschalten aus formaler Sicht |
| Moralische Unsicherheit | auch Menschen sind sich über Werte uneins; Systeme sollten das berücksichtigen |
Einordnung
Die Nachahmung ist das, was beim Vortraining von Sprachmodellen geschieht: Sie lernen, menschliche Texte fortzusetzen, mit allen Stärken und Schwächen der Vorlage. Das Lernen aus Vergleichen ist der zweite Schritt, den Raschka und Huyen als Präferenz-Finetuning beschreiben. Und die Nebenwirkungen sind ein praktisches Thema für jeden Agenten mit Werkzeugen: Huyens Rat, irreversible Aktionen nur nach Freigabe auszuführen, ist eine einfache Form genau dieser Idee.
Was seit 2020 geschah
Das Buch erschien kurz bevor Alignment vom Forschungsthema zur alltäglichen Ingenieuraufgabe wurde. Vieles, was Christian als Forschung beschreibt, ist heute Praxis.
| Thema im Buch | Entwicklung seitdem |
|---|---|
| Lernen aus menschlichen Vergleichen | wurde zur Standardtechnik, um aus Sprachmodellen Assistenten zu machen; dazu kamen einfachere Verfahren, die ohne separates Bewertungsmodell auskommen |
| Belohnungen werden ausgenutzt | zeigt sich bei Sprachmodellen etwa als übertriebene Zustimmung oder als Antworten, die Bewertern gefallen, aber nicht stimmen |
| Transparenz | die Forschung zur Interpretierbarkeit untersucht inzwischen, welche Konzepte im Inneren großer Sprachmodelle dargestellt werden |
| Ziele aus Verhalten erschließen | ergänzt durch Verfahren, bei denen Modelle anhand schriftlich formulierter Grundsätze trainiert und bewertet werden |
| Unsicherheit, Nebenwirkungen | zentral für Agenten mit Werkzeugen: Freigaben, begrenzte Rechte, Rücknahme |
| Fairness, Transparenz als Anforderung | Eingang in Regulierung, etwa die europäische KI-Verordnung, deren Pflichten seit 2025 stufenweise gelten |
Neue Fragen
Mit fähigeren Modellen sind Fragen hinzugekommen, die im Buch nur angedeutet sind: Wie prüft man, ob ein Modell gefährliche Fähigkeiten hat? Wie bewertet man Systeme, deren Ausgaben Menschen selbst nicht mehr leicht prüfen können? Wie stellt man sicher, dass ein Modell in der Prüfung nicht anders handelt als im Einsatz? Diese Fragen werden heute in Forschung, Unternehmen und Politik intensiv und kontrovers diskutiert; internationale Berichte, etwa unter Leitung von Yoshua Bengio, versuchen, den Stand des Wissens zusammenzufassen.
Einordnung
Das Buch hat sich als bemerkenswert vorausschauend erwiesen. Die Techniken, die es als vielversprechende Forschung beschreibt, sind heute in jedem großen Sprachmodell enthalten, und die Probleme, vor denen es warnt, sind in abgewandelter Form aufgetreten. Wer verstehen will, warum Sprachmodelle sich so verhalten, wie sie es tun, findet hier die Vorgeschichte.
Kritik und Einordnung
Stärken
- Erzählkunst: Christian macht abstrakte Probleme an Menschen und Geschichten greifbar. Das Buch liest sich wie ein gut recherchiertes Sachbuch, nicht wie ein Lehrbuch.
- Brücke zwischen den Lagern: Es verbindet die Fragen nach Fairness und Diskriminierung heutiger Systeme mit den Fragen nach Sicherheit künftiger Systeme, zwei Gemeinschaften, die oft getrennt diskutieren.
- Interdisziplinär: Psychologie, Neurowissenschaft und Philosophie werden ernsthaft einbezogen, nicht als Dekoration.
- Sorgfalt: über 100 Seiten Anmerkungen und Quellen.
- Weitsicht: Die beschriebenen Forschungsrichtungen haben sich als zentral erwiesen.
Kritikpunkte
1. Wenig Handlungsanleitung. Das Buch beschreibt Probleme und Forschung, gibt aber kaum konkrete Ratschläge für Entwickler.
2. Vor den Sprachmodellen. Die Beispiele stammen aus Bilderkennung, Strafjustiz, Spielen und Robotik. Wie sich Alignment bei großen Sprachmodellen zeigt, musste es offenlassen.
3. Optimismus der Forschung. Manche Leser finden, das Buch zeige vor allem Fortschritte und unterschätze, wie weit die Lösungen von den Problemen entfernt sind. Andere halten es im Gegenteil für zu besorgt. Christian selbst nimmt eine vermittelnde Haltung ein.
4. Breite statt Tiefe. Jedes Kapitel könnte ein eigenes Buch sein; technisch Interessierte müssen den Anmerkungen folgen.
Gesamturteil
Das beste Buch, um zu verstehen, warum es so schwer ist, lernende Systeme dazu zu bringen, das Richtige zu tun. Für Architekten ist es kein Werkzeugbuch, sondern eine Schärfung des Blicks: Kennzahlen, Belohnungen und Trainingsdaten sind nie neutral, und jedes System, das optimiert, findet Wege, die niemand vorhergesehen hat.
Bezüge zur Reihe
| Thema bei Christian | Bezug in der Reihe |
|---|---|
| Verzerrte Trainingsdaten | Huyen: Stichproben, Auswertung nach Teilgruppen; Géron: repräsentative Testdaten |
| Verzerrung in Embeddings | Alammar und Grootendorst, Huyen: Embeddings für Suche und Klassifikation |
| Unvereinbare Fairness-Definitionen | Géron: Präzision und Trefferquote; Russell und Norvig: Grundraten |
| Was gemessen wird, Festnahmen statt Straftaten | Huyen: Herkunft von Beschriftungen |
| Asthma-Beispiel | Huyen: Lecks aus der Entstehung der Daten |
| Verständliche Modelle, Steckbriefe | Huyen: Model Cards; Richards und Ford: Architekturmerkmale |
| Vorhersagefehler, Dopamin | Prince, Géron: Reinforcement Learning |
| Belohnungen werden ausgenutzt | Accelerate: Metriken als Ziel; Hohpe: Systeme optimieren, was man misst |
| Neugier | Huyen: Erkunden und Ausnutzen bei Banditen |
| Nachahmung, eigene Fehler korrigieren | Raschka: Vortraining; Huyen: Verteilungsverschiebung |
| Lernen aus Vergleichen | Raschka, Huyen: Präferenz-Finetuning |
| Assistenzspiel, Korrigierbarkeit | Russell und Norvig: nützliche Maschinen |
| Nebenwirkungen begrenzen | Huyen: Freigaben für irreversible Aktionen; Nygard: Schutz vor Kaskaden |
| Verantwortung der Entwickler | Prince: Ethik; Martin: Clean Coder |
Diskussionsfragen
- Kennzahlen: Welche Kennzahl in deinem Umfeld wird optimiert und dabei ausgenutzt, ob von Menschen oder von Systemen?
- Fairness: Gibt es bei euch Entscheidungen über Menschen, etwa Kredite, Tarife oder Bewerbungen, für die man festlegen müsste, welche Art von Fairness gilt? Wer entscheidet das?
- Was gemessen wird: Wo messen eure Daten etwas anderes als das, was ihr eigentlich vorhersagen wollt?
- Asthma bei euch: Gibt es Zusammenhänge in euren Daten, die nur durch bisherige Entscheidungen entstanden sind?
- Nachvollziehbarkeit: Für welche eurer Systeme würdet ihr ein verständliches Modell einem genaueren, aber undurchsichtigen vorziehen?
- Agenten: Welche Aktionen eurer KI-Agenten sind irreversibel, und wie werden sie abgesichert?
- Zustimmung: Hast du erlebt, dass ein KI-Werkzeug dir zu bereitwillig zugestimmt hat? Wie gehst du damit um?
- Weiter: Als letztes Buch der KI-Reihe Mitchell, Artificial Intelligence: A Guide for Thinking Humans, eine nüchterne Bestandsaufnahme, was KI kann und was nicht.