Spring AI in Action – Zusammenfassung und Einordnung
Craig Walls, Spring AI in Action (2025)
Einleitung
Die KI-Reihe hat bisher erklärt, wie Sprachmodelle funktionieren, wie man Anwendungen damit entwirft und betreibt und wo ihre Grenzen liegen. Spring AI in Action beantwortet die Frage, die für Java-Entwickler am Ende übrig bleibt: Wie baue ich das konkret in meine Spring-Anwendung ein, ohne Python?
Autor und Kontext
Craig Walls gehört zum Spring-Entwicklungsteam und ist Autor von Spring in Action, dem meistverkauften Buch über das Spring Framework. Das Buch erschien Ende 2025 bei Manning mit einem Vorwort von Rod Johnson, dem Begründer von Spring. Der Beispielcode liegt auf GitHub. Es bezieht sich auf Spring AI 1.x; was sich mit Spring AI 2 geändert hat, ordnet der Abschnitt Kritik am Ende ein.
Die Kernthese
KI-Funktionen sind für Java-Anwendungen keine Sonderwelt. Mit Spring AI fügt man sie mit denselben Mitteln hinzu wie alles andere in Spring: Abhängigkeit eintragen, Eigenschaften konfigurieren, eine Bean einspeisen, Code schreiben, testen. Das Modell wird zu einem weiteren Dienst, den man über eine einheitliche Schnittstelle anspricht, unabhängig vom Anbieter.
Aufbau
| Kapitel | Thema |
|---|---|
| 1 | Einstieg in Spring AI |
| 2 | Generierte Antworten bewerten |
| 3 | Prompts für die Generierung |
| 4 | Mit Dokumenten sprechen: RAG |
| 5 | Gesprächsgedächtnis |
| 6 | Werkzeuggestützte Generierung |
| 7 | Model Context Protocol |
| 8 | Sprache und Bilder |
| 9 | KI-Betrieb beobachten |
| 10 | Generative KI absichern |
| 11 | Muster für generative KI |
| 12 | Agenten |
Rund 320 Seiten, durchgehend Java mit Spring Boot. Bemerkenswert ist die Reihenfolge: Das Testen kommt schon im zweiten Kapitel, noch vor RAG und Werkzeugen.
Erste Schritte und Prompts
Einstieg
Das erste Kapitel beginnt mit einem „Hello AI World“: Projekt anlegen, den Starter für einen Modellanbieter eintragen, etwa OpenAI oder Ollama für lokale Modelle, den API-Schlüssel konfigurieren und einen ChatClient einspeisen. Der ChatClient ist die zentrale Schnittstelle von Spring AI, eine fließende API im Stil von WebClient und RestClient. Darunter liegt das ChatModel, das die Verbindung zu einem bestimmten Anbieter herstellt; der Wechsel des Anbieters ist meist eine Frage der Abhängigkeit und der Konfiguration.
Schon im ersten Kapitel zeigt Walls einen Test, der die Antwort des Anbieters mit WireMock simuliert; das Testen zieht sich durch das ganze Buch.
Prompts gestalten
| Mittel | Zweck |
|---|---|
| System- und Benutzernachricht | Rolle und Regeln getrennt von der eigentlichen Anfrage |
| Prompt-Vorlagen | Platzhalter, die zur Laufzeit gefüllt werden; Vorlagen als Dateien in den Ressourcen statt als Zeichenketten im Code |
| Strukturierte Ausgabe | die Antwort direkt in ein Java-Objekt umwandeln lassen |
| Streaming | Antworten Stück für Stück ausgeben, sobald sie entstehen |
| Modelloptionen | Temperatur, maximale Länge, Modellwahl pro Anfrage |
// Ein Dienst, der eine Schadensmeldung strukturiert auswertet
record ClaimAssessment(String category, BigDecimal estimatedAmount, boolean needsExpert, String reasoning) {}

@Service
class ClaimTriage {
    private final ChatClient chat;

    @Value("classpath:/prompts/claim-triage.st")
    private Resource systemPrompt;                       // Vorlage als Datei, nicht im Code

    ClaimTriage(ChatClient.Builder builder) { this.chat = builder.build(); }

    ClaimAssessment assess(String report) {
        return chat.prompt()
            .system(s -> s.text(systemPrompt).param("currency", "EUR"))
            .user(report)
            .options(ChatOptions.builder().temperature(0.0).build())   // möglichst gleichbleibende Antworten
            .call()
            .entity(ClaimAssessment.class);                // strukturierte Ausgabe als Record
    }
}
Einordnung
Die strukturierte Ausgabe ist der Brückenkopf zwischen Sprachmodell und typisiertem Java-Code: Ein Record mit klaren Feldern ist das Domänenprimitiv-Denken aus Secure by Design, angewandt auf Modellantworten. Prompt-Vorlagen als Ressourcen sind Huyens Rat, Prompts zu versionieren wie Code. Die Temperatur auf null zu setzen, macht Antworten gleichbleibender, aber nicht vollständig deterministisch; Raschka erklärt, warum.
Antworten testen und bewerten
Das zweite Kapitel behandelt ein Problem, das jeder kennt, der KI-Funktionen testen will: Ein Sprachmodell antwortet bei gleicher Frage unterschiedlich, deshalb funktioniert assertEquals nicht. Ein Test mit simulierter Antwort prüft zwar den eigenen Code, aber nicht, ob das Modell sinnvoll antwortet.
Evaluatoren
Spring AI bietet Evaluatoren: Sie erhalten die Frage, die Antwort und gegebenenfalls den Kontext und entscheiden, ob die Antwort akzeptabel ist. Meist nutzen sie dafür selbst ein Sprachmodell als Richter.
| Evaluator | Frage |
|---|---|
| Relevanz | Geht die Antwort auf die Frage ein? |
| Faktentreue | Stimmt die Antwort mit dem gegebenen Kontext überein? |
| Eigene Evaluatoren | für Kriterien, die die mitgelieferten nicht abdecken |
// Integrationstest mit einem Evaluator als Richter
@SpringBootTest
class PolicyAssistantTest {
    @Autowired PolicyAssistant assistant;
    @Autowired ChatClient.Builder judgeBuilder;

    @Test
    void answerIsRelevantToTheQuestion() {
        String question = "Ist ein Wasserschaden durch eine geplatzte Leitung versichert?";
        String answer = assistant.answer(question);

        var evaluator = new RelevancyEvaluator(judgeBuilder);
        var result = evaluator.evaluate(new EvaluationRequest(question, List.of(), answer));

        assertThat(result.isPass())
            .withFailMessage("Nicht relevant: %s", answer)
            .isTrue();
    }
}
Bewertung zur Laufzeit
Walls zeigt auch, wie man Evaluatoren im laufenden Betrieb einsetzt: Ist eine Antwort nicht relevant, wird sie verworfen und neu angefragt. Er weist auf den Preis hin: Jede Wiederholung ist ein weiterer Modellaufruf mit Kosten und Wartezeit.
Einordnung
Das ist Huyens „KI als Richter“ als Teil der Testsuite, und dieselbe Methode, mit der Raschka sein feinabgestimmtes Modell bewertet. Für Architekten wichtig: Solche Tests sind langsamer, kosten Geld und sind selbst nicht vollständig zuverlässig. Sie gehören deshalb eher in eine eigene Testphase als in jeden Build; Winters u.a. würden sie als große Tests einordnen. Gut kombinieren lassen sie sich mit Mitchells Brüchigkeitstest: dieselbe Frage in mehreren Varianten stellen und prüfen, ob alle Antworten relevant und konsistent sind.
Dokumente und Gedächtnis
Zwei Kapitel behandeln, wie man Anfragen mit Kontext anreichert. Beide nutzen dasselbe Konzept, das Spring AI auszeichnet: Advisors.
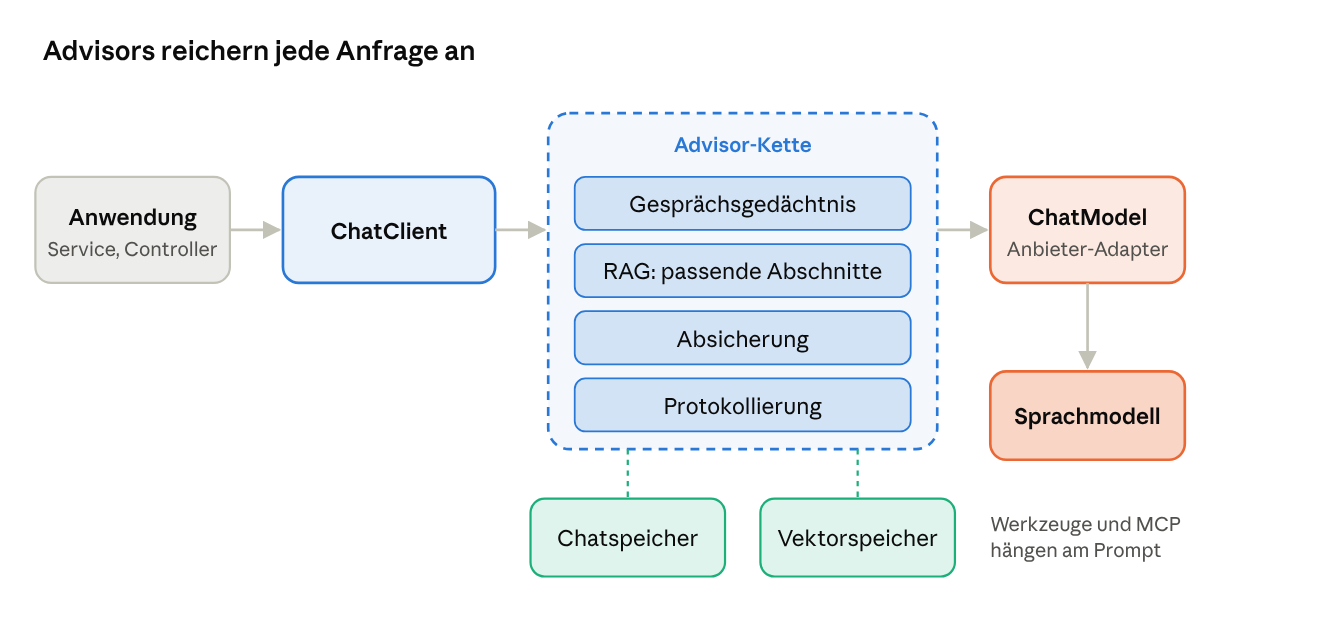
der Weg einer Anfrage durch Spring AI, vereinfacht
Advisors
Ein Advisor ist ein Baustein, der sich zwischen den ChatClient und das Modell schaltet: Er kann die Anfrage vor dem Absenden verändern und die Antwort danach auswerten. Mehrere Advisors bilden eine Kette. So lassen sich Gedächtnis, RAG, Protokollierung oder Sicherheitsprüfungen unabhängig voneinander hinzufügen, ohne den Anwendungscode zu ändern.
Mit Dokumenten sprechen
Das vierte Kapitel zeigt RAG in zwei Schritten:
| Schritt | Spring-AI-Bausteine |
|---|---|
| Laden | Dokumentleser für PDF, Text, Markdown und mehr; Zerlegung in Abschnitte; Einbettung mit einem Embedding-Modell; Speicherung in einem Vektorspeicher, etwa PGVector, Redis oder Neo4j |
| Abfragen | ein RAG-Advisor sucht zu jeder Frage passende Abschnitte im Vektorspeicher und hängt sie an den Prompt |
Das Laden folgt dem bekannten Muster Extrahieren, Transformieren, Laden, nur dass am Ende Vektoren statt Tabellenzeilen stehen.
Gesprächsgedächtnis
Sprachmodelle erinnern sich nicht an frühere Nachrichten. Das fünfte Kapitel zeigt, wie ein Gedächtnis-Advisor die letzten Nachrichten eines Gesprächs aus einem Speicher lädt und mitschickt. Spring AI begrenzt das standardmäßig auf ein Fenster der letzten Nachrichten und kann sie in einer Datenbank ablegen, damit Gespräche einen Neustart überstehen. Jedes Gespräch erhält eine eigene Kennung, damit sich Benutzer nicht gegenseitig sehen.
Einordnung
Advisors sind das Decorator- oder Chain-of-Responsibility-Muster der Gang of Four, ähnlich wie Servlet-Filter oder Spring-Interceptoren. Das macht sie für Java-Entwickler sofort vertraut. RAG und Gedächtnis entsprechen den Kapiteln, die Huyen sowie Alammar und Grootendorst ausführlicher behandeln; das Gedächtnisfenster ist die einfachste der Varianten, die Alammar und Grootendorst vergleichen. Wichtig für die Architektur: Die Gesprächskennung ist eine Sicherheitsgrenze, wie Secure by Design sie fordert.
Werkzeuge und MCP
Werkzeuggestützte Generierung
Ein Sprachmodell kennt weder den aktuellen Stand einer Police noch das heutige Datum. Mit Werkzeugen kann es solche Informationen anfordern oder Aktionen auslösen. In Spring AI ist ein Werkzeug eine gewöhnliche Java-Methode mit einer Annotation und einer Beschreibung. Das Modell entscheidet anhand der Beschreibung, ob und mit welchen Parametern es das Werkzeug aufruft; Spring AI führt den Aufruf aus und schickt das Ergebnis zurück an das Modell.
// Werkzeuge als annotierte Methoden; die Beschreibungen sind Teil des Prompts
@Component
class PolicyTools {
    private final PolicyRepository policies;
    PolicyTools(PolicyRepository policies) { this.policies = policies; }

    @Tool(description = "Liefert Status, Deckungsumfang und Selbstbeteiligung einer Police anhand ihrer Policennummer.")
    PolicySummary findPolicy(@ToolParam(description = "Policennummer im Format XX-12345678") String number) {
        return policies.find(new PolicyNumber(number))     // Domänenprimitiv prüft das Format
            .map(PolicySummary::from)
            .orElseThrow(() -> new PolicyNotFoundException(number));
    }
}

// Verwendung: nur lesende Werkzeuge, ausdrücklich pro Anfrage freigegeben
String answer = chat.prompt()
    .user("Bin ich bei Police KA-10293847 gegen Glasbruch versichert?")
    .tools(policyTools)
    .call()
    .content();
Walls betont, dass die Beschreibung entscheidend ist: Sie ist das Einzige, was das Modell über das Werkzeug weiß. Unklare Beschreibungen führen zu falschen oder fehlenden Aufrufen.
Model Context Protocol
Das siebte Kapitel stellt das Model Context Protocol vor, einen offenen Standard, um Werkzeuge, Ressourcen und Prompts zwischen Anwendungen zu teilen. Statt Werkzeuge in jede Anwendung einzeln einzubauen, bietet ein MCP-Server sie an, und beliebige MCP-Clients, etwa eine Spring-Anwendung oder ein Assistent auf dem Desktop, nutzen sie.
| Rolle | In Spring AI |
|---|---|
| MCP-Server | ein Starter, der annotierte Werkzeugmethoden über das Protokoll anbietet |
| MCP-Client | ein Starter, der sich mit Servern verbindet und deren Werkzeuge dem ChatClient zur Verfügung stellt |
| Transport | lokal über Standardein- und -ausgabe oder über HTTP |
Einordnung
Werkzeuge sind der Schritt vom Antworten zum Handeln, und damit der Übergang zu Agenten. Für Architekten ergeben sich sofort die Fragen, die Huyen und Secure by Design stellen: Welche Werkzeuge darf das Modell aufrufen? Mit welchen Rechten? Was passiert bei einem schreibenden Aufruf mit falschen Parametern? MCP ist aus Architektursicht eine veröffentlichte Sprache im Sinne von Evans und Vernon: ein standardisierter Vertrag zwischen Werkzeuganbietern und Modellanwendungen.
Sprache und Bilder
Das achte Kapitel erweitert die Anwendungen über Text hinaus. Spring AI bietet dafür eigene Modellschnittstellen, die nach demselben Prinzip funktionieren wie das ChatModel:
| Richtung | Schnittstelle | Beispiel |
|---|---|---|
| Sprache zu Text | Transkriptionsmodell | eine telefonische Schadensmeldung in Text umwandeln |
| Text zu Sprache | Sprachausgabe | eine Antwort vorlesen, etwa für einen Sprachassistenten |
| Bild zu Text | Chat mit angehängten Medien | ein Schadensfoto beschreiben oder Daten aus einem gescannten Formular lesen |
| Text zu Bild | Bildmodell | eine Illustration aus einer Beschreibung erzeugen |
Bilder als Eingabe werden einfach als Medien an die Benutzernachricht angehängt, sofern das Modell das unterstützt. Damit lassen sich die multimodalen Fähigkeiten, die Alammar und Grootendorst beschreiben, mit wenigen Zeilen in eine bestehende Spring-Anwendung einbauen.
Einordnung
Für Geschäftsanwendungen ist besonders die Kombination interessant: Ein Foto wird beschrieben, die Beschreibung strukturiert ausgewertet, das Ergebnis mit einem Werkzeug gegen die Police geprüft. Jeder Schritt bringt aber eigene Fehlerquellen, und Mitchells Warnung vor Brüchigkeit gilt für Bilder noch stärker als für Text. Datenschutzfragen sind bei Sprachaufnahmen und Fotos von Personen besonders heikel; das gehört in die Architekturentscheidung, nicht erst in die Umsetzung.
Beobachten
Das neunte Kapitel zeigt, wie man sieht, was eine KI-Anwendung im Betrieb tut. Spring AI ist an Micrometer angebunden, das Beobachtungssystem von Spring Boot, und liefert damit ohne eigenen Code:
| Signal | Beispiel |
|---|---|
| Metriken | Dauer der Modellaufrufe, verbrauchte Tokens für Eingabe und Ausgabe, Fehlerraten |
| Traces | jeder Modellaufruf, jede Vektorsuche und jeder Werkzeugaufruf als eigener Abschnitt in einem verteilten Trace |
| Protokolle | auf Wunsch Prompts und Antworten, etwa über einen Protokoll-Advisor |
Die Token-Metriken sind besonders wichtig, weil sie direkt die Kosten bestimmen. Walls weist darauf hin, dass das Mitprotokollieren von Prompts und Antworten sensible Daten in Logs bringen kann und deshalb bewusst eingeschaltet werden sollte.
Absichern
Das zehnte Kapitel behandelt Schutzmaßnahmen für generative KI. Die Themen reichen von einfachen Filtern bis zu grundsätzlichen Fragen:
| Risiko | Maßnahme |
|---|---|
| Unerwünschte Inhalte in Anfragen oder Antworten | Advisors, die bestimmte Inhalte erkennen und die Anfrage blockieren; Moderationsmodelle |
| Manipulierte Anweisungen in Eingaben oder Dokumenten | Eingaben und abgerufene Inhalte als Daten behandeln, Werkzeuge begrenzen, Ausgaben prüfen |
| Zugriff auf fremde Daten | Gesprächs- und Benutzertrennung, Absicherung der Endpunkte mit Spring Security |
| Folgenreiche Aktionen | schreibende Werkzeuge nur mit Bestätigung, klare Berechtigungen |
Einordnung
Beobachtbarkeit ist die Umsetzung dessen, was Huyen für den Betrieb fordert und was das SRE-Buch allgemein beschreibt; dass sie über Micrometer kommt, bedeutet, dass sie in bestehende Dashboards und Alarme passt. Die Schutzmaßnahmen decken ab, was Secure by Design nicht behandeln konnte: Angriffe über Sprache selbst. Ein Filter für Schlüsselwörter ist dabei nur eine erste Linie; wie Goodfellow u.a. bei adversariellen Beispielen zeigen, lassen sich solche Filter umgehen. Die wirksamste Absicherung bleibt, die Wirkung zu begrenzen: wenige, eng gefasste Werkzeuge mit minimalen Rechten.
Muster für generative KI
Das elfte Kapitel zeigt, dass der ChatClient weit mehr kann als Fragen beantworten. Die Aufgabe wird im Wesentlichen durch den Prompt bestimmt:
| Muster | Beispiel |
|---|---|
| Zusammenfassen | lange Schadensberichte auf das Wesentliche kürzen |
| Klassifizieren | eingehende E-Mails einer Abteilung zuordnen |
| Extrahieren | strukturierte Daten aus Freitext gewinnen |
| Übersetzen und Umformulieren | Fachsprache in verständliche Kundensprache übertragen |
| Vorschlagen | Antwortentwürfe, Suchbegriffe, nächste Schritte |
Agenten
Das letzte Kapitel gibt einen Einblick in Agenten mit Spring AI. Walls unterscheidet, wie in der Fachdiskussion üblich, zwischen Workflows, in denen der Entwickler den Ablauf festlegt und das Modell einzelne Schritte übernimmt, und Agenten, die selbst entscheiden, welche Schritte und Werkzeuge sie in welcher Reihenfolge nutzen. Die folgende Übersicht zeigt die gängigen Workflow-Muster, wie sie auch die Spring-AI-Dokumentation beschreibt; das Kapitel greift sie als Einstieg auf.
| Workflow-Muster | Ablauf |
|---|---|
| Kette | mehrere Modellaufrufe hintereinander, jeder verarbeitet das Ergebnis des vorigen |
| Weiterleitung | ein erster Aufruf klassifiziert die Anfrage, danach übernimmt ein spezialisierter Prompt |
| Parallelisierung | mehrere Aufrufe gleichzeitig, Ergebnisse werden zusammengeführt |
| Koordinator und Arbeiter | ein Aufruf zerlegt die Aufgabe, weitere bearbeiten die Teile |
| Bewerten und verbessern | ein Aufruf erzeugt, ein zweiter bewertet, bis das Ergebnis genügt |
// Weiterleitung: erst klassifizieren, dann mit spezialisiertem Prompt antworten
enum Topic { CLAIM, CONTRACT, BILLING, OTHER }

@Service
class SupportRouter {
    private final ChatClient chat;
    private final Map<Topic, Resource> prompts;     // je Thema eine Prompt-Vorlage

    SupportRouter(ChatClient.Builder builder, Map<Topic, Resource> prompts) {
        this.chat = builder.build();
        this.prompts = prompts;
    }

    String answer(String request) {
        Topic topic = chat.prompt()
            .user(u -> u.text("Ordne die Anfrage einem Thema zu: {request}").param("request", request))
            .call()
            .entity(Topic.class);                     // strukturierte Ausgabe als Enum

        return chat.prompt()
            .system(prompts.getOrDefault(topic, prompts.get(Topic.OTHER)))
            .user(request)
            .call()
            .content();
    }
}
Einordnung
Die Workflow-Muster sind Hohpes und Woolfs Integrationsmuster mit einem Sprachmodell als Verarbeitungsschritt: Weiterleitung ist ein Content-Based Router, Parallelisierung ein Scatter-Gather, Koordinator und Arbeiter ein Splitter mit Aggregator. Für Java-Architekten ist das beruhigend: Die Struktur ist vertraut, nur der Inhalt einzelner Schritte ist neu. Den Rat, wann immer möglich einen Workflow statt eines freien Agenten zu bauen, teilt Walls mit Huyen und Albada.
Kritik und Einordnung
Stärken
- Java von Anfang bis Ende: Kein Umweg über Python; alles fügt sich in bekannte Spring-Konzepte ein.
- Von einem Insider: Walls gehört zum Spring-Team und erklärt nicht nur das Wie, sondern auch die Absicht hinter den Schnittstellen.
- Testen früh und ernst genommen: Evaluatoren im zweiten Kapitel setzen ein wichtiges Zeichen.
- Betriebsthemen: Beobachtbarkeit und Absicherung bekommen eigene Kapitel.
- Praktisch und kompakt: 320 Seiten mit lauffähigen Beispielen auf GitHub.
Kritikpunkte
1. Wenig Hintergrund. Warum RAG funktioniert, wann Embeddings scheitern oder wie man Prompts systematisch bewertet, erklärt das Buch kaum; dafür braucht man Huyen sowie Alammar und Grootendorst.
2. Agenten nur angerissen. Das letzte Kapitel ist ein Einstieg, keine Anleitung für produktive Agentensysteme; dafür ist Albada die Ergänzung.
3. Schnelle Alterung. Ein Buch über ein junges Framework veraltet schneller als eines über Prinzipien. Es bezieht sich auf Spring AI 1.x.
4. Wenig Architektur. Wo die KI-Funktion im System sitzt, wie man sie von der Domäne trennt oder wie man Kosten über viele Anwendungen steuert, bleibt offen.
Stand von Spring AI 2
Spring AI 2 gehört zur Generation von Spring Boot 4, setzt Java 21 voraus und erschien 2026 zunächst als Release Candidate. Die Grundkonzepte des Buchs, ChatClient, Advisors, Werkzeuge, Vektorspeicher, Evaluatoren und MCP, gelten weiter; einzelne Klassennamen, Konfigurationseigenschaften und Starter haben sich geändert. Wer mit dem Buch arbeitet, sollte die Beispiele mit der aktuellen Referenzdokumentation abgleichen.
Gesamturteil
Das Buch, das die KI-Reihe für Java-Entwickler praktisch macht. Es ersetzt keines der anderen KI-Bücher, sondern übersetzt ihre Ideen in Spring-Code. Am wertvollsten ist es in Kombination mit AI Engineering: Huyen sagt, worauf es ankommt, Walls zeigt, wie man es in Java umsetzt.
Bezüge zur Reihe
| Thema bei Walls | Bezug in der Reihe |
|---|---|
ChatClient als einheitliche Schnittstelle | Martin: Abhängigkeitsumkehr; Vernon: hexagonale Architektur |
| Strukturierte Ausgabe in Records | Secure by Design: Domänenprimitive; Weidig: Records |
| Prompt-Vorlagen als Ressourcen | Huyen: Prompts versionieren; Winters u.a.: alles in die Versionskontrolle |
| Evaluatoren als Richter | Huyen: KI als Richter; Raschka: Bewertung mit einem größeren Modell |
| Evaluator-Tests als große Tests | Winters u.a.: Testgrößen; Khorikov: Kosten und Nutzen von Tests |
| RAG mit Vektorspeicher | Huyen: RAG; Alammar und Grootendorst: semantische Suche |
| Gesprächsgedächtnis als Fenster | Alammar und Grootendorst: Gedächtnisvarianten |
| Advisors als Kette | Gang of Four: Decorator, Chain of Responsibility |
| Werkzeuge mit Beschreibungen | Huyen, Albada: Werkzeugentwurf; Russell und Norvig: Aktoren eines Agenten |
| MCP als Standard | Evans, Vernon: veröffentlichte Sprache; Hohpe und Woolf: kanonisches Datenmodell |
| Micrometer, Token-Metriken | SRE-Buch: Monitoring; Huyen: Kosten im Betrieb |
| Absichern, Wirkung begrenzen | Secure by Design; Christian: Nebenwirkungen; Huyen: Freigaben |
| Workflow-Muster | Hohpe und Woolf: Router, Scatter-Gather, Aggregator |
| Workflows vor Agenten | Huyen: Agenten mit Augenmaß; Albada: Workflows und Agenten |
Diskussionsfragen
- Einstieg: Gibt es bei euch eine Spring-Anwendung, in der ein erster, risikoarmer KI-Anwendungsfall sinnvoll wäre, etwa Zusammenfassen oder Klassifizieren?
- Testen: Wie würdet ihr Evaluator-Tests in eure Pipeline einbauen, ohne jeden Build zu verlangsamen und zu verteuern?
- Strukturierte Ausgabe: Welche eurer Anwendungsfälle ließen sich mit einem Record als Ergebnis sauber in bestehende Logik einbinden?
- Werkzeuge: Welche lesenden Werkzeuge könntet ihr bedenkenlos freigeben? Welche schreibenden nur mit Bestätigung?
- MCP: Lohnt es sich, interne Fachfunktionen als MCP-Server anzubieten, damit mehrere KI-Anwendungen sie nutzen können?
- Kosten: Habt ihr Dashboards für Token-Verbrauch und Modell-Latenz? Wer schaut darauf?
- Anbieterwechsel: Wie wichtig ist euch, das Modell wechseln zu können, etwa auf ein lokales Modell, und wie testet ihr das?
- Weiter: Als Nächstes Albada, Building Applications with AI Agents, für den Schritt vom Workflow zum Agentensystem.