Software Engineering at Google – Zusammenfassung und Einordnung
Titus Winters, Tom Manshreck, Hyrum Wright, Software Engineering at Google: Lessons Learned from Programming Over Time (2020)
Einleitung
Die meisten Bücher der Reihe fragen, wie man guten Code, eine gute Architektur oder ein gutes Team baut. Software Engineering at Google stellt eine andere Frage: Was ändert sich, wenn Software lange lebt und viele Menschen daran arbeiten? Die Antworten stammen aus einer Organisation mit Zehntausenden Entwicklern und einer einzigen, riesigen Codebasis, sind aber erstaunlich oft auf kleinere Verhältnisse übertragbar.
Autoren und Kontext
| Autor | Rolle |
|---|---|
| Titus Winters | leitete lange die Bibliotheken der C++-Codebasis bei Google und war in der Normung der C++-Standardbibliothek aktiv |
| Tom Manshreck | technischer Redakteur bei Google, verantwortlich für zentrale Programmierleitfäden |
| Hyrum Wright | Experte für großflächige Wartung der Codebasis; Namensgeber von Hyrums Gesetz |
Das Buch erschien im März 2020 bei O’Reilly und ist weiterhin in der ersten Auflage aktuell. Es ist kostenlos online lesbar. Die meisten Kapitel stammen von verschiedenen Google-Ingenieuren und wurden von den drei Herausgebern zusammengeführt; unter den Kapitelautoren ist auch Brian Fitzpatrick, Mitautor von Debugging Teams.
Die Kernthese
Software Engineering ist Programmieren, über die Zeit integriert.
Programmieren heißt, ein Problem einmal zu lösen. Software Engineering heißt, eine Lösung über Jahre am Leben zu halten, während sich Anforderungen, Abhängigkeiten, Hardware, Menschen und Sprachen ändern. Daraus folgen drei Leitfragen, die das ganze Buch durchziehen: Zeit, Maßstab und Abwägungen.
Aufbau
| Teil | Kapitel | Inhalt |
|---|---|---|
| I. These | 1 | Was ist Software Engineering? |
| II. Kultur | 2–7 | Teamarbeit, Wissensaustausch, Gleichberechtigung, Führung, Führung im großen Maßstab, Produktivität messen |
| III. Prozesse | 8–15 | Stilregeln, Code-Review, Dokumentation, Testen in vier Kapiteln, Abschalten alter Systeme |
| IV. Werkzeuge | 16–25 | Versionskontrolle, Codesuche, Build, Review-Werkzeug, statische Analyse, Abhängigkeiten, große Änderungen, CI, CD, Rechenleistung als Dienst |
Rund 600 Seiten. Die Beispiele stammen überwiegend aus C++ und Java; die Java-Beispiele in dieser Zusammenfassung übertragen die Ideen auf typische Situationen in Java-Projekten.
Zeit, Maßstab, Abwägungen
Zeit
Die erwartete Lebensdauer eines Programms bestimmt, wie man es bauen sollte. Ein Skript, das einmal läuft, braucht keine Tests und keine Upgrade-Strategie. Code, der Jahrzehnte lebt, muss Wechsel von Compilern, Bibliotheken, Betriebssystemen und Teams überstehen. Die Autoren nennen eine Codebasis nachhaltig, wenn man alles, was man ändern sollte, sicher ändern kann, solange sie lebt.
Eine Folge: Upgrades sollten regelmäßig geschehen. Wer nur alle paar Jahre aktualisiert, stößt jedes Mal auf viele versteckte Abhängigkeiten gleichzeitig, und das erste große Upgrade ist das teuerste. Wer es oft tut, macht es zur Routine. Das ist dieselbe Logik wie bei Humble und Farley: Was weh tut, sollte man öfter tun.
Hyrums Gesetz
Die bekannteste Einsicht des Buchs:
Bei genügend vielen Nutzern einer Schnittstelle ist es gleichgültig, was im Vertrag steht: Irgendjemand hängt von jedem beobachtbaren Verhalten ab.
Ein klassisches Beispiel ist die Reihenfolge, in der eine Hashtabelle ihre Einträge liefert. Sie ist nirgends garantiert, aber Code verlässt sich trotzdem darauf.
// Hyrums Gesetz im Kleinen: niemand hat eine Reihenfolge versprochen
Map<String, Integer> limits = new HashMap<>();
limits.put("KASKO", 500);
limits.put("HAFTPFLICHT", 1000);
limits.put("GLAS", 150);

// Ein Bericht übernimmt einfach die Iterationsreihenfolge ...
String report = limits.keySet().stream().collect(Collectors.joining(","));

// ... und ein Test oder ein nachgelagertes System vergleicht den Text exakt.
// Ändert ein JDK-Update die interne Verteilung, „bricht“ der Code,
// obwohl sich der Vertrag von HashMap nie geändert hat.

// Besser: die Reihenfolge, auf die man sich verlässt, ausdrücklich machen
String stable = new TreeMap<>(limits).keySet().stream().collect(Collectors.joining(","));
Für Anbieter von Schnittstellen folgt daraus Bescheidenheit: Jede Änderung kann jemanden treffen, auch wenn sie formal erlaubt ist. Für Nutzer folgt: Verlass dich nur auf das, was zugesagt ist.
Maßstab
Praktiken, die bei zehn Entwicklern funktionieren, scheitern bei zehntausend. Die Autoren fragen deshalb bei jeder Richtlinie: Skaliert sie? Eine Aufgabe, deren Aufwand mit der Größe der Organisation wächst, wird irgendwann untragbar.
| Regel | Inhalt |
|---|---|
| Wer ändert, migriert | Ein Infrastrukturteam, das eine Änderung einführt, übernimmt auch die Umstellung aller Nutzer, statt sie auf hundert Teams zu verteilen; sonst wächst der Aufwand mit jedem neuen Nutzer. |
| Wer sich auf etwas verlässt, testet es | Eine Infrastrukturänderung ist erlaubt, wenn sie keinen automatisierten Test bricht. Wer sich auf ein Verhalten verlässt, muss es also mit einem Test absichern; sonst trägt er selbst die Folgen. |
| Früh finden | Fehler sind billiger, je früher man sie findet: im Editor billiger als im Review, im Review billiger als in Produktion. |
Abwägungen
Jede Entscheidung hat Kosten: Geld, Rechenleistung, Personal, Koordination, Gelegenheiten, gesellschaftliche Folgen. Die Autoren fordern, Entscheidungen mit Daten zu begründen statt mit Autorität, und sie zu überprüfen, wenn sich die Daten ändern. Eine Entscheidung zu revidieren gilt nicht als Schwäche, sondern als Lernen.
Einordnung
„Programmieren über die Zeit“ ist Brooks‘ Unterscheidung von Programm und Programmsystemprodukt mit der Zeit als zusätzlicher Achse. Hyrums Gesetz ist der Grund, warum Bloch in Effective Java rät, Schnittstellen klein zu halten und Implementierungsdetails zu verbergen, und warum Ousterhout tiefe Module mit schmalen Schnittstellen empfiehlt: Was nicht sichtbar ist, kann niemand voraussetzen.
Kultur
Der zweite Teil beginnt nicht mit Technik, sondern mit Menschen. Die Autoren sind überzeugt, dass die meisten Probleme in großen Softwareorganisationen soziale Probleme sind.
Gut im Team arbeiten
Das Kapitel greift die Thesen aus Debugging Teams auf: Der Mythos vom einsamen Genie schadet; wer seine Arbeit versteckt, bis sie „fertig“ ist, entdeckt Fehler zu spät. Ein niedriger Bus-Faktor, also wenige Menschen, ohne die ein Projekt stillsteht, ist ein Risiko. Grundlage guter Zusammenarbeit sind Demut, Respekt und Vertrauen.
Wissen teilen
| Mittel | Zweck |
|---|---|
| Psychologische Sicherheit | Fragen stellen dürfen, ohne sich zu blamieren; die Voraussetzung für alles andere |
| Fragen und Sprechstunden | Wissen von Mensch zu Mensch, schnell und persönlich |
| Vorträge, Kurse, Codelabs | Wissen an viele gleichzeitig |
| Dokumentation | Wissen, das auch ohne den Autor verfügbar bleibt |
| Lesbarkeitsfreigabe | Entwickler werden für eine Sprache zertifiziert; jede Änderung braucht eine Freigabe von jemandem mit dieser Zertifizierung. So verbreiten sich Stil und Idiome über die ganze Organisation. |
Für alle bauen
Das Kapitel über Gleichberechtigung zeigt, wie Produkte Menschen ausschließen oder verletzen, wenn die Entwickler nicht an sie gedacht haben, etwa Bilderkennung, die Menschen mit dunkler Hautfarbe falsch einordnete; dasselbe Beispiel, mit dem Christian The Alignment Problem beginnt. Die Forderung: vielfältige Teams, Tests mit unterschiedlichen Nutzergruppen und die Bereitschaft, Zeitpläne für Gerechtigkeit zu verschieben.
Führen
Die Autoren unterscheiden Manager, die für Menschen verantwortlich sind, technische Leitungen, die für technische Entscheidungen verantwortlich sind, und Mischrollen. Für Führung nennen sie Muster und Gegenmuster:
| Gegenmuster | Muster |
|---|---|
| Bequeme Leute einstellen, die nicht widersprechen | Leute einstellen, die klüger sind als man selbst |
| Schwache Leistung ignorieren | Probleme früh ansprechen, mit klaren Zielen und Zeitrahmen |
| Jedermanns Freund sein | freundlich, aber ehrlich sein, wie bei Scotts Radical Candor |
| Alles selbst machen | Hindernisse beseitigen, Katalysator sein, das Ego zurücknehmen |
Für Führung in großem Maßstab fassen sie die Aufgabe in drei Leitsätzen zusammen: Immer entscheiden, also Abwägungen sichtbar machen und Richtung geben. Immer loslassen, also das Team so aufstellen, dass es ohne einen funktioniert. Immer skalieren, also die eigene Zeit und Energie schützen.
Einordnung
Wer Debugging Teams, Peopleware und The Staff Engineer’s Path gelesen hat, findet hier viel Vertrautes. Neu ist der Blick auf den Maßstab: Die Lesbarkeitsfreigabe ist ein Mechanismus, mit dem eine Organisation Wissen über Tausende Menschen verbreitet, ohne dass jemand alles kennen muss.
Produktivität messen
Das siebte Kapitel beschreibt, wie ein eigenes Forschungsteam bei Google die Produktivität von Entwicklern untersucht, und warum das schwieriger ist, als es klingt.
Erst fragen, ob sich die Messung lohnt
Bevor gemessen wird, stellt das Team Fragen: Welches Ergebnis wird erwartet? Was würde man tun, wenn die Daten es bestätigen oder widerlegen? Ist jemand bereit, auf Grundlage der Daten zu handeln? Wenn eine Entscheidung ohnehin feststeht, ist die Messung Verschwendung.
Ziele, Signale, Kennzahlen
Das Team arbeitet mit einem dreistufigen Rahmen:
| Stufe | Frage | Beispiel: Wirkt ein neues Review-Werkzeug? |
|---|---|---|
| Ziel | Was wollen wir erreichen? | Entwickler verbringen weniger Zeit mit Warten auf Reviews |
| Signal | Woran würden wir erkennen, dass wir es erreicht haben? | Reviews werden schneller abgeschlossen, ohne dass die Qualität sinkt |
| Kennzahl | Was können wir tatsächlich messen? | Zeit bis zur ersten Antwort, Zeit bis zur Freigabe, Zahl späterer Fehler, Zufriedenheit laut Umfrage |
Wichtig ist die Reihenfolge: zuerst Ziele, dann Signale, erst zuletzt Kennzahlen. Wer mit den verfügbaren Kennzahlen beginnt, misst das Falsche.
Mehrere Dimensionen
Produktivität hat mehrere Seiten, die man gemeinsam betrachten muss, damit man nicht eine auf Kosten der anderen verbessert: Qualität des Codes, Aufmerksamkeit und Konzentration, intellektuelle Komplexität, Tempo und Geschwindigkeit sowie Zufriedenheit. Neben Protokolldaten nutzt das Team Umfragen und Gespräche, weil Zahlen allein nicht erklären, warum etwas so ist.
Einordnung
Das ist die Methodik, die hinter Accelerate stehen könnte, angewandt auf einzelne Werkzeuge und Prozesse statt auf ganze Organisationen. Die mehreren Dimensionen erinnern an Christians Warnung vor ausgenutzten Belohnungen: Wer nur eine Kennzahl optimiert, bekommt sie, aber nicht unbedingt das, was er wollte. Für Architekten, die den Nutzen einer Plattform oder eines Werkzeugs begründen müssen, ist der Rahmen aus Zielen, Signalen und Kennzahlen direkt anwendbar.
Prozesse
Stilregeln
Google hat für jede Sprache verbindliche Stilregeln. Wichtiger als die Regeln selbst sind die Grundsätze, nach denen sie entstehen:
| Grundsatz | Bedeutung |
|---|---|
| Regeln müssen sich lohnen | jede Regel kostet Aufmerksamkeit; sie muss einen klaren Nutzen haben |
| Für den Leser optimieren | Code wird viel öfter gelesen als geschrieben |
| Einheitlich sein | Einheitlichkeit hat einen eigenen Wert, auch wenn eine einzelne Regel diskutabel ist |
| Fehleranfällige Konstrukte meiden | lieber eine einfache Regel als ein cleverer, riskanter Trick |
| Praktisch bleiben | Ausnahmen sind erlaubt, wenn die Regel mehr schadet als nützt |
Wo immer möglich, werden Regeln von Werkzeugen durchgesetzt, etwa durch automatische Formatierung und statische Analyse, damit Menschen im Review nicht darüber streiten müssen.
Code-Review
Jede Änderung bei Google wird geprüft, bevor sie in die Codebasis gelangt. Eine Änderung braucht drei Arten von Zustimmung, die auch eine einzige Person geben kann:
- Korrektheit: Ein anderer Entwickler bestätigt, dass die Änderung tut, was sie soll.
- Zuständigkeit: Ein Verantwortlicher für den betroffenen Teil der Codebasis stimmt zu.
- Lesbarkeit: Jemand mit Lesbarkeitsfreigabe für die Sprache bestätigt Stil und Idiome.
Der Nutzen liegt nicht nur im Finden von Fehlern, sondern ebenso in Verständlichkeit, Einheitlichkeit, Wissensaustausch und dem Gefühl, dass Code dem Team gehört. Als bewährte Praktiken nennen die Autoren: kleine Änderungen, gute Beschreibungen, wenige Prüfer, höflicher Ton und so viel Automatisierung wie möglich.
Dokumentation
Die Autoren fordern, Dokumentation wie Code zu behandeln: in der Versionskontrolle, mit klaren Verantwortlichen, mit Review, mit Tests auf tote Links, und mit einem Ablaufdatum, wenn sie nicht mehr gepflegt wird.
| Art | Zweck |
|---|---|
| Referenz | Kommentare und API-Dokumentation |
| Entwurfsdokumente | Entscheidungen und Alternativen vor der Umsetzung |
| Anleitungen | Schritt für Schritt zum ersten Erfolg |
| Konzeptdokumentation | Zusammenhänge und Hintergründe |
| Einstiegsseiten | Wegweiser zu allem anderen |
Jedes Dokument sollte seinen Leser kennen und eine Aufgabe erfüllen; Mischformen werden schnell unbrauchbar.
Einordnung
Die Grundsätze für Stilregeln sind eine Brücke zwischen Martins und McConnells detaillierten Regeln und Ousterhouts Forderung nach Urteilsvermögen. Das dreifache Review zeigt, wie Feedback skaliert, das bei Becks und Freemans kleinen Schritten persönlich stattfindet. Die Entwurfsdokumente sind Verwandte der Architekturentscheidungen mit eingeholtem Rat, die Harmel-Law beschreibt.
Testen
Vier Kapitel widmen sich dem Testen, und sie gehören zu den besten des Buchs. Google hat Testen nicht von Anfang an ernst genommen; das Buch erzählt, wie eine kleine Gruppe Freiwilliger die Kultur über Jahre veränderte, unter anderem mit Testhinweisen, die in Toiletten aufgehängt wurden.
Größe und Reichweite
Das Buch unterscheidet zwei Dimensionen, die oft vermischt werden:
| Dimension | Frage | Stufen |
|---|---|---|
| Größe | Welche Ressourcen braucht der Test? | klein: ein Prozess, keine Netzwerk- oder Plattenzugriffe; mittel: eine Maschine; groß: mehrere Maschinen |
| Reichweite | Wie viel Code wird geprüft? | schmal: eine Klasse; mittel: einige Komponenten; breit: das ganze System |
Kleine Tests sind schnell und deterministisch; je größer ein Test, desto eher wird er unzuverlässig.
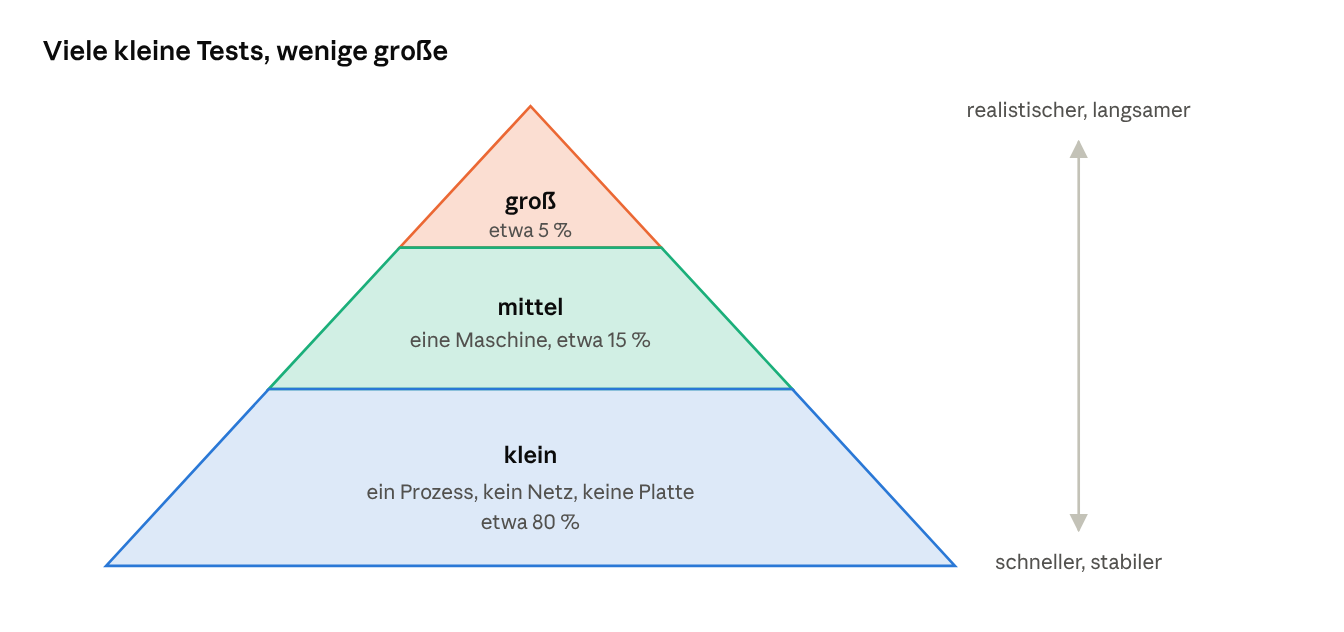
die Verteilung der Testgrößen, die das Buch als Richtwert nennt
Als Gegenbilder nennen die Autoren die Eistüte, viele große und wenige kleine Tests, und die Sanduhr, viele kleine und große, aber kaum mittlere. Beide führen zu langsamen, unzuverlässigen Testläufen.
Gute Unit-Tests
| Regel | Bedeutung |
|---|---|
| Über öffentliche Schnittstellen testen | Tests sollen Änderungen an der Implementierung überstehen |
| Zustand prüfen, nicht Interaktionen | das Ergebnis zählt, nicht welche Methoden in welcher Reihenfolge aufgerufen wurden |
| Verhalten testen, nicht Methoden | ein Test pro Verhalten, nicht pro Methode |
| Lesbarkeit vor Wiederverwendung | in Tests ist etwas Wiederholung besser als undurchsichtige Hilfsfunktionen; jeder Test soll für sich verständlich sein |
| Klare Fehlermeldungen | ein fehlgeschlagener Test soll sagen, was falsch ist |
Testdoubles
Die Autoren haben eine klare Rangfolge: echte Implementierung vor Fake vor Stub oder Mock. Ein übermäßiger Einsatz von Mock-Frameworks führte bei Google zu Tests, die bei jeder Umstrukturierung brachen, ohne echte Fehler zu finden. Fakes, also schlanke, funktionierende Ersatzimplementierungen, sollten idealerweise vom Team gepflegt werden, das auch die echte Implementierung verantwortet.
// Fake statt Mock: eine einfache, funktionierende Implementierung
public final class InMemoryPolicyRepository implements PolicyRepository {
    private final Map<PolicyId, Policy> store = new ConcurrentHashMap<>();

    @Override public void save(Policy p)               { store.put(p.id(), p); }
    @Override public Optional<Policy> find(PolicyId id) { return Optional.ofNullable(store.get(id)); }
}

@Test
void cancellingAPolicyMarksItCancelled() {
    var repo = new InMemoryPolicyRepository();
    var service = new PolicyService(repo);
    repo.save(Policy.active(new PolicyId("P-1")));

    service.cancel(new PolicyId("P-1"));

    // Zustand prüfen, nicht „wurde save() mit X aufgerufen?“
    assertThat(repo.find(new PolicyId("P-1")).orElseThrow().status()).isEqualTo(CANCELLED);
}
Große Tests
Große Tests sind nötig, weil kleine Tests manche Fehler nicht finden: Konfiguration, Zusammenspiel, echte Daten, Last. Das Buch beschreibt verschiedene Arten, darunter Vergleiche zwischen alter und neuer Version mit echtem Verkehr, Funktionstests gegen produktionsnahe Umgebungen, Lasttests, Sondierungen in Produktion und Übungen für den Katastrophenfall.
Einordnung
Die Kapitel sind eine Schlichtung des Schulenstreits, den Khorikov ausführlich behandelt: Mit dem Vorrang echter Implementierungen und Fakes und der Prüfung von Zustand statt Interaktionen stehen sie näher an Beck und der Chicagoer Schule als an Freeman und Pryce. Die Unterscheidung von Größe und Reichweite ist präziser als die übliche Rede von Unit- und Integrationstests.
Alte Systeme abschalten
Ein Kapitel, das man in kaum einem anderen Buch findet: Wie schaltet man ein System ab, das nicht mehr gebraucht wird oder durch ein besseres ersetzt wurde?
Code ist eine Last
Die Autoren betonen, dass Code kein Vermögenswert ist, sondern eine Verbindlichkeit: Jede Zeile muss gelesen, gepflegt, abgesichert und bei Upgrades mitgezogen werden. Was zählt, ist die Funktion, die Code bereitstellt. Zwei Systeme für dieselbe Aufgabe kosten doppelt, und ein altes System, das nur noch wenige nutzen, bindet trotzdem Fachleute.
Warum es so schwer ist
Abschalten ist schwer, weil Hyrums Gesetz zuschlägt: Nutzer hängen von Verhaltensweisen ab, die niemand dokumentiert hat. Das neue System muss nicht nur die offiziellen Funktionen ersetzen, sondern auch die inoffiziellen. Hinzu kommt, dass Abschalten selten Anerkennung bringt; neue Systeme zu bauen ist attraktiver.
Zwei Arten
| Art | Vorgehen | Grenze |
|---|---|---|
| Empfehlend | Das alte System wird als veraltet markiert, Nutzer sollen freiwillig wechseln. | Funktioniert nur, wenn das neue System deutlich besser ist; sonst wechselt kaum jemand. |
| Verpflichtend | Es gibt eine Frist, danach wird abgeschaltet. | Braucht ein Team, das Nutzer aktiv unterstützt oder selbst migriert, und Rückendeckung der Leitung. |
Praktische Hinweise
- Schon beim Entwurf an das spätere Abschalten denken: Wie würden Nutzer migrieren? Welche Abhängigkeiten entstehen?
- Warnungen müssen umsetzbar und relevant sein; Warnungen, die man nicht beheben kann, werden ignoriert.
- Neue Nutzung verhindern, etwa durch Werkzeuge, die neue Abhängigkeiten auf das alte System ablehnen.
- Verantwortliche und Meilensteine festlegen; ohne beides bleibt ein System im Halbtod.
Einordnung
Das Kapitel ist das Gegenstück zu Feathers‘ Working Effectively with Legacy Code und Newmans Strangler-Muster: Dort geht es darum, Altes schrittweise zu ersetzen; hier darum, es danach auch wirklich loszuwerden. Die Idee, schon beim Entwurf an das Abschalten zu denken, passt zu Ford, Parsons und Kua: Evolutionäre Architektur heißt auch, Teile entfernen zu können.
Werkzeuge
Der vierte Teil beschreibt Googles Werkzeuge. Wichtiger als die Werkzeuge selbst, die außerhalb von Google meist nicht verfügbar sind, sind die Gründe, warum sie so gebaut wurden.
Versionskontrolle: eine Version von allem
Google arbeitet in einem einzigen großen Repository und fast ausschließlich auf dem Hauptzweig, ohne langlebige Entwicklungszweige. Dazu kommt die Regel der einen Version: Von jeder Abhängigkeit gibt es in der ganzen Codebasis genau eine Version. Das vermeidet Konflikte, bei denen zwei Bibliotheken unterschiedliche Versionen derselben dritten Bibliothek brauchen. Die Autoren betonen, dass nicht das gemeinsame Repository entscheidend ist, sondern die eine Version.
Build
| Ansatz | Beispiel | Eigenschaft |
|---|---|---|
| Aufgabenbasiert | Maven, Gradle, Ant | der Build ist eine Folge von Aufgaben; flexibel, aber schwer zu parallelisieren und zu cachen |
| Artefaktbasiert | Bazel, Googles Build-System als Open Source | man beschreibt, welche Artefakte aus welchen Quellen entstehen; das System entscheidet selbst, was gebaut werden muss |
Ziel ist ein hermetischer, reproduzierbarer Build: Gleiche Eingaben ergeben immer gleiche Ausgaben, unabhängig von der Maschine. Erst das ermöglicht verteiltes Bauen und gemeinsame Caches für Tausende Entwickler.
Statische Analyse
Analysen werden direkt im Code-Review angezeigt. Entscheidend ist eine niedrige Fehlalarmrate: Werkzeuge, die zu viele falsche Warnungen liefern, werden ignoriert. Jede Warnung muss verständlich und behebbar sein, und Entwickler können melden, dass eine Warnung nicht hilfreich war.
Abhängigkeiten
Die Autoren nennen die Verwaltung von Abhängigkeiten das schwierigste Problem der Softwaretechnik im großen Maßstab. Semantische Versionierung sei eher eine Schätzung des Anbieters, ob eine Änderung Nutzer bricht, als eine Garantie, wegen Hyrums Gesetz. Googles Ideal ist, immer gegen den aktuellen Stand einer Abhängigkeit zu arbeiten und Brüche sofort durch Tests zu bemerken.
Große Änderungen
Wenn sich eine zentrale Bibliothek ändert, müssen Tausende Stellen angepasst werden. Google macht das mit automatisierten Werkzeugen: Die Änderung wird maschinell erzeugt, in kleine, unabhängig prüfbare Teile zerlegt, automatisch getestet und von einer kleinen Gruppe übergreifend Verantwortlicher freigegeben. In der Java-Welt erfüllt OpenRewrite einen ähnlichen Zweck, etwa um Upgrades von Spring Boot oder Java-Versionen automatisch über viele Repositories auszurollen.
Integration, Auslieferung, Betrieb
- Kontinuierliche Integration: Tests vor dem Einchecken für den betroffenen Teil, umfassendere Tests danach; Ziel ist, Brüche in Minuten zu erkennen.
- Kontinuierliche Auslieferung: häufig und in kleinen Schritten ausliefern, mit Feature Flags und schrittweiser Freigabe; Geschwindigkeit ist ein Mannschaftssport.
- Rechenleistung als Dienst: Anwendungen laufen in einem gemeinsamen Cluster, beschrieben durch Konfiguration statt durch einzelne Server; Maschinen sind austauschbar.
Einordnung
Vieles davon ist inzwischen Allgemeingut: Kubernetes ging aus Googles internem Clustersystem hervor, Bazel ist frei verfügbar, Trunk-basierte Entwicklung ist eine der Fähigkeiten, die Accelerate mit hoher Leistung verbindet. Die Regel der einen Version entspricht dem, was in Maven mit einem zentralen Stückliste-Modul, einer „Bill of Materials“, oder in Gradle mit Versionskatalogen angestrebt wird.
Kritik und Einordnung
Stärken
- Neue Perspektive: Zeit und Maßstab als Leitfragen ordnen viele bekannte Ratschläge neu und erklären, warum sie gelten.
- Hyrums Gesetz: eine der wenigen Einsichten der letzten Jahre, die sofort Allgemeingut wurde.
- Ehrlichkeit: Die Autoren beschreiben auch Fehler und Umwege, etwa die lange Zeit ohne Testkultur oder den Missbrauch von Mocks.
- Testkapitel: gehören zu den besten Darstellungen des Themas überhaupt.
- Seltene Themen: Abschalten, große automatisierte Änderungen, Abhängigkeiten im großen Maßstab.
- Kostenlos online.
Kritikpunkte
1. Google ist nicht die Welt. Ein einziges Repository, eigene Build- und Review-Werkzeuge, fast unbegrenzte Rechenleistung und Tausende Infrastrukturentwickler: Vieles lässt sich nicht direkt übertragen. Die Autoren sagen das selbst, aber Leser übersehen es leicht.
2. Uneinheitlich. Weil viele Autoren beigetragen haben, schwanken Stil, Tiefe und Qualität zwischen den Kapiteln.
3. Werkzeugkapitel altern. Die Beschreibungen interner Werkzeuge sind für Außenstehende teils schwer nachvollziehbar und spiegeln den Stand von 2020.
4. Wenig über Architektur. Wie man Systeme schneidet oder Schnittstellen entwirft, kommt kaum vor; dafür sind Ousterhout, Evans oder Richards und Ford zuständig.
5. Wenig über KI. Das Buch erschien vor dem Einsatz von KI-Werkzeugen in der Entwicklung; Fragen wie maschinell erzeugter Code im Review oder große Änderungen durch Agenten fehlen naturgemäß.
Gesamturteil
Ein wertvolles Buch für alle, die Software über Jahre und mit vielen Beteiligten verantworten. Für Java-Architekten in mittelgroßen Organisationen lohnen sich besonders die Kapitel 1, 9, 11 bis 13, 15 und 21: Zeit und Maßstab, Code-Review, Testen, Abschalten und Abhängigkeiten. Die übrigen Kapitel liest man mit der Frage: Was davon passt in unserem Maßstab?
Bezüge zur Reihe
| Thema bei Winters, Manshreck, Wright | Bezug in der Reihe |
|---|---|
| Programmieren über die Zeit | Brooks: Programm und Programmsystemprodukt; Beck, Tidy First?: Optionen für künftige Änderungen |
| Hyrums Gesetz | Bloch: Schnittstellen klein halten; Ousterhout: tiefe Module; Newman: Verträge zwischen Diensten |
| Upgrades oft und regelmäßig | Humble und Farley: was weh tut, öfter tun |
| Wer ändert, migriert | Skelton und Pais: Plattform-Teams; Hohpe: Plattform als Produkt |
| Daten statt Autorität | Forsgren, Humble, Kim: Accelerate; McConnell: empirische Grundlage |
| Demut, Respekt, Vertrauen | Fitzpatrick und Collins-Sussman: Debugging Teams; DeMarco und Lister: Peopleware |
| Führen in großem Maßstab | Reilly: The Staff Engineer’s Path; Hohpe: Architekt im Aufzug |
| Ziele, Signale, Kennzahlen | Huyen: Kennzahlen bewusst wählen; Christian: ausgenutzte Belohnungen |
| Stilregeln für den Leser | Martin, McConnell: lesbarer Code; Ousterhout: Urteilsvermögen |
| Code-Review und kleine Änderungen | Beck: kleine Schritte; Harmel-Law: Rat einholen |
| Testgröße und -reichweite, Fakes vor Mocks | Khorikov: Schulen schlichten; Beck: Chicagoer Schule; Freeman und Pryce: Londoner Schule |
| Abschalten alter Systeme | Feathers: Legacy-Code; Newman: Strangler; Ford u.a.: evolutionäre Architektur |
| Eine Version jeder Abhängigkeit | Ford u.a., The Hard Parts: gemeinsamer Code; Bloch: Abhängigkeiten minimieren |
| Große automatisierte Änderungen | Fowler: Refactoring, hier im Maßstab einer ganzen Organisation |
| Hermetischer Build, CI, CD | Humble und Farley: Continuous Delivery; SRE-Buch: Release-Engineering |
| Für alle bauen | Christian: Verzerrung in Daten; Prince: Ethik |
Diskussionsfragen
- Lebensdauer: Wie lange müssen eure wichtigsten Systeme noch leben? Wird das bei Entscheidungen berücksichtigt?
- Hyrums Gesetz: Welche undokumentierten Verhaltensweisen eurer Schnittstellen nutzen andere Teams, und wüsstet ihr es?
- Upgrades: Wie oft aktualisiert ihr Java, Spring und andere Abhängigkeiten? Ist das Routine oder jedes Mal ein Projekt?
- Wer migriert: Wenn ein Plattform-Team bei euch etwas ändert, wer passt die Nutzer an?
- Tests: Wie sieht eure Verteilung aus: Pyramide, Eistüte oder Sanduhr? Wie viele eurer Tests verwenden Mocks, wo ein Fake besser wäre?
- Abschalten: Welches System bei euch sollte längst abgeschaltet sein? Was hält es am Leben?
- Große Änderungen: Habt ihr schon automatisierte Umbauten über viele Repositories eingesetzt, etwa mit OpenRewrite?
- Übertragbarkeit: Welche Praxis aus dem Buch würdet ihr in eurem Maßstab sofort übernehmen, welche wäre überdimensioniert?