Software Architecture: The Hard Parts – Zusammenfassung und Einordnung
Neal Ford, Mark Richards, Pramod Sadalage, Zhamak Dehghani, Software Architecture: The Hard Parts – Modern Trade-Off Analyses for Distributed Architectures (2021)
Einleitung
Fundamentals of Software Architecture gibt einen Überblick über Stile und die Rolle des Architekten. The Hard Parts geht dorthin, wo es wehtut: zu den Entscheidungen in verteilten Systemen, für die es keine bewährten Lösungen gibt, nur Abwägungen. Wie fein soll ein Dienst sein? Wem gehören welche Daten? Wie hält man Daten über Dienste hinweg konsistent? Wie eng darf ein Vertrag sein?
Autoren und Kontext
Neben Neal Ford und Mark Richards, den Autoren von Fundamentals, schrieben zwei Datenspezialisten mit: Pramod Sadalage, Mitautor von Refactoring Databases und NoSQL Distilled, und Zhamak Dehghani, die den Begriff Data Mesh geprägt hat. Das Buch erschien 2021, als viele Organisationen mitten in der Aufteilung ihrer Monolithen steckten und merkten, dass der Code der leichtere Teil war; die Daten waren der schwere.
Die Kernthese
Die Autoren beginnen mit einer ungewöhnlichen Feststellung: Viele Architekturentscheidungen sind so spezifisch für eine Organisation, dass es keine Best Practices gibt. Was es gibt, sind wiederkehrende Kräfte, die man erkennen und gegeneinander abwägen kann. Das Ziel des Buchs ist, Architekten zu befähigen, ihre eigene Abwägungsanalyse zu machen, statt nach fertigen Antworten zu suchen.
Daher der Untertitel: Modern Trade-Off Analyses for Distributed Architectures. Das erste Gesetz aus Fundamentals, alles ist eine Abwägung, ist hier das Programm.
Die Fallgeschichte
Durch das ganze Buch zieht sich eine erzählte Geschichte: Ein Elektronikhändler hat einen Kundendienst namens Sysops Squad, dessen Ticketsystem ein alter Monolith ist. Es ist langsam, fällt häufig aus, und Änderungen dauern lange. Ein kleines Team aus Architekten und Entwicklern soll es in eine verteilte Architektur überführen. Jedes Kapitel beginnt mit einer Szene, in der das Team vor einer schwierigen Entscheidung steht, und endet mit einem ADR, das die Entscheidung festhält.
Aufbau
| Teil | Kapitel | Inhalt |
|---|---|---|
| Einführung | 1 | Entscheidungen ohne Best Practices, ADRs, Fitness Functions |
| I. Auseinandernehmen | 2–7 | Kopplung, Modularität, Zerlegung, Daten aufteilen, Granularität |
| II. Wieder zusammenfügen | 8–14 | Wiederverwendung, Datenbesitz, verteilter Datenzugriff, Abläufe, Sagas, Verträge, analytische Daten |
| Abschluss | 15 | die eigene Abwägungsanalyse |
Mit rund 450 Seiten ist das Buch dicht; anders als Fundamentals geht es selten in die Breite, sondern fast immer in die Tiefe einer Entscheidung.
Kopplung erkennen
Das zweite Kapitel legt die begriffliche Grundlage für das ganze Buch. Es präzisiert das Architekturquant aus Fundamentals.
Statische und dynamische Kopplung
| Art | Bedeutung | Beispiele |
|---|---|---|
| Statisch | wie Dienste verdrahtet sind: was ein Dienst braucht, um überhaupt zu starten und zu funktionieren | gemeinsame Datenbank, gemeinsame Bibliotheken, Verträge, Betriebssystem, Broker |
| Dynamisch | wie Dienste zur Laufzeit miteinander sprechen | synchrone und asynchrone Aufrufe, Konsistenzanforderungen, Koordination |
Das Architekturquant, präzisiert
Ein Architekturquant ist ein Teil des Systems, der
- unabhängig auslieferbar ist,
- hohe fachliche Kohäsion hat,
- hohe statische Kopplung in sich trägt, also gemeinsam funktioniert,
- und dessen Teile synchron dynamisch gekoppelt sind.
Der wichtigste Punkt: Zwei Microservices, die dieselbe Datenbank nutzen, bilden ein Quant, auch wenn sie getrennt ausgeliefert werden, weil beide ohne diese Datenbank nicht funktionieren. Und zwei Dienste, die sich synchron aufrufen, teilen während des Aufrufs ihre Verfügbarkeit und Leistung. Ein Monolith ist immer genau ein Quant; ein verteiltes System kann eines oder viele sein.
Drei Kräfte der dynamischen Kopplung
Die Autoren beschreiben dynamische Kopplung durch drei Dimensionen, die später die acht Sagas ergeben:
| Dimension | Ausprägungen |
|---|---|
| Kommunikation | synchron oder asynchron |
| Konsistenz | atomar oder letztendlich konsistent |
| Koordination | orchestriert oder choreografiert |
Gründe für Modularität
Bevor man ein System aufteilt, soll man wissen, warum. Die Autoren nennen fünf Treiber, die man den Fachleuten gegenüber begründen kann:
| Treiber | Wirkung |
|---|---|
| Wartbarkeit | Änderungen bleiben in einem Teil, weniger Seiteneffekte |
| Testbarkeit | kleinere Teile lassen sich vollständiger testen |
| Auslieferbarkeit | Teile können unabhängig und häufiger ausgeliefert werden |
| Skalierbarkeit und Elastizität | Teile mit hoher Last werden einzeln skaliert |
| Verfügbarkeit und Fehlertoleranz | Ausfälle bleiben auf einen Teil begrenzt |
Die Autoren betonen, dass Architekten diese Treiber in geschäftlicher Sprache begründen müssen, etwa als schnellere Markteinführung, geringere Ausfallkosten oder bessere Zufriedenheit der Kunden. Sonst bleibt eine Aufteilung ein technisches Projekt ohne Rückhalt.
Einordnung
Das präzisierte Quant ist die vielleicht nützlichste Begriffsbildung des Buchs. Es erklärt in einem Satz, warum Newmans verteilter Monolith kein Fortschritt ist: Er hat viele Dienste, aber nur ein Quant. Die drei Dimensionen der dynamischen Kopplung sind eine Erweiterung der Konnaszenz aus Fundamentals.
Ein System zerlegen
Wie zerlegt man einen bestehenden Monolithen? Die Autoren stellen zwei Wege vor und eine Folge von Mustern für den ersten.
Ist der Code überhaupt zerlegbar?
Vor der Zerlegung lohnt ein Blick auf die Struktur. Die Autoren greifen Martins Kennzahlen auf, Abstraktheit, Instabilität und Abstand zur Hauptreihe, sowie die Kopplung zwischen Komponenten. Code, der als großer Matschklumpen ohne erkennbare Komponenten vorliegt, lässt sich nicht sinnvoll Komponente für Komponente zerlegen.
Zwei Wege
| Ansatz | Vorgehen | Passt, wenn |
|---|---|---|
| Komponentenbasierte Zerlegung | Komponenten im Monolithen erkennen, schrittweise ordnen, zu fachlichen Diensten zusammenfassen und dann herauslösen | der Code eine erkennbare Struktur hat |
| Taktisches Forken | den ganzen Monolithen mehrfach kopieren und in jeder Kopie alles löschen, was der jeweilige Dienst nicht braucht | der Code keine Struktur hat; schnell, aber jeder Dienst trägt anfangs viel totes Gewicht |
Taktisches Forken klingt grob, hat aber einen Vorteil: Teams können sofort unabhängig arbeiten. Die Aufräumarbeit folgt danach.
Sechs Muster für die komponentenbasierte Zerlegung
Das fünfte Kapitel ist eines der praktischsten des Buchs: eine Folge von sechs Schritten, jeder mit einer Fitness Function, die den Fortschritt messbar macht.
| Schritt | Muster | Inhalt |
|---|---|---|
| 1 | Komponenten erkennen und bemessen | alle Komponenten, also Pakete oder Namensräume, auflisten und nach Größe vergleichen; zu große aufteilen |
| 2 | Gemeinsame Fachkomponenten sammeln | doppelte fachliche Logik, etwa Benachrichtigungen an verschiedenen Stellen, zusammenführen |
| 3 | Komponenten abflachen | verschachtelte Pakete so ordnen, dass Code nur in Blättern liegt und es keine verwaisten Klassen in Elternpaketen gibt |
| 4 | Abhängigkeiten bestimmen | prüfen, wie stark Komponenten voneinander abhängen und ob eine Zerlegung machbar ist |
| 5 | Komponentendomänen bilden | Komponenten zu fachlichen Gruppen zusammenfassen, sichtbar in der Paketstruktur |
| 6 | Domänendienste bilden | jede Domäne als eigenen, groben Dienst herauslösen, also eine service-basierte Architektur |
Erst danach, und nur wo nötig, werden Domänendienste weiter in Microservices geteilt.
// Fitness Function zu Schritt 1: keine Komponente größer als 10 % der Codebasis
@ArchTest
static void noComponentDominates(JavaClasses classes) {
    Map<String, Long> sizeByComponent = classes.stream()
        .collect(groupingBy(c -> componentOf(c.getPackageName()), counting()));
    long total = classes.size();
    sizeByComponent.forEach((component, size) ->
        assertThat(size * 100 / total)
            .as("Komponente %s", component)
            .isLessThanOrEqualTo(10));
}
Einordnung
Der Weg über Domänendienste als Zwischenschritt ist die Empfehlung aus Fundamentals, die service-basierte Architektur als pragmatischen Mittelweg zu nutzen, und Newmans Rat, grob anzufangen. Schritt 5 entspricht dem modularen Monolithen: Die fachliche Struktur wird erst im Code sichtbar, bevor sie verteilt wird.
Operative Daten aufteilen
Das sechste Kapitel, maßgeblich von Sadalage geprägt, behandelt den schwierigsten Teil jeder Zerlegung: die Datenbank.
Kräfte für und gegen die Aufteilung
Die Autoren führen hier ein Denkmuster ein, das sich durch das ganze Buch zieht: Zerlegungstreiber gegen Zusammenhaltstreiber.
| Für die Aufteilung | Inhalt |
|---|---|
| Änderungskontrolle | eine Schemaänderung betrifft bei gemeinsamer Datenbank alle Dienste; getrennte Datenbanken begrenzen den Schaden |
| Verbindungsverwaltung | viele Dienste mit eigenen Verbindungspools erschöpfen eine gemeinsame Datenbank |
| Skalierbarkeit | eine Datenbank kann zum Engpass für alle Dienste werden |
| Fehlertoleranz | fällt die gemeinsame Datenbank aus, fallen alle Dienste aus |
| Architekturquanten | eine gemeinsame Datenbank verschmilzt alle Dienste zu einem Quant |
| Optimierung des Datenbanktyps | verschiedene Daten passen zu verschiedenen Datenbanktypen |
| Für den Zusammenhalt | Inhalt |
|---|---|
| Datenbeziehungen | Fremdschlüssel, Trigger, Sichten und gespeicherte Prozeduren verbinden Tabellen |
| Datenbanktransaktionen | was atomar sein muss, gehört in eine Datenbank |
Die Entscheidung ergibt sich aus der Abwägung dieser Kräfte für die konkreten Tabellen, nicht aus einem Grundsatz wie „jeder Dienst hat seine eigene Datenbank“.
Fünf Schritte
Für die Aufteilung beschreiben die Autoren einen schrittweisen Weg, angelehnt an Sadalages Refactoring Databases:
| Schritt | Inhalt |
|---|---|
| 1 | Datenbank analysieren und Datendomänen bilden, also Gruppen zusammengehöriger Tabellen |
| 2 | Tabellen den Domänen zuordnen, etwa als getrennte Schemas in derselben Datenbank |
| 3 | Datenbankverbindungen der Dienste auf ihre jeweiligen Schemas beschränken; Zugriffe auf fremde Schemas sichtbar machen und beseitigen |
| 4 | Schemas auf getrennte Datenbankserver verschieben, zunächst mit Replikation |
| 5 | auf die unabhängigen Server umschalten |
Schritt 3 ist der entscheidende: Solange ein Dienst noch Tabellen einer anderen Domäne direkt liest, ist die Aufteilung nicht fertig. Diese Zugriffe müssen zuerst durch Aufrufe, Replikation oder Ereignisse ersetzt werden, wie die späteren Kapitel beschreiben.
Datenbanktypen
Das Kapitel bewertet außerdem acht Arten von Datenbanken, relational, Schlüssel-Wert, Dokument, Spaltenfamilie, Graph, NewSQL, Cloud-nativ und Zeitreihen, nach Kriterien wie Lernkurve, Modellierung, Skalierbarkeit, Konsistenz und Verfügbarkeit. Das ist eine knappe Fassung dessen, was Kleppmann ausführlich herleitet.
Einordnung
Die Unterscheidung von Kräften für und gegen die Aufteilung ist das zentrale Werkzeug des Buchs. Sie macht aus „Datenbank pro Dienst“, einer Regel aus Newmans Buch, eine Entscheidung, die man für jeden Fall abwägen kann.
Dienstgranularität
Wie groß soll ein Dienst sein? Statt einer Regel geben die Autoren zwei Gruppen von Kräften, die gegeneinander abgewogen werden.
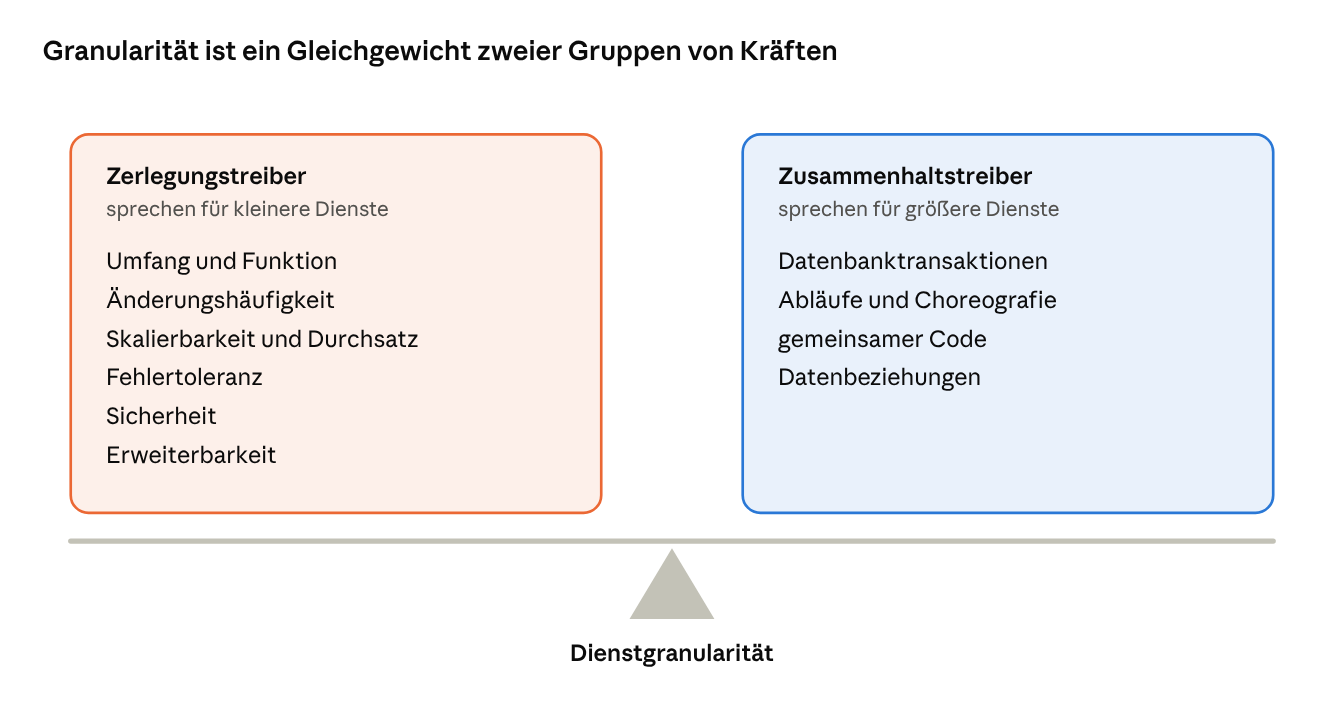
die Kräfte der Dienstgranularität nach Ford, Richards, Sadalage und Dehghani
Zerlegungstreiber
| Treiber | Frage |
|---|---|
| Umfang und Funktion | Tut der Dienst zu viele, nicht zusammenhängende Dinge? |
| Änderungshäufigkeit | Ändert sich ein Teil viel häufiger als der Rest? |
| Skalierbarkeit und Durchsatz | Braucht ein Teil eine ganz andere Skalierung? |
| Fehlertoleranz | Soll ein Teil weiterlaufen, wenn ein anderer ausfällt? |
| Sicherheit | Braucht ein Teil strengeren Schutz, etwa Zahlungsdaten? |
| Erweiterbarkeit | Kommen in einem Teil regelmäßig neue Varianten hinzu, etwa neue Zahlungsarten? |
Zusammenhaltstreiber
| Treiber | Frage |
|---|---|
| Datenbanktransaktionen | Müssen Änderungen in mehreren Teilen atomar sein? |
| Abläufe und Choreografie | Rufen sich die Teile so häufig gegenseitig auf, dass Latenz, Fehleranfälligkeit und Komplexität steigen? |
| Gemeinsamer Code | Teilen die Teile so viel Logik, dass eine Trennung ständige Abstimmung erzwingt? |
| Datenbeziehungen | Sind die Daten so verflochten, dass eine Trennung viele Abfragen über Dienstgrenzen erfordert? |
Das Vorgehen
Für jeden Kandidaten listet man die zutreffenden Kräfte auf beiden Seiten und gewichtet sie mit den Fachleuten. Ein Beispiel in der Art des Buchs, das solche Fälle mit der Fallgeschichte durchspielt: Ein Benachrichtigungsdienst für SMS, E-Mail und Brief soll aufgeteilt werden, weil neue Kanäle hinzukommen könnten, also Erweiterbarkeit. Dagegen spricht, dass die drei Kanäle dieselbe Logik zur Auswahl und Formatierung teilen, also gemeinsamer Code. Je nachdem, welche Kraft schwerer wiegt, bleibt es ein Dienst mit internen Erweiterungspunkten oder wird aufgeteilt.
Die Autoren betonen, dass dieselbe Analyse in einem anderen Unternehmen zum entgegengesetzten Ergebnis führen kann. Das ist der Kern des Buchs.
Einordnung
Die Zerlegungstreiber entsprechen den Kriterien, die Newman neben fachlichen Grenzen nennt, etwa Änderungshäufigkeit und Daten. Die Zusammenhaltstreiber sind Kohäsion im Sinne von Martins Common Closure Principle und Becks „Was sich gemeinsam ändert, gehört zusammen“.
Wiederverwendung
Teil II fragt, wie man Teile wieder zusammenbringt, nachdem man sie getrennt hat. Das erste Thema ist Code, den mehrere Dienste brauchen.
| Muster | Stärke | Schwäche | Passt für |
|---|---|---|---|
| Code duplizieren | volle Unabhängigkeit | Änderungen müssen überall nachgezogen werden | stabilen, einfachen Code |
| Gemeinsame Bibliothek | eine Stelle für Änderungen, keine Laufzeitkopplung | Versionen laufen auseinander; Änderungen erzwingen Neuauslieferungen | technische Belange, eher kleine, feingranulare Bibliotheken |
| Gemeinsamer Dienst | Änderungen sofort für alle wirksam | Laufzeitkopplung: Latenz, Ausfallrisiko, Versionierung der Schnittstelle | fachliche Logik, die sich oft ändert |
| Sidecar und Service Mesh | technische Querschnittsbelange außerhalb des Codes | zusätzliche Infrastruktur | Logging, Sicherheit, Metriken |
Die Autoren unterscheiden zwei Achsen: fachliche Wiederverwendung, die meist besser vermieden oder in einen Dienst ausgelagert wird, und technische, quer zu allen Diensten, für die Sidecars und Plattformen gedacht sind. Ihr Rat zu Bibliotheken: lieber mehrere kleine als eine große „Commons“-Bibliothek, die bei jeder Änderung alle Dienste betrifft.
Datenbesitz
Nach der Aufteilung muss jede Tabelle einem Dienst gehören. Die Autoren unterscheiden drei Situationen:
| Situation | Beschreibung | Lösung |
|---|---|---|
| Alleiniger Besitz | nur ein Dienst schreibt in die Tabelle | einfach: die Tabelle gehört diesem Dienst |
| Gemeinsamer Besitz | viele Dienste schreiben, etwa eine Audit-Tabelle | ein eigener Dienst übernimmt die Tabelle; die anderen senden ihm Nachrichten |
| Geteilter Besitz | wenige, meist zwei Dienste schreiben in dieselbe Tabelle | eine von vier Techniken |
Vier Techniken für geteilten Besitz
| Technik | Inhalt | Abwägung |
|---|---|---|
| Tabelle aufteilen | jeder Dienst erhält den Teil der Tabelle, den er schreibt | klare Zuständigkeit, aber Synchronisation zwischen den Teilen |
| Datendomäne | beide Dienste teilen ein Schema | einfach, aber Kopplung bleibt |
| Delegieren | ein Dienst besitzt die Tabelle, der andere ruft ihn auf | klare Zuständigkeit, aber Laufzeitkopplung |
| Dienste zusammenlegen | beide Dienste werden zu einem | Konsistenz einfach, Dienst wird größer |
Beim Delegieren gibt es zwei Varianten: Der Dienst mit der fachlichen Priorität besitzt die Daten, etwa der Katalog die Produktdaten, oder der Dienst mit dem höheren Schreibvolumen.
Verteilte Transaktionen und letztendliche Konsistenz
Ohne gemeinsame Transaktion sind Daten über Dienste hinweg nur letztendlich konsistent. Die Autoren beschreiben drei Wege dorthin:
| Muster | Funktionsweise | Abwägung |
|---|---|---|
| Hintergrund-Synchronisation | ein separater Prozess gleicht Daten periodisch ab | einfach, aber verzögert; koppelt den Prozess an alle Datenbanken |
| Orchestriert, anfragebasiert | ein Koordinator ruft alle Beteiligten nacheinander synchron auf | schnell konsistent, aber Fehlerbehandlung komplex |
| Ereignisbasiert | ein Dienst veröffentlicht ein Ereignis, andere aktualisieren ihre Daten | entkoppelt, schnell; Fehlerbehandlung über Dead Letter Queues |
// Ereignisbasierte Konsistenz mit Transactional Outbox
@Transactional
public void closeCustomerAccount(CustomerId id) {
    customers.markClosed(id);                                   // eigene Daten
    outbox.add(new CustomerClosed(id, Instant.now()));          // gleiche Transaktion
}
// Ein separater Prozess veröffentlicht die Outbox auf Kafka;
// Ticket- und Vertragsdienst entfernen den Kunden aus ihren eigenen Daten.
Einordnung
Die Wiederverwendungsmuster sind fast wörtlich das Kapitel über Architekturmuster aus der zweiten Auflage von Fundamentals. Die Techniken für geteilten Besitz sind eine Ausarbeitung von Evans‘ Context Map auf Datenebene, und die Outbox ist EIPs Transactional Client in heutiger Form.
Verteilter Datenzugriff
Wenn jede Tabelle einem Dienst gehört, wie liest ein Dienst dann Daten, die einem anderen gehören? Etwa der Wunschlistendienst den Produktnamen aus dem Katalog? Die Autoren vergleichen vier Muster:
| Muster | Funktionsweise | Stärke | Schwäche |
|---|---|---|---|
| Dienstaufruf | der Dienst fragt den Besitzer bei Bedarf | Daten immer aktuell, keine Kopie | Latenz, Laufzeitkopplung, Ausfallrisiko |
| Spaltenreplikation | der Dienst hält eine Kopie der benötigten Spalten in eigener Tabelle, aktualisiert über Ereignisse | schnell, unabhängig | Daten können veraltet sein; Synchronisation nötig |
| Replizierter Cache | der Besitzer stellt seine Daten in einem verteilten In-Memory-Cache bereit, den andere nur lesen | schnell, Besitz bleibt klar | Speicherbedarf, Startreihenfolge, Volumenbegrenzung |
| Datendomäne | beide Dienste teilen ein Schema für diese Daten | einfach, konsistent, schnell | Kopplung über das Schema, gemeinsames Quant |
Welches Muster passt, hängt von Datenmenge, Änderungsrate, Konsistenzanforderungen und Verfügbarkeitsansprüchen ab. Spaltenreplikation entspricht dem, was Kleppmann als abgeleitete Daten beschreibt.
Abläufe über Dienste
Das elfte Kapitel vertieft die Frage aus Fundamentals: Orchestrierung oder Choreografie?
| Orchestrierung | Choreografie | |
|---|---|---|
| Fehlerbehandlung | an einer Stelle | verteilt |
| Wiederherstellung | Koordinator kennt den Zustand | schwierig |
| Zustandsverwaltung | zentral | verteilt oder in der Nachricht |
| Reaktionsfähigkeit und Skalierbarkeit | Koordinator wird Engpass | besser |
| Kopplung | Koordinator kennt alle | Dienste kennen nur Ereignisse |
Die Faustregel der Autoren: Je komplexer ein Ablauf und je wichtiger Fehlerbehandlung, desto eher Orchestrierung. Je einfacher und je wichtiger Skalierbarkeit, desto eher Choreografie.
Zustand in choreografierten Abläufen
Ohne Koordinator weiß niemand, wo ein Ablauf gerade steht. Die Autoren beschreiben drei Lösungen:
| Muster | Inhalt |
|---|---|
| Front Controller | der erste Dienst im Ablauf verfolgt den Zustand und beantwortet Statusanfragen |
| Zustandslose Choreografie | der Zustand wird bei Bedarf durch Abfragen aller Beteiligten ermittelt |
| Stamp Coupling | der Zustand reist in der Nachricht mit; jeder Dienst ergänzt seinen Teil |
Semantische und Implementierungskopplung
Ein wichtiger Gedanke des Kapitels: Ein Ablauf hat eine semantische Kopplung, die aus der Fachlichkeit kommt und sich nicht wegarchitektieren lässt. Eine Bestellung braucht Zahlung, Lager und Versand, egal wie man die Dienste schneidet. Die Implementierungskopplung, also wie die Dienste diese Schritte konkret verbinden, kann man wählen. Gute Architektur bildet die semantische Kopplung ab, ohne zusätzliche Implementierungskopplung hinzuzufügen. Das ist Brooks‘ Unterscheidung von wesentlicher und zufälliger Komplexität, angewandt auf Abläufe.
Die acht transaktionalen Sagas
Das zwölfte Kapitel ist das bekannteste des Buchs. Es kombiniert die drei Dimensionen der dynamischen Kopplung, Kommunikation, Konsistenz und Koordination, zu acht Saga-Mustern und gibt jedem einen einprägsamen Namen.
| Name | Kommunikation | Konsistenz | Koordination | Charakter |
|---|---|---|---|---|
| Epic Saga | synchron | atomar | orchestriert | verhält sich wie ein Monolith; stark gekoppelt, einfach zu verstehen, schlecht skalierbar |
| Phone Tag | synchron | atomar | choreografiert | ohne Koordinator, aber mit atomarem Anspruch; Fehlerbehandlung schwierig |
| Fairy Tale | synchron | letztendlich | orchestriert | übersichtlich, gut handhabbar; ein pragmatischer Standard |
| Time Travel | synchron | letztendlich | choreografiert | einfache Kette, gut für lineare Abläufe mit hohem Durchsatz |
| Fantasy Fiction | asynchron | atomar | orchestriert | atomar und asynchron widerspricht sich; komplex |
| Horror Story | asynchron | atomar | choreografiert | die schlechteste Kombination: atomarer Anspruch ohne Koordinator und ohne Synchronität |
| Parallel | asynchron | letztendlich | orchestriert | gut skalierbar, Koordinator behält den Überblick |
| Anthology | asynchron | letztendlich | choreografiert | am lockersten gekoppelt, am besten skalierbar, am schwersten nachzuvollziehen |
Die Lehren
- Atomare Konsistenz in verteilten Systemen ist teuer und wird mit jeder weiteren Entkopplung schwieriger. Die Kombinationen mit atomarer Konsistenz und asynchroner Kommunikation sind fast immer schlecht.
- Fairy Tale und Parallel sind für viele Geschäftsabläufe die vernünftigen Mittelwege: ein Koordinator für Übersicht und Fehlerbehandlung, letztendliche Konsistenz für Entkopplung.
- Anthology passt für einfache Abläufe mit sehr hohem Durchsatz, bei denen Überblick weniger wichtig ist.
- Teams landen oft unbeabsichtigt bei einer Horror Story: Sie bauen choreografierte, asynchrone Dienste und erwarten dann, dass alles atomar zusammenpasst.
Zustand statt Ausgleich
Die Autoren beschreiben eine Alternative zu Ausgleichsaktionen: Saga-Zustandsmaschinen. Statt bei einem Fehler alle Schritte zurückzunehmen, bleibt der Ablauf in einem definierten Zwischenzustand, etwa „Ticket angelegt, Zuweisung ausstehend“, und wird später fortgesetzt oder von Menschen geklärt. Das ist oft fachlich ehrlicher als ein Ausgleich, der so tut, als sei nichts passiert.
enum TicketSagaState { CREATED, ASSIGNED, ROUTED, COMPLETED, ASSIGNMENT_FAILED, ROUTING_FAILED }

record TicketSaga(TicketId id, TicketSagaState state, Instant updatedAt) {
    TicketSaga on(TicketEvent e) {
        return switch (state) {
            case CREATED  -> e instanceof Assigned ? next(ASSIGNED) : next(ASSIGNMENT_FAILED);
            case ASSIGNED -> e instanceof Routed   ? next(ROUTED)   : next(ROUTING_FAILED);
            case ROUTED   -> e instanceof Done     ? next(COMPLETED) : this;
            default       -> this;          // Fehlerzustände warten auf Klärung
        };
    }
    private TicketSaga next(TicketSagaState s) { return new TicketSaga(id, s, Instant.now()); }
}
Einordnung
Die acht Sagas sind der vollständigste Rahmen für verteilte Abläufe in dieser Reihe. Newman unterscheidet nur zwei Varianten, Hohpe und Woolf beschreiben die Bausteine, Kleppmann die Theorie der Konsistenz. Hier werden sie zu einem Entscheidungsraum zusammengeführt.
Verträge
Verträge sind die Form, in der Dienste Informationen austauschen. Die Autoren beschreiben sie als Spektrum von streng bis locker.
| Streng | Locker | |
|---|---|---|
| Form | explizite Schemas: Protobuf, Avro, JSON Schema, typisierte Klassen | Schlüssel-Wert-Paare, freie JSON-Strukturen |
| Stärke | Verlässlichkeit, Typprüfung, Dokumentation, Werkzeugunterstützung | leicht weiterzuentwickeln, geringe Kopplung |
| Schwäche | jede Änderung erfordert Versionierung und Abstimmung | Fehler fallen erst zur Laufzeit auf, Bedeutung ist implizit |
Zwischen beiden Polen liegen verbraucherorientierte Verträge, wie Newman sie beschreibt: Der Anbieter darf sich frei ändern, solange er die Erwartungen seiner Verbraucher erfüllt.
Stamp Coupling
Ein verbreitetes Problem: Ein Dienst übergibt eine große Datenstruktur, etwa ein vollständiges Kundenprofil, obwohl der Empfänger nur zwei Felder braucht. Die Folgen: unnötige Bandbreite, und der Empfänger ist an Änderungen der ganzen Struktur gekoppelt. Die Autoren sehen Stamp Coupling aber nicht nur negativ: Zur Zustandsverwaltung in choreografierten Abläufen ist es nützlich, weil die Nachricht den Zustand des Ablaufs trägt.
Analytische Daten
Das vierzehnte Kapitel, maßgeblich von Dehghani geprägt, wechselt von operativen zu analytischen Daten: Berichte, Auswertungen, maschinelles Lernen. Es vergleicht drei Generationen.
| Ansatz | Idee | Problem |
|---|---|---|
| Data Warehouse | Daten aus allen Systemen werden in ein zentrales, sorgfältig modelliertes Schema geladen | zentrales Team als Engpass; enge Kopplung an die Quellsysteme; langsame Änderungen |
| Data Lake | Rohdaten werden zentral gesammelt und erst beim Lesen interpretiert | ohne Struktur und Verantwortung wird der See zum Sumpf |
| Data Mesh | Fachdomänen stellen ihre analytischen Daten selbst als Produkte bereit | organisatorisch anspruchsvoll; erfordert Plattform und gemeinsame Regeln |
Die vier Prinzipien von Data Mesh
| Prinzip | Inhalt |
|---|---|
| Fachliche Verantwortung | das Team, das die Daten erzeugt, verantwortet auch ihre analytische Bereitstellung |
| Daten als Produkt | analytische Daten haben Nutzer, Qualitätsziele, Dokumentation und Versionen wie ein Produkt |
| Selbstbedienungsplattform | eine Plattform macht es Teams einfach, Datenprodukte zu bauen und zu betreiben |
| Föderierte, rechnergestützte Steuerung | gemeinsame Regeln zu Sicherheit, Qualität und Interoperabilität werden automatisiert durchgesetzt |
Ein Datenprodukt-Quant ist das analytische Gegenstück zum Architekturquant: ein unabhängig betriebenes Datenprodukt neben dem operativen Dienst einer Domäne.
Einordnung
Data Mesh ist Team Topologies, angewandt auf Daten: Stream-aligned Teams besitzen ihre Datenprodukte, ein Plattform-Team stellt die Selbstbedienungsplattform. Es ist auch die analytische Seite von Evans‘ Bounded Contexts. Kleppmann ist vorsichtiger: Er beschreibt eher die technischen Bausteine, auf denen solche Plattformen aufbauen.
Die eigene Abwägungsanalyse
Das letzte Kapitel fasst die Methode zusammen, mit der das ganze Buch arbeitet, damit Leser sie auf eigene Probleme anwenden können.
Drei Schritte
- Verflochtene Dimensionen finden: Welche Teile hängen zusammen und wie, statisch und dynamisch?
- Kopplungspunkte analysieren: Wo genau entsteht die Kopplung, und welche Kräfte wirken darauf?
- Abwägungen bewerten: Wie wirkt sich jede Option auf die betroffenen Architekturmerkmale aus?
Ratschläge
- Qualitativ statt quantitativ: Für viele Architekturentscheidungen gibt es keine verlässlichen Zahlen. Eine ehrliche qualitative Analyse ist besser als scheinbar exakte Zahlen.
- Vollständige, sich nicht überschneidende Listen: Optionen und Kriterien so formulieren, dass nichts fehlt und nichts doppelt zählt.
- Die Kontextfalle vermeiden: Eine Abwägung, die anderswo richtig war, muss es hier nicht sein. Wer Optionen ohne den eigenen Kontext bewertet, kommt zu falschen Schlüssen.
- Konkrete Szenarien durchspielen: Statt abstrakt zu argumentieren, typische fachliche Fälle durch jede Option schicken.
- Das Ergebnis vor die Belege stellen: Fachleute wollen eine klare Empfehlung mit Begründung, nicht eine Wand aus Tabellen.
- Vorsicht vor Evangelisten: Wer eine Technologie oder einen Stil ohne Nachteile darstellt, hat die Abwägung nicht verstanden oder verschweigt sie. Das ist die Folgerung zum ersten Gesetz aus Fundamentals.
Kritik und Einordnung
Stärken
- Der Mut, keine Antworten zu geben: Statt Best Practices liefert das Buch Kräfte und Methoden. Das ist ehrlicher als die meisten Architekturbücher.
- Daten im Zentrum: Die Kapitel zu Datenaufteilung, Besitz, Zugriff und Konsistenz füllen eine Lücke, die Newman und Fundamentals offenlassen.
- Präzise Begriffe: Architekturquant, statische und dynamische Kopplung, semantische und Implementierungskopplung, die acht Sagas.
- Die Fallgeschichte: Sie macht abstrakte Abwägungen anschaulich und zeigt, wie Teams Entscheidungen gemeinsam treffen und mit ADRs festhalten.
- Data Mesh aus erster Hand.
Kritikpunkte
1. Anstrengend. Abwägungen ohne Auflösung sind anspruchsvoll zu lesen. Wer klare Empfehlungen sucht, wird unzufrieden sein.
2. Die Fallgeschichte trägt nicht immer. Die erzählten Szenen sind teils künstlich; manche Leser empfinden sie als Füllstoff.
3. Die Saga-Namen. Die einprägsamen Namen sind beliebt, aber nicht in der Branche etabliert. Außerhalb von Lesern des Buchs versteht man unter „Fairy Tale Saga“ nichts.
4. Wenig Code und Werkzeuge. Wie man Sagas, Outboxes oder Datenprodukte konkret baut, bleibt anderen Quellen überlassen.
5. Verteilte Systeme als Ausgangspunkt. Das Buch setzt voraus, dass man verteilt; die Frage, ob ein modularer Monolith reicht, kommt im Zerlegungsteil vor, danach kaum noch.
Gesamturteil
The Hard Parts ist das Buch für den Moment, in dem ein Team merkt, dass Microservices vor allem ein Datenproblem sind. Es baut direkt auf Fundamentals auf und ergänzt Newman und Kleppmann. Wer es gelesen hat, stellt bessere Fragen, auch wenn er die Antworten weiterhin selbst finden muss.
Bezüge zur Reihe
| Thema in The Hard Parts | Bezug in der Reihe |
|---|---|
| Keine Best Practices, nur Abwägungen | Richards und Ford: erstes Gesetz; McConnell; Ousterhout |
| Architekturquant präzisiert | Richards und Ford; Accelerate: unabhängig auslieferbar; Newman |
| Statische und dynamische Kopplung | Richards und Ford: Konnaszenz; Beck: Kopplung relativ zur Änderung |
| Semantische und Implementierungskopplung | Brooks: wesentliche und zufällige Komplexität |
| Komponentenbasierte Zerlegung | Martin: Komponentenprinzipien; Feathers; Newman: Strangler Fig |
| Domänendienste als Zwischenschritt | Richards und Ford: service-basiert; Newman: grob anfangen |
| Daten aufteilen, Datendomänen | Sadalage: Refactoring Databases; Evans: Bounded Contexts |
| Zerlegungs- und Zusammenhaltstreiber | Martin: Common Closure; Newman: andere Kriterien |
| Wiederverwendungsmuster | Richards und Ford, 2. Aufl.: Architekturmuster; Newman: gemeinsamer Code |
| Datenbesitz und Delegieren | Evans: Context Map; Fowler PoEAA |
| Spaltenreplikation | Kleppmann: abgeleitete Daten |
| Outbox, Ereignisse | Hohpe und Woolf: Transactional Client; Kleppmann |
| Acht Sagas | Newman: zwei Varianten; Hohpe: Starbucks; Kleppmann: Konsistenz |
| Strenge und lockere Verträge | Newman: Tolerant Reader, Pact; Hohpe und Woolf: Format Indicator |
| Data Mesh | Team Topologies; Evans |
| ADRs und Fitness Functions | Nygard; Richards und Ford |
Diskussionsfragen
- Quanten: Wie viele Architekturquanten hat euer System nach der präzisierten Definition, und wie viele Dienste?
- Daten: Teilen sich bei euch Dienste ein Schema oder Tabellen? Welche der vier Techniken für geteilten Besitz passt?
- Granularität: Welcher eurer Dienste ist zu groß oder zu klein? Welche Kräfte sprechen jeweils dafür und dagegen?
- Sagas: Welcher der acht Sagas entsprechen eure verteilten Abläufe? Gibt es eine Horror Story?
- Zustand oder Ausgleich: Behandelt ihr Fehler in Abläufen eher durch Ausgleichsaktionen oder durch Zwischenzustände, die Menschen klären?
- Verträge: Eher streng oder locker? Wie geht ihr mit Änderungen um?
- Analytische Daten: Data Warehouse, Data Lake oder Data Mesh: was trifft auf euer Unternehmen zu?
- Weiter: Als Nächstes Building Evolutionary Architectures, das Fitness Functions ausführlich behandelt.