Site Reliability Engineering – Zusammenfassung und Einordnung
Betsy Beyer, Chris Jones, Jennifer Petoff, Niall Richard Murphy (Hrsg.), Site Reliability Engineering: How Google Runs Production Systems (2016)
Einleitung
Nach Release It!, das beschreibt, wie man Systeme baut, die im Betrieb nicht umfallen, ist dies das Buch darüber, wie man sie betreibt. Es beschreibt, wie Google seit 2003 die Zuverlässigkeit seiner Dienste organisiert: mit Softwareingenieuren statt klassischen Administratoren, mit messbaren Zielen statt Bauchgefühl und mit einem Fehlerbudget, das den ewigen Streit zwischen Entwicklung und Betrieb in eine Rechnung verwandelt.
Herkunft und Form
Das Buch erschien 2016 bei O’Reilly, herausgegeben von Betsy Beyer, Chris Jones, Jennifer Petoff und Niall Richard Murphy. Es ist ein Sammelband: Die 34 Kapitel stammen von verschiedenen Google-Ingenieuren und unterscheiden sich in Stil, Tiefe und Qualität. Google stellt den vollständigen Text kostenlos auf sre.google bereit.
Die Idee geht auf Ben Treynor Sloss zurück, der das erste SRE-Team bei Google 2003 aufbaute. Sein bekannter Satz, sinngemäß: SRE ist das, was passiert, wenn man einen Softwareingenieur bittet, ein Betriebsteam zu entwerfen.
Zwei Folgebände ergänzen das Buch: The Site Reliability Workbook von 2018 mit praktischen Anleitungen, auch außerhalb von Google, und Building Secure and Reliable Systems von 2020 über Sicherheit.
Aufbau
| Teil | Kapitel | Inhalt |
|---|---|---|
| I. Einführung | 1–2 | was SRE ist, Googles Produktionsumgebung |
| II. Prinzipien | 3–9 | Risiko, Service Level Objectives, Toil, Monitoring, Automatisierung, Release Engineering, Einfachheit |
| III. Praktiken | 10–27 | Alarme, Bereitschaft, Fehlersuche, Störungsmanagement, Postmortems, Tests, Lastverteilung, Überlast, Kaskaden, Konsens, Datenpipelines, Datenintegrität, Produkteinführungen |
| IV. Management | 28–32 | Einarbeitung, Unterbrechungen, Zusammenarbeit, Modelle der Einbindung |
| V. Schlussfolgerungen | 33–34 | Lehren aus anderen Branchen |
Mit rund 550 Seiten ist das Buch umfangreich; viele Kapitel lassen sich einzeln lesen. Teil II ist der wichtigste und für Teams außerhalb von Google am leichtesten zu übertragen.
Was SRE ist
Das klassische Problem
In vielen Unternehmen arbeiten zwei Gruppen mit gegensätzlichen Zielen: Entwicklung will schnell neue Funktionen ausliefern. Betrieb will, dass nichts kaputtgeht, und jede Änderung ist ein Risiko. Das Ergebnis sind Freigabegremien, Änderungssperren, lange Checklisten und gegenseitiges Misstrauen. Außerdem wächst der Betriebsaufwand linear mit dem System: Mehr Server bedeuten mehr Administratoren.
Googles Antwort
SRE-Teams bestehen aus Softwareingenieuren, die Betrieb als Softwareproblem behandeln. Statt Aufgaben manuell zu erledigen, schreiben sie Software, die sie erledigt. Das Ziel: Der Aufwand für den Betrieb soll langsamer wachsen als das System.
Die Grundsätze
| Grundsatz | Inhalt |
|---|---|
| Höchstens 50 Prozent Betriebsarbeit | SREs verbringen höchstens die Hälfte ihrer Zeit mit Tickets, Bereitschaft und manueller Arbeit; der Rest geht in Engineering, das den Betrieb verbessert. Wird die Grenze überschritten, gehen Aufgaben an das Entwicklungsteam zurück. |
| Fehlerbudgets | Ein Dienst muss nicht zu hundert Prozent verfügbar sein; die erlaubte Unzuverlässigkeit ist ein Budget, das die Entwicklung für Risiken ausgeben darf. |
| Monitoring für Menschen | Alarme nur, wenn ein Mensch sofort handeln muss; alles andere sind Tickets oder Protokolle. |
| Notfallreaktion | Zuverlässigkeit hängt von der mittleren Zeit bis zur Wiederherstellung ab; Handbücher und Übungen verkürzen sie. |
| Änderungsmanagement | Die meisten Ausfälle entstehen durch Änderungen; schrittweise Auslieferung, schnelle Erkennung und sichere Rücknahme sind Pflicht. |
| Bedarfsplanung und Bereitstellung | Kapazität wird vorausgeplant, getestet und automatisch bereitgestellt. |
| Effizienz und Leistung | Kapazität kostet Geld; SREs achten auf Auslastung und Leistung. |
SRE und DevOps
Das Buch erschien, als DevOps bereits verbreitet war. Spätere Google-Veröffentlichungen beschreiben das Verhältnis so: DevOps ist eine Kultur und Haltung, SRE eine konkrete Umsetzung davon, oft mit dem Bild, SRE verhalte sich zu DevOps wie eine Klasse zu einem Interface. Beide teilen die Ziele: gemeinsame Verantwortung, Automatisierung, Messung, kleine Änderungen.
Einordnung
Die 50-Prozent-Grenze ist Becks Unterscheidung von Verhalten und Struktur, angewandt auf Betrieb: Wer nur Tickets abarbeitet, verbessert nie das System. Das Änderungsmanagement ist Continuous Delivery aus Betriebssicht, und die Notfallreaktion entspricht Accelerates Kennzahl der Wiederherstellungszeit.
Risiko akzeptieren
Das dritte Kapitel enthält die vielleicht wichtigste Idee des Buchs: Hundert Prozent Verfügbarkeit ist das falsche Ziel.
Warum nicht hundert Prozent?
- Nutzer merken den Unterschied nicht: Wer über ein Mobilfunknetz mit 99 Prozent Zuverlässigkeit zugreift, bemerkt nicht, ob der Dienst 99,99 oder 99,999 Prozent erreicht.
- Jede weitere Neun ist teurer: Mehr Redundanz, mehr Rechenzentren, mehr Tests, langsamere Änderungen. Die Kosten steigen ungefähr exponentiell.
- Zuverlässigkeit konkurriert mit Geschwindigkeit: Wer nichts ändert, hat die wenigsten Ausfälle, aber auch keine neuen Funktionen.
Das richtige Ziel hängt davon ab, was Nutzer brauchen und was sie bezahlen. Ein interner Batch-Dienst braucht weniger als ein Zahlungssystem.
Was eine Neun bedeutet
Zur Einordnung die erlaubte Ausfallzeit pro 30-Tage-Monat:
| Verfügbarkeit | Erlaubte Ausfallzeit pro Monat |
|---|---|
| 99 % | etwa 7,2 Stunden |
| 99,9 % | etwa 43 Minuten |
| 99,95 % | etwa 22 Minuten |
| 99,99 % | etwa 4,3 Minuten |
| 99,999 % | etwa 26 Sekunden |
Google misst Verfügbarkeit meist nicht als Zeit, sondern als Anteil erfolgreicher Anfragen: Bei 99,9 Prozent darf eine von tausend Anfragen fehlschlagen. Das passt besser zu verteilten Systemen, die selten ganz ausfallen, sondern teilweise.
Fehlerbudgets
Aus dem Zuverlässigkeitsziel ergibt sich direkt ein Fehlerbudget: Bei einem Ziel von 99,9 Prozent ist das Budget 0,1 Prozent, also die Unzuverlässigkeit, die man sich leisten darf.
Wie es funktioniert
- Produktverantwortliche und SRE einigen sich auf ein Zuverlässigkeitsziel für einen Dienst.
- Die tatsächliche Zuverlässigkeit wird fortlaufend gemessen.
- Solange Budget übrig ist, darf das Entwicklungsteam ausliefern, experimentieren und Risiken eingehen.
- Ist das Budget aufgebraucht, werden riskante Auslieferungen gestoppt, bis die Zuverlässigkeit wieder im Rahmen liegt; das Team arbeitet an Stabilität.
Warum das wirkt
Das Fehlerbudget löst den Konflikt zwischen Entwicklung und Betrieb, weil beide dasselbe Ziel haben. Entwickler haben ein Interesse an Zuverlässigkeit, weil sie sonst nicht ausliefern dürfen. SREs haben kein Interesse daran, Änderungen zu verhindern, solange das Budget reicht. Die Entscheidung, ob eine riskante Auslieferung stattfindet, wird von einer Meinungsfrage zu einer Rechnung.
Auch Ausfälle, die nicht vom Team verursacht wurden, etwa durch einen Cloud-Anbieter, verbrauchen das Budget. Das schafft einen Anreiz, sich gegen solche Ausfälle abzusichern.
Einordnung
Das Fehlerbudget ist eine institutionalisierte Form von Becks Abwägung zwischen Zeitwert und Optionswert. Accelerate hat gezeigt, dass Geschwindigkeit und Stabilität nicht im Gegensatz stehen müssen; das Fehlerbudget ist ein Mechanismus, beides zu steuern.
Service Level Objectives
Das vierte Kapitel führt drei Begriffe ein, die heute weit über Google hinaus Standard sind.
| Begriff | Bedeutung | Beispiel |
|---|---|---|
| SLI Service Level Indicator | eine gemessene Größe, die Zuverlässigkeit aus Nutzersicht beschreibt | Anteil der Anfragen, die in unter 300 ms erfolgreich beantwortet werden |
| SLO Service Level Objective | ein Zielwert für einen SLI über einen Zeitraum | 99,5 % der Anfragen in einem rollierenden 28-Tage-Fenster |
| SLA Service Level Agreement | ein Vertrag mit Konsequenzen, etwa Gutschriften, wenn das Ziel verfehlt wird | 99 % Verfügbarkeit, sonst 10 % Rückerstattung |
SLOs sind interne Ziele und liegen bewusst strenger als SLAs, damit man reagieren kann, bevor vertragliche Folgen eintreten.
Die richtigen SLIs
Welche Indikatoren passen, hängt von der Art des Dienstes ab:
| Art des Dienstes | Typische SLIs |
|---|---|
| Nutzerorientiert, Anfrage und Antwort | Verfügbarkeit, Latenz, Durchsatz |
| Speichersysteme | Latenz, Verfügbarkeit, Dauerhaftigkeit |
| Datenpipelines | Aktualität, Korrektheit, Durchsatz |
Für Latenz empfiehlt das Buch Perzentile statt Durchschnitte: Ein Durchschnitt von 50 ms kann bedeuten, dass ein Prozent der Nutzer fünf Sekunden wartet. Das 99. Perzentil zeigt, was die unglücklichsten Nutzer erleben.
Ratschläge für SLOs
- Nicht nach der heutigen Leistung wählen, sondern nach dem, was Nutzer brauchen.
- Einfach halten: wenige SLOs pro Dienst, die jeder versteht.
- Keine absoluten Ziele wie „immer verfügbar“.
- Lieber mit lockeren Zielen beginnen und verschärfen; ein zu strenges Ziel lässt sich schwer wieder lockern.
- Nicht übererfüllen: Ein Dienst, der viel zuverlässiger ist als zugesagt, erzeugt Abhängigkeiten, die beim ersten Ausfall wehtun. Das Buch berichtet, dass Google für seinen Sperrdienst Chubby gezielt geplante Ausfälle einbaute, damit andere Dienste nicht stillschweigend von einer zu hohen Verfügbarkeit abhängig wurden.
In Java messen
// Latenz-SLI mit Micrometer: Histogramm mit SLO-Grenze für Prometheus
@Bean
MeterFilter checkoutSlo() {
    return new MeterFilter() {
        @Override public DistributionStatisticConfig configure(Meter.Id id, DistributionStatisticConfig cfg) {
            if (!id.getName().equals("http.server.requests")) return cfg;
            return DistributionStatisticConfig.builder()
                .percentilesHistogram(true)
                .serviceLevelObjectives(Duration.ofMillis(300).toNanos())   // Grenze für den SLI
                .build().merge(cfg);
        }
    };
}
# SLI in PromQL: Anteil erfolgreicher Checkout-Anfragen unter 300 ms über 28 Tage
sum(rate(http_server_requests_seconds_bucket{uri="/checkout",status!~"5..",le="0.3"}[28d]))
/
sum(rate(http_server_requests_seconds_count{uri="/checkout"}[28d]))
Einordnung
SLOs sind die messbare Form dessen, was Richards und Ford Architekturmerkmale nennen, und eine kontinuierliche, ganzheitliche Fitness Function im Sinne von Building Evolutionary Architectures. Nygards Warnung, sich auf Durchschnitte zu verlassen, findet hier ihre Antwort.
Toil
Das Buch führt einen Begriff ein, für den es im Deutschen kein gutes Wort gibt: Toil, etwa „Plackerei“. Gemeint ist Betriebsarbeit mit diesen Eigenschaften:
| Eigenschaft | Bedeutung |
|---|---|
| Manuell | ein Mensch führt sie aus |
| Wiederholt | sie kommt immer wieder |
| Automatisierbar | eine Maschine könnte sie erledigen |
| Taktisch | sie reagiert auf etwas, statt etwas zu verbessern |
| Ohne bleibenden Wert | danach ist das System nicht besser als vorher |
| Wächst linear | doppelt so viele Dienste bedeuten doppelt so viel Arbeit |
Nicht jede Betriebsarbeit ist Toil: Besprechungen, Planung und Störungsanalyse sind Aufwand, aber kein Toil. Toil ist das, was ein Skript erledigen könnte.
Warum Toil schadet: Es bremst die Karriere, weil man nichts Neues lernt; es senkt die Moral; es verlangsamt das Team; und es setzt Erwartungen, die man später schwer zurücknimmt. Daher die 50-Prozent-Grenze.
Automatisierung
Das siebte Kapitel beschreibt Googles Weg der Automatisierung in Stufen, hier vereinfacht:
| Stufe | Beispiel |
|---|---|
| Keine Automatisierung | Datenbank-Failover von Hand |
| Externe Skripte für ein System | ein Skript, das ein Team für seine Datenbank pflegt |
| Externe, allgemeine Automatisierung | ein Werkzeug für alle Datenbanken |
| Interne Automatisierung | die Datenbank bringt ihren Failover selbst mit |
| System braucht keine Automatisierung | die Datenbank erkennt und behebt Ausfälle selbstständig |
Das Ziel ist die letzte Stufe: Systeme, die sich selbst reparieren, statt dass Werkzeuge sie von außen reparieren.
Das Buch warnt aber auch vor den Gefahren: Automatisierung, die Fehler macht, macht sie schnell und überall. Es beschreibt einen Vorfall, bei dem ein Werkzeug zur Stilllegung von Maschinen durch einen Fehler sehr viele Maschinen auf einmal zur Löschung vorsah. Automatisierung braucht deshalb Schutzmechanismen, etwa Ratenbegrenzung und Plausibilitätsprüfungen.
Release Engineering
Zuverlässige Auslieferung erfordert hermetische Builds, die unabhängig von der Build-Maschine immer dasselbe Ergebnis liefern, Selbstbedienung für Teams, hohe Frequenz und automatisch durchgesetzte Regeln, etwa wer was freigeben darf. Das ist Continuous Delivery aus Googles Sicht; Googles Build-System Bazel ist aus dieser Arbeit entstanden.
Einfachheit
Das kurze neunte Kapitel ist eines der schönsten des Buchs. Seine Thesen:
- Langweilige Software ist gut. Überraschungen im Betrieb sind fast immer schlecht.
- Wesentliche und zufällige Komplexität unterscheiden, wie Brooks, und die zufällige konsequent bekämpfen.
- Code löschen ist ein Gewinn. Jede Zeile, die nicht existiert, kann keinen Fehler enthalten. Das Buch spricht von negativen Codezeilen als Leistung.
- Minimale Schnittstellen, wie Ousterhouts tiefe Module.
- Kleine, häufige Releases, weil sie einfacher zu verstehen und zurückzunehmen sind.
Zuverlässigkeit beginnt nicht im Betrieb, sondern beim Entwurf.
Monitoring
Wozu?
Das Buch nennt mehrere Zwecke: langfristige Trends erkennen, Versionen und Konfigurationen vergleichen, Alarme auslösen, Dashboards bereitstellen und bei der Fehlersuche helfen. Es unterscheidet zwei Arten:
- White-Box-Monitoring: Metriken aus dem Inneren eines Systems, etwa Warteschlangenlängen oder Cache-Trefferquoten.
- Black-Box-Monitoring: Prüfungen von außen, so wie ein Nutzer das System erlebt.
Die vier goldenen Signale
Wer nur vier Dinge misst, sollte diese messen:
| Signal | Bedeutung |
|---|---|
| Latenz | wie lange Anfragen dauern; erfolgreiche und fehlerhafte getrennt, weil schnelle Fehler den Durchschnitt schönen |
| Verkehr | wie viel Last anliegt, etwa Anfragen pro Sekunde |
| Fehler | Anteil fehlgeschlagener Anfragen, auch solcher, die technisch erfolgreich, aber fachlich falsch sind |
| Sättigung | wie voll das System ist, etwa Speicher, CPU, Verbindungspools; oft der Frühindikator |
Die vier goldenen Signale sind zu einem Standard geworden. Verwandte Ansätze sind RED von Tom Wilkie für Dienste, Rate, Errors, Duration, und USE von Brendan Gregg für Ressourcen, Utilization, Saturation, Errors.
Symptome und Ursachen
Eine zentrale Unterscheidung: Was ist kaputt? ist das Symptom, etwa „Checkout liefert Fehler“. Warum? ist die Ursache, etwa „Datenbankverbindungen erschöpft“. Alarme sollen auf Symptome reagieren, weil Nutzer Symptome erleben; Ursachen-Metriken helfen bei der Fehlersuche, sollten aber selten wecken.
Regeln für Alarme
Das Buch formuliert strenge Anforderungen an Alarme, die einen Menschen rufen:
- Jeder Alarm erfordert sofortiges Handeln. Was bis morgen warten kann, ist ein Ticket.
- Jeder Alarm erfordert menschliches Urteil. Was ein Skript beheben kann, sollte ein Skript beheben.
- Jeder Alarm betrifft ein neues Problem oder ein Ereignis, das man so noch nicht kannte.
- Alarme, die regelmäßig ignoriert werden, werden gelöscht oder geändert.
Das Ziel ist, Alarmmüdigkeit zu vermeiden: Wer zu oft geweckt wird, reagiert irgendwann nicht mehr.
Alarme auf SLOs
Das Workbook von 2018 entwickelt die Idee weiter zu Alarmen auf die Verbrauchsrate des Fehlerbudgets: Man wird geweckt, wenn das Budget so schnell verbraucht wird, dass es vor Ende des Zeitraums aufgebraucht wäre. Das verbindet Monitoring direkt mit den Zielen aus dem vorigen Abschnitt.
Werkzeuge
Googles internes System Borgmon, das ein eigenes Kapitel bekommt, war Vorbild für Prometheus, das heute in der Java-Welt über Micrometer und Spring Boot Actuator Standard ist.
Bereitschaft
Das Buch behandelt Rufbereitschaft als etwas, das man gestalten muss, nicht als Last, die man aushält.
- Menge begrenzen: Google strebt an, dass SREs höchstens etwa ein Viertel ihrer Zeit in Bereitschaft sind und dass es pro Schicht nur wenige Vorfälle gibt, damit jeder gründlich bearbeitet und nachbereitet werden kann.
- Qualität sichern: Wer gerufen wird, braucht Zeit, Handbücher und Unterstützung.
- Gerecht ausgleichen: Bereitschaft wird bezahlt oder mit Freizeit ausgeglichen.
- Sicherheit vermitteln: Wer gerufen wird, soll sich nicht allein fühlen und wissen, wen er hinzuziehen kann.
- Weder Überlast noch Unterforderung: Zu viele Vorfälle führen zu Erschöpfung; zu wenige dazu, dass niemand mehr weiß, was im Ernstfall zu tun ist. Dagegen helfen Übungen.
Fehlersuche
Das Kapitel beschreibt Fehlersuche als hypothesengetriebenes Vorgehen: Problem beschreiben, Systemzustand untersuchen, Hypothesen aufstellen, sie prüfen, behandeln, Ergebnis beobachten. Häufige Fallen: auf irrelevante Symptome schauen, Zusammenhänge mit Ursachen verwechseln, an der ersten Hypothese festhalten. Thomas‘ und Hunts Debugging-Kapitel beschreibt dasselbe für Code.
Störungsmanagement
Für größere Störungen übernimmt Google Rollen aus dem Incident Command System, das Feuerwehren und Katastrophenschutz verwenden:
| Rolle | Aufgabe |
|---|---|
| Incident Commander | behält den Überblick, verteilt Aufgaben, entscheidet; arbeitet nicht selbst am Problem |
| Operations Lead | führt die technischen Maßnahmen aus, gemeinsam mit seinem Team |
| Communications Lead | informiert Beteiligte und Betroffene regelmäßig |
| Planning Lead | kümmert sich um alles Langfristige: Tickets, Übergaben, Ressourcen |
Dazu gehören ein gemeinsames, laufend aktualisiertes Störungsdokument, klare Übergaben bei Schichtwechseln und die Regel, eine Störung früh auszurufen. Wer zu lange allein versucht, ein Problem zu lösen, verliert wertvolle Zeit.
Postmortems
Nach jeder bedeutenden Störung wird ein Postmortem geschrieben. Anlässe sind etwa für Nutzer sichtbare Ausfälle über einer Schwelle, Datenverlust, Eingriffe der Bereitschaft wie Rücknahmen, ungewöhnlich lange Behebungszeiten oder Fehler im Monitoring selbst.
Schuldfrei
Das wichtigste Merkmal: Postmortems sind schuldfrei. Sie fragen, wie das System einen Fehler ermöglicht hat, nicht wer ihn gemacht hat. Wer Angst vor Schuldzuweisung hat, verschweigt Informationen, und dann lernt niemand etwas.
Inhalt
- Zeitlinie der Ereignisse
- Auswirkungen auf Nutzer und Geschäft
- Ursachen und auslösende Faktoren
- Was gut lief, was schlecht lief, wo man Glück hatte
- Maßnahmen mit Verantwortlichen und Fristen
Postmortems werden geprüft, geteilt und gesammelt, damit andere Teams daraus lernen. Google zeichnet ausgewählte Postmortems sogar aus.
Einordnung
Schuldfreie Postmortems sind die praktische Form der generativen Kultur nach Westrum, die Accelerate als Merkmal leistungsfähiger Organisationen belegt. Nygard beschreibt dieselbe Haltung in seinen Fallstudien.
Zuverlässige Systeme bauen
Ein großer Teil von Teil III behandelt technische Muster. Viele sind aus Release It! bekannt, hier aus der Erfahrung mit Systemen in Googles Größenordnung.
Überlast
- Grenzen pro Kunde: Kein einzelner Aufrufer darf die gesamte Kapazität verbrauchen.
- Drosselung beim Client: Ein Client, der merkt, dass der Server viele seiner Anfragen ablehnt, sendet von sich aus weniger. Das Buch beschreibt dafür ein adaptives Verfahren, das das Verhältnis von gesendeten zu angenommenen Anfragen beobachtet.
- Kritikalität: Anfragen tragen eine Wichtigkeit; bei Überlast werden zuerst die unwichtigen abgelehnt.
- Wiederholungsbudgets: Wiederholungen werden pro Anfrage und pro Client begrenzt, damit sie eine Überlast nicht verstärken.
Kaskadenausfälle
Das 22. Kapitel ist eine der besten Darstellungen von Kaskadenausfällen: Ein überlasteter Server wird langsam, Clients wiederholen ihre Anfragen, die Last steigt weiter, der Server fällt aus, seine Last verteilt sich auf die übrigen, die dann ebenfalls ausfallen.
| Ursache | Gegenmaßnahme |
|---|---|
| Erschöpfte Ressourcen: CPU, Speicher, Threads, Dateideskriptoren | Lasttests bis zum Ausfall; wissen, wo die Grenze liegt |
| Unkontrollierte Wiederholungen | exponentielles Zurückweichen mit Zufallsanteil; Wiederholungsbudgets |
| Fehlende Fristen | Fristen weiterreichen: Jeder nachgelagerte Aufruf erhält die verbleibende Zeit, nicht eine neue |
| Langsamer Start, kalte Caches | Server langsam hochfahren; Caches vorwärmen |
| Überlast ohne Abwehr | Last abwerfen; eingeschränkt antworten statt gar nicht |
// Fristen weiterreichen und mit Bedacht wiederholen
OrderView load(OrderId id, Instant deadline) {
    var retry = Retry.of("inventory", RetryConfig.custom()
        .maxAttempts(3)
        .intervalFunction(IntervalFunction.ofExponentialRandomBackoff(100, 2.0, 0.5))  // mit Zufallsanteil
        .retryOnException(e -> e instanceof TransientException)
        .build());

    return Retry.decorateSupplier(retry, () -> {
        var remaining = Duration.between(Instant.now(), deadline);
        if (remaining.isNegative()) throw new DeadlineExceeded();                    // nicht weiter versuchen
        return inventory.fetch(id, remaining);                                       // Rest-Frist mitgeben
    }).get();
}
Konsens
Für kritischen Zustand, etwa wer gerade Leader ist, setzt Google auf verteilten Konsens mit Paxos. Das Kapitel ist eine praktische Ergänzung zu Kleppmanns theoretischer Darstellung von Raft und Paxos.
Datenintegrität
Ein Satz aus dem Kapitel bringt es auf den Punkt, sinngemäß: Niemand will Backups, alle wollen Wiederherstellungen. Ein Backup, dessen Wiederherstellung nie getestet wurde, ist eine Hoffnung, kein Schutz. Das Buch beschreibt drei Schutzschichten:
| Schicht | Schutz gegen |
|---|---|
| Weiches Löschen | versehentliches Löschen durch Nutzer oder Fehler im Code; Daten bleiben eine Zeit lang wiederherstellbar |
| Backups mit getesteter Wiederherstellung | größere Datenverluste, auch durch fehlerhafte Software |
| Replikation | Ausfall von Hardware oder Rechenzentren; schützt aber nicht vor Fehlern, die sich mitreplizieren |
Der letzte Punkt ist wichtig: Replikation verteilt auch Fehler. Ein Bug, der Daten zerstört, zerstört sie in allen Repliken.
Die Bedürfnispyramide der Zuverlässigkeit
Das Buch ordnet seine Praktiken in eine Pyramide nach dem Vorbild von Maslow, die auf Mikey Dickerson zurückgeht. Jede Stufe setzt die darunterliegenden voraus.
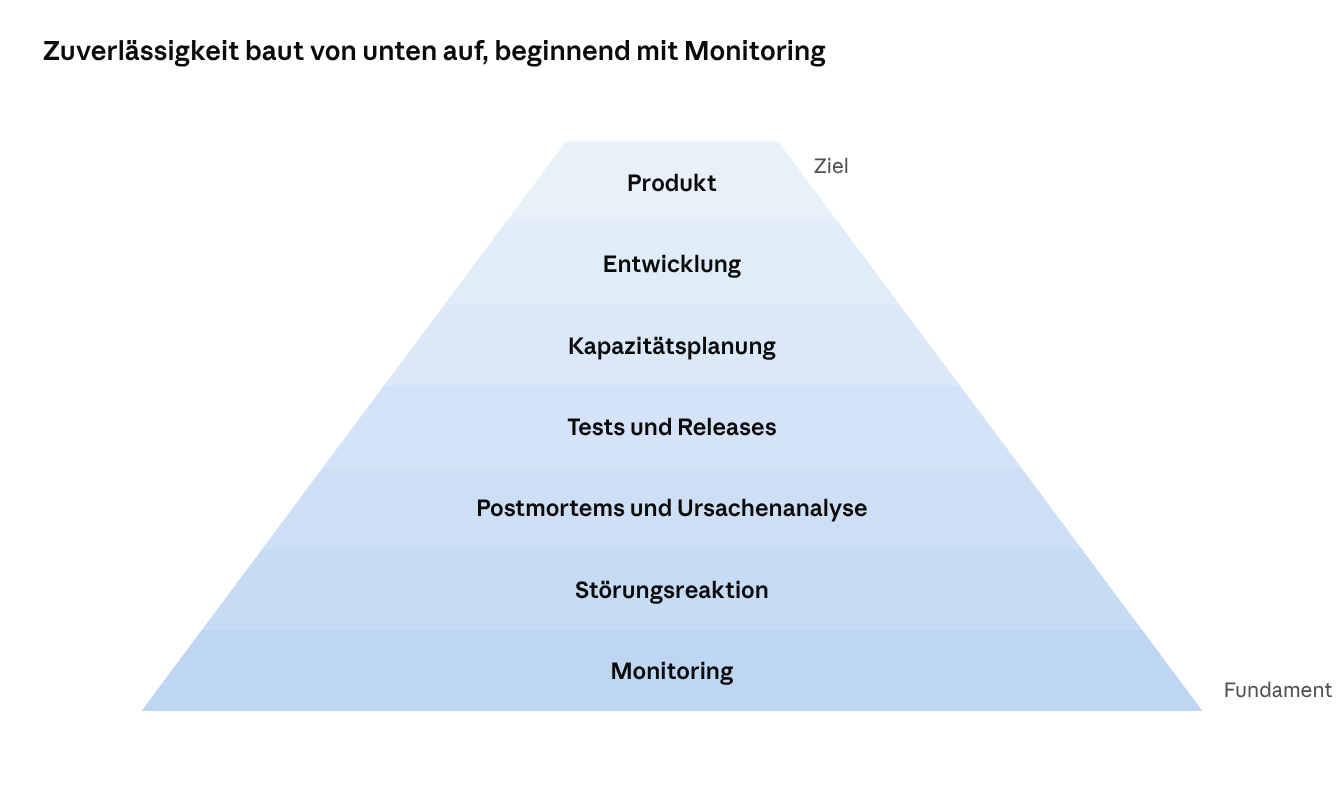
die Bedürfnispyramide der Zuverlässigkeit nach Mikey Dickerson, wie sie das Buch verwendet
- Monitoring ist das Fundament: Ohne Messung weiß man nicht, ob ein Dienst funktioniert.
- Störungsreaktion setzt voraus, dass man Störungen bemerkt.
- Postmortems setzen voraus, dass man Störungen bewältigt hat und lernen kann.
- Tests und Releases verhindern, dass bekannte Fehler wiederkommen.
- Kapazitätsplanung sorgt dafür, dass das System auch morgen trägt.
- Entwicklung im Sinne von SRE bedeutet, Systeme so zu bauen, dass sie zuverlässig sind.
- Produkt ist das Ziel: ein Dienst, der Nutzern zuverlässig nützt.
Die Botschaft: Wer ohne funktionierendes Monitoring an Kapazitätsplanung oder Architektur arbeitet, baut auf Sand.
Organisation
Teil IV behandelt, wie SRE-Teams arbeiten und mit anderen zusammenarbeiten.
| Thema | Inhalt |
|---|---|
| Einarbeitung | neue SREs lernen durch Begleitung erfahrener Kollegen, gestufte Verantwortung und Rollenspiele, in denen vergangene Störungen durchgespielt werden |
| Unterbrechungen | eine Person pro Schicht übernimmt alle Tickets und Anfragen, damit die anderen ungestört arbeiten können |
| Eingebettete SREs | bei überlasteten Teams arbeitet ein SRE einige Wochen mit, um Praktiken zu verbessern, statt Arbeit zu übernehmen |
| Kommunikation | regelmäßige Produktionsbesprechungen mit Entwicklung über Störungen, Kennzahlen und anstehende Änderungen |
| Einbindungsmodelle | SRE übernimmt einen Dienst erst nach einer Production Readiness Review; erfüllt ein Dienst die Anforderungen nicht mehr, kann SRE ihn an die Entwicklung zurückgeben |
Die Möglichkeit, einen Dienst zurückzugeben, ist ein wichtiger Mechanismus: SRE ist kein Abladeplatz für unzuverlässige Software. Die Entwicklung trägt Verantwortung für die Betriebsfähigkeit ihrer Dienste.
Einordnung
Die Production Readiness Review ist eine Form von Nygards Forderung, Betriebsfähigkeit als Anforderung zu behandeln. Die Organisation von SRE als Team, das anderen hilft, statt Arbeit zu übernehmen, entspricht dem Enabling Team aus Team Topologies; die Plattformen, die SRE baut, dem Plattform-Team.
Kritik und Einordnung
Stärken
- Fehlerbudgets: Eine der wirkungsvollsten Ideen der Reihe. Sie verwandeln einen organisatorischen Konflikt in eine messbare Größe.
- SLIs und SLOs: Begriffe, die sich weltweit durchgesetzt haben und Zuverlässigkeit aus Nutzersicht messbar machen.
- Toil als Begriff: Er gibt einem verbreiteten Problem einen Namen und einen Maßstab.
- Schuldfreie Postmortems: eine Praxis, die weit über Google hinaus übernommen wurde.
- Ehrlich über Fehler: Das Buch beschreibt viele eigene Ausfälle und Fehlentscheidungen.
- Frei verfügbar: Der vollständige Text steht kostenlos online.
Kritikpunkte
1. Google ist nicht die Welt. Vieles setzt Googles Größe, eigene Infrastruktur und Personalstärke voraus. Ein Team mit zehn Entwicklern kann kein eigenes SRE-Team mit 50-Prozent-Regel aufbauen. Das Workbook von 2018 versucht, das zu übertragen, und ist für die meisten Leser die praktischere Lektüre.
2. Uneinheitlich. Als Sammelband schwankt das Buch stark in Stil und Tiefe. Einige Kapitel, etwa über Googles interne Werkzeuge, sind für Außenstehende wenig nützlich.
3. Begriffsinflation in der Praxis. Viele Unternehmen haben ihr Betriebsteam in „SRE“ umbenannt, ohne Fehlerbudgets, 50-Prozent-Grenze oder Engineering-Anteil einzuführen. Das ist keine Kritik am Buch, zeigt aber, wie leicht die Ideen verwässert werden.
4. SLOs sind schwerer, als sie aussehen. Das richtige SLI zu finden, Daten verlässlich zu erheben und Fachleute für Fehlerbudgets zu gewinnen, ist aufwendig. Das Buch beschreibt das Ziel klarer als den Weg.
5. Wenig über kleinere Organisationen und regulierte Umgebungen, in denen Fehlerbudgets mit vertraglichen oder gesetzlichen Anforderungen kollidieren können.
Gesamturteil
Das SRE-Buch hat die Sprache der Zuverlässigkeit geprägt: SLO, Fehlerbudget, Toil, goldene Signale, schuldfreies Postmortem. Für die meisten Teams lohnt es sich, die Kapitel 1 bis 6, 9, 11 bis 15, 21, 22 und 26 zu lesen und den Rest bei Bedarf. Für die Umsetzung außerhalb von Google ist das Workbook der bessere Begleiter.
Bezüge zur Reihe
Betrieb in der Reihe
| Buch | Beitrag zum Betrieb |
|---|---|
| Nygard, Release It! | Stabilitätsmuster, Antipatterns, Betriebsfähigkeit als Entwurfsziel |
| Humble und Farley, Continuous Delivery | Pipeline, sichere Auslieferung, Rücknahme |
| Forsgren, Humble, Kim, Accelerate | Daten: Stabilität und Geschwindigkeit gehen zusammen |
| Newman, Building Microservices | Beobachtbarkeit, Resilienz in verteilten Systemen |
| Ford u.a., Building Evolutionary Architectures | Fitness Functions im Betrieb |
| Beyer u.a., Site Reliability Engineering | Ziele, Budgets, Alarme, Störungen, Postmortems, Organisation |
Weitere Bezüge
| Thema bei SRE | Bezug in der Reihe |
|---|---|
| Fehlerbudget | Beck: Zeitwert gegen Optionswert; Accelerate: Geschwindigkeit und Stabilität |
| SLOs als Ziele | Richards und Ford: messbare Architekturmerkmale; Fitness Functions |
| Perzentile statt Durchschnitte | Nygard; Kleppmann: Tail Latency |
| Toil und 50-Prozent-Grenze | Beck: Struktur gegen Verhalten; Team Topologies: kognitive Last |
| Einfachheit, Code löschen | Brooks: zufällige Komplexität; Ousterhout |
| Release Engineering | Humble und Farley |
| Kaskadenausfälle, Wiederholungen, Fristen | Nygard: Timeouts, Circuit Breaker; Newman: Resilienz |
| Überlast, Kritikalität | Nygard: Shed Load, Back Pressure; Goetz u.a.: Sättigungsrichtlinien |
| Konsens | Kleppmann: Raft und Paxos |
| Backups und Wiederherstellung | Kleppmann: Dauerhaftigkeit |
| Schuldfreie Postmortems | Accelerate: Westrum-Kultur |
| Incident Command | Brooks: Chirurgenteam mit klaren Rollen |
| Enabling statt Übernehmen | Team Topologies: Enabling und Plattform-Teams |
Diskussionsfragen
- SLOs: Habt ihr für eure wichtigsten Dienste ausdrückliche Zuverlässigkeitsziele? Wer hat sie festgelegt, und auf welcher Grundlage?
- Fehlerbudget: Was passiert bei euch, wenn ein Dienst häufig ausfällt? Gibt es eine Regel, oder entscheidet das Gefühl?
- Alarme: Wie viele Alarme habt ihr pro Woche, und wie viele davon erfordern wirklich sofortiges Handeln?
- Toil: Welcher Teil eurer wöchentlichen Arbeit ist Toil im Sinne des Buchs? Was wäre am leichtesten zu automatisieren?
- Postmortems: Schreibt ihr sie, und sind sie wirklich schuldfrei? Werden die Maßnahmen umgesetzt?
- Wiederherstellung: Wann habt ihr zuletzt getestet, ob sich ein Backup tatsächlich wiederherstellen lässt?
- Bereitschaft: Wie belastend ist sie? Gibt es Ausgleich, Handbücher und Rückhalt?
- Weiter: Als letztes der 30 Bücher bleibt Peopleware von DeMarco und Lister.