Release It! – Zusammenfassung und Einordnung
Michael T. Nygard, Release It! Design and Deploy Production-Ready Software (2007, 2. Auflage 2018)
Einleitung
Software, die alle Tests besteht, kann in Produktion trotzdem zusammenbrechen. Nygards These: Die meisten Systeme werden für den Test gebaut, nicht für die Produktion. In Produktion gibt es echte Last, echte Nutzer, langsame Partnersysteme, volle Festplatten und Netzwerke, die halb funktionieren. Das Buch beschreibt, wie Systeme dort ausfallen und wie man sie so baut, dass sie es überleben.
Autor und Kontext
Michael Nygard war viele Jahre als Entwickler und Architekt für große Webanwendungen, etwa im Handel und bei Fluggesellschaften, tätig und hat zahlreiche Produktionsausfälle aus erster Hand miterlebt und analysiert. Die Fallstudien im Buch stammen aus dieser Erfahrung.
| 1. Auflage (2007) | 2. Auflage (2018) | |
|---|---|---|
| Umfeld | Rechenzentren, Applikationsserver, J2EE | Cloud, Container, Microservices, Continuous Deployment |
| Neu | – | Kapitel zu Netzwerk und Service Discovery, Control Plane, Sicherheit, Deployment, Versionierung, Chaos Engineering |
| Beibehalten | Stabilitäts-Antipatterns und -Muster, Fallstudien | überarbeitet und ergänzt |
Diese Zusammenfassung bezieht sich auf die zweite Auflage.
Aufbau
| Teil | Inhalt |
|---|---|
| I. Stabilität schaffen | Fallstudie, Antipatterns, Muster |
| II. Für die Produktion entwerfen | Grundlagen, Prozesse, Verbindungen, Control Plane, Sicherheit |
| III. Das System ausliefern | Deployment, Versionen |
| IV. Systemische Probleme lösen | Anpassungsfähigkeit, Chaos Engineering |
Jeder Teil beginnt mit einer Fallstudie eines realen Ausfalls. Die Geschichten sind spannend erzählt und das Bekannteste am Buch.
Grundhaltung
- Fehler passieren. Die Frage ist nicht, ob ein Teil ausfällt, sondern wie sich der Ausfall ausbreitet.
- Ausfälle sind Ketten. Ein großer Ausfall beginnt fast immer mit einem kleinen Fehler, der sich über Verbindungen fortpflanzt. Stabilität heißt, diese Ketten zu unterbrechen.
- Produktion ist die einzige Umgebung, die zählt. Test- und Staging-Umgebungen sind Annäherungen.
- Betreibbarkeit ist ein Feature. Logging, Metriken, Konfiguration und Steuerung sind Teil des Designs, nicht nachträgliche Ergänzungen.
Der Ton ist pragmatisch, oft humorvoll, mit vielen Kriegsgeschichten. Nygard schreibt für Entwickler und Architekten, nicht für Betriebsteams, und will Entwickler dazu bringen, Verantwortung für das Verhalten ihres Codes in Produktion zu übernehmen.
Leben in Produktion
Nygard beginnt mit einer Beobachtung über Projekte: Sie zielen auf das Ende des Projekts, auf das Bestehen der Abnahme, nicht auf die Jahre danach. Dabei verbringt Software die meiste Zeit ihres Lebens in Produktion, und dort entstehen die meisten Kosten.
- Designentscheidungen haben Betriebskosten. Eine Entscheidung, die in der Entwicklung einen Tag spart, kann im Betrieb Jahr für Jahr viel Geld kosten, etwa durch manuelle Eingriffe, Ausfälle oder überdimensionierte Hardware.
- Pragmatische Architektur orientiert sich an den Bedingungen in Produktion, nicht an abstrakten Idealen.
Fallstudie: Die Ausnahme, die eine Fluggesellschaft lahmlegte
Die bekannteste Geschichte des Buchs, hier nacherzählt.
Eine große Fluggesellschaft betrieb einen zentralen Dienst, über den viele andere Systeme, etwa Check-in-Automaten und Schalteranwendungen, Fluginformationen abfragten. Während einer geplanten Umschaltung der Datenbank auf einen Ersatzserver blieben plötzlich alle Check-in-Systeme hängen. Stundenlang konnten Passagiere nicht einchecken.
Die Ursache war ein unscheinbarer Fehler im Code für Datenbankzugriffe:
- Beim Aufräumen nach einer Abfrage, also beim Schließen eines Statements, warf der Treiber wegen der Umschaltung eine Ausnahme.
- Diese Ausnahme verhinderte, dass die Datenbankverbindung an den Pool zurückgegeben wurde.
- Nach und nach waren alle Verbindungen im Pool verloren.
- Neue Anfragen warteten ohne Zeitlimit auf eine freie Verbindung, und alle Threads des Dienstes blockierten.
- Die aufrufenden Systeme warteten wiederum ohne Zeitlimit auf den hängenden Dienst und blockierten ebenfalls.
In Java sieht der Kern des Problems etwa so aus:
// fehlerhaft: wirft stmt.close() eine Ausnahme, wird conn nie zurückgegeben
Connection conn = pool.getConnection();
Statement stmt = null;
try {
    stmt = conn.createStatement();
    … // Abfrage
} finally {
    if (stmt != null) stmt.close();   // kann werfen
    conn.close();                     // wird dann nie erreicht
}

// robuster: try-with-resources schließt alles, auch bei Ausnahmen
try (Connection c = pool.getConnection(); Statement s = c.createStatement()) {
    …
}
// und: Zeitlimit beim Holen einer Verbindung aus dem Pool, etwa connectionTimeout in HikariCP
Die Lektionen
- Ein kleiner Fehler kann ein ganzes Unternehmen stoppen, wenn er sich über Verbindungen ausbreitet.
- Fehlende Zeitlimits verwandeln langsame oder hängende Systeme in eine Kettenreaktion.
- Alle Tests hatten bestanden. Der Fehler trat nur bei einer bestimmten Störung in Produktion auf.
- Die Analyse gelang nur mit Thread-Dumps und Logdateien aus dem laufenden System, ein frühes Plädoyer für Transparenz im Betrieb.
Stabilität verstehen
Nygard unterscheidet in Anlehnung an die Werkstoffkunde:
| Begriff | Bedeutung |
|---|---|
| Impuls | plötzlicher Schock, etwa ein Ansturm nach einer Werbeaktion |
| Belastung | dauerhafte Kraft, etwa ein Partnersystem, das immer langsamer antwortet |
| Fehlerkette | Fault (ein Fehler im Code oder Zustand) → Error (sichtbares falsches Verhalten) → Failure (das System erbringt seinen Dienst nicht) |
Stabilität heißt, Risse am Ausbreiten zu hindern: Ein Fehler soll nicht zu einem Ausfall werden, und ein Ausfall in einem Teil nicht zu einem Ausfall des Ganzen. Das ist Kleppmanns Unterscheidung von Fehler und Ausfall, aus der Sicht des Betriebs.
Stabilitäts-Antipatterns
Nygard beschreibt wiederkehrende Muster, wie Systeme in Produktion ausfallen. Jedes ist ein Weg, auf dem sich ein kleiner Fehler zu einem großen Ausfall ausweitet.
| Antipattern | Was passiert |
|---|---|
| Integration Points | Jede Verbindung zu einem anderen System ist ein Risiko: Sie kann langsam sein, hängen, Unsinn liefern oder das Protokoll verletzen. Nygard nennt sie den häufigsten Killer von Systemen. |
| Chain Reactions | Fällt in einem Cluster ein Knoten aus, verteilt sich seine Last auf die anderen, die dann ebenfalls ausfallen. |
| Cascading Failures | Ein Fehler in einer Schicht pflanzt sich in die aufrufenden Schichten fort, meist über blockierte Threads. |
| Users | Echte Nutzer erzeugen Last, Sitzungen und Muster, die in Tests nicht vorkommen, dazu Bots, Scraper und Angreifer. |
| Blocked Threads | Threads warten auf eine Ressource, die nie frei wird, etwa durch Deadlocks, fehlende Zeitlimits oder Synchronisation. Nach außen sieht das System lebendig aus, tut aber nichts. |
| Self-Denial Attacks | Eine eigene Aktion, etwa eine Werbe-E-Mail mit einem Sonderangebot, erzeugt einen Ansturm, den das System nicht verkraftet. |
| Scaling Effects | Was bei zwei Servern funktioniert, etwa Punkt-zu-Punkt-Kommunikation oder gemeinsame Ressourcen, bricht bei zwanzig zusammen. |
| Unbalanced Capacities | Ein Frontend mit tausend Threads ruft ein Backend auf, das nur hundert gleichzeitige Anfragen verkraftet. |
| Dogpile | Viele Knoten tun gleichzeitig dasselbe, etwa nach einem Neustart oder zur vollen Stunde, und überlasten eine gemeinsame Ressource. |
| Force Multiplier | Automatisierung verstärkt einen Fehler, etwa ein Werkzeug, das fälschlich viele gesunde Knoten als defekt erkennt und abschaltet. |
| Slow Responses | Eine langsame Antwort ist schlimmer als ein schneller Fehler, weil sie Ressourcen beim Aufrufer bindet. |
| Unbounded Result Sets | Eine Abfrage, die im Test zehn Zeilen liefert, liefert in Produktion zehn Millionen. |
Drei, die Java-Entwickler besonders treffen
Blocked Threads. In klassischen Java-Servern mit Thread-Pools ist das die häufigste Ausfallform. Ein synchronized-Block, ein Pool ohne Timeout, ein Aufruf ohne Lesezeitlimit, und alle Threads hängen. Virtual Threads entschärfen die Knappheit an Threads, nicht aber das Warten selbst: Auch Millionen hängender Virtual Threads halten Verbindungen und Speicher fest.
Slow Responses. Ein Partnersystem, das statt in 50 Millisekunden in 30 Sekunden antwortet, ist gefährlicher als eines, das sofort einen Fehler liefert.
Unbounded Result Sets. Eine JPA-Abfrage ohne Begrenzung kann den Speicher der JVM füllen:
// gefährlich: lädt alle Bestellungen eines Großkunden
List<Order> orders = repository.findByCustomerId(id);

// begrenzt: Seiten, Grenzwerte oder Streaming mit fester Größe
Page<Order> page = repository.findByCustomerId(id, PageRequest.of(0, 100));
Der gemeinsame Kern
Fast alle Antipatterns haben eine gemeinsame Ursache: Annahmen, die in Tests stimmen, aber in Produktion nicht. Partnersysteme sind schnell, Datenmengen klein, Nutzer vernünftig, Netzwerke zuverlässig. Das ist Kleppmanns Kapitel über die Probleme verteilter Systeme, aus der Sicht von jemandem, der nachts angerufen wird.
Stabilitätsmuster I
Den Antipatterns stellt Nygard Muster gegenüber, die Fehlerketten unterbrechen. Die ersten sechs sind die bekanntesten und stecken heute in Bibliotheken wie Resilience4j, in Spring Cloud und in Service Meshes wie Istio.
Timeouts
Das einfachste und wichtigste Muster: Jeder Aufruf über eine Grenze bekommt ein Zeitlimit, beim Verbindungsaufbau, beim Lesen und beim Warten auf Ressourcen wie Verbindungspools. Ohne Zeitlimit wird jedes langsame Partnersystem zu einem blockierten eigenen System.
var client = HttpClient.newBuilder()
    .connectTimeout(Duration.ofSeconds(2))
    .build();
var request = HttpRequest.newBuilder(uri)
    .timeout(Duration.ofSeconds(3))          // Zeitlimit für die ganze Anfrage
    .build();
Nygard warnt, dass viele Bibliotheken standardmäßig kein Zeitlimit oder ein unendliches setzen. Man muss sie ausdrücklich konfigurieren.
Circuit Breaker
Der bekannteste Begriff aus dem Buch. Ein Circuit Breaker umhüllt Aufrufe an ein Partnersystem und zählt Fehler. Sind es zu viele, öffnet er sich und lässt Aufrufe sofort scheitern, statt das kranke System weiter zu belasten und eigene Threads zu blockieren.
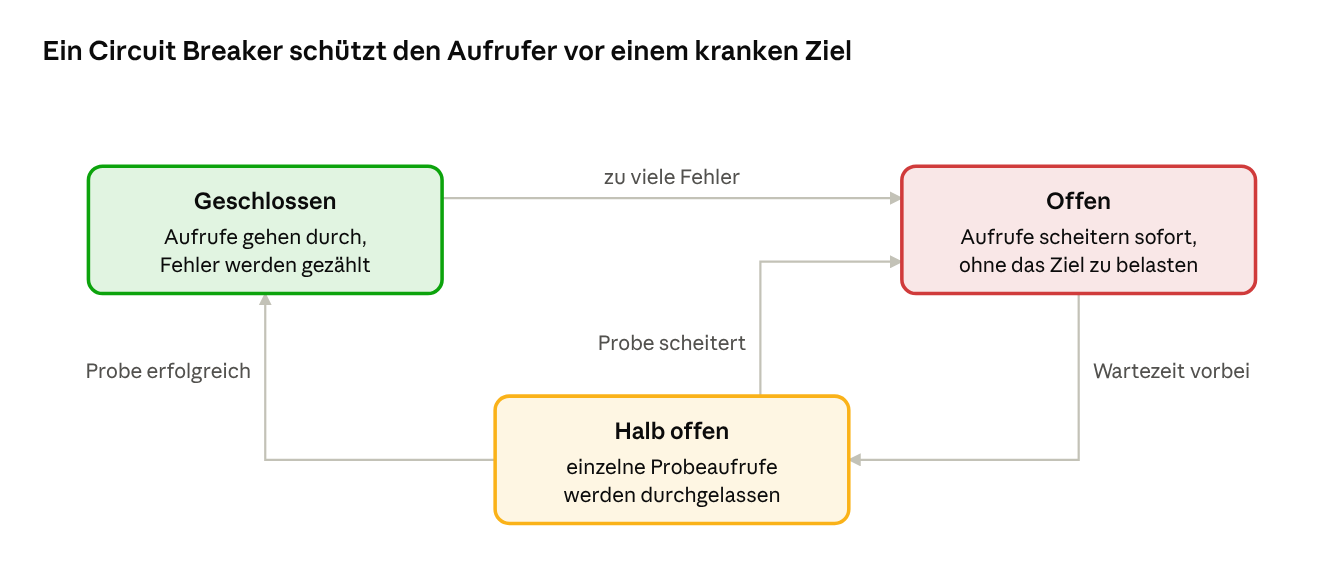
Zustände eines Circuit Breakers · drei Zustände, vier Übergänge
CircuitBreaker breaker = CircuitBreaker.of("pricing", CircuitBreakerConfig.custom()
    .failureRateThreshold(50)                          // ab 50 % Fehlern öffnen
    .waitDurationInOpenState(Duration.ofSeconds(30))  // 30 s offen bleiben
    .permittedNumberOfCallsInHalfOpenState(3)
    .build());

Supplier<Price> guarded = CircuitBreaker.decorateSupplier(breaker, () -> pricing.quote(sku));
Price price = Try.ofSupplier(guarded).recover(e -> Price.unknown()).get();   // Rückfall
Wichtig ist, was bei offenem Breaker passiert: ein Standardwert, ein Wert aus dem Cache, eine eingeschränkte Funktion oder eine klare Fehlermeldung. Das ist eine fachliche Entscheidung, keine technische.
Bulkheads
Der Begriff stammt aus dem Schiffbau: Schotten teilen einen Rumpf in Kammern, damit ein Leck nicht das ganze Schiff flutet. In Software trennt man Ressourcen so, dass ein Problem nur einen Teil betrifft, etwa getrennte Thread-Pools oder Verbindungspools pro Partnersystem. Wenn das Preissystem hängt, sind nur dessen Threads blockiert, die Bestellannahme läuft weiter.
Steady State
Ein System soll ohne menschlichen Eingriff dauerhaft laufen können. Alles, was sich ansammelt, Logdateien, Daten, Sitzungen, Caches, braucht einen Mechanismus, der es wieder entfernt. Nygards Faustregel: Wenn ein Mensch regelmäßig eingreifen muss, wird er es irgendwann vergessen.
Fail Fast
Wenn eine Anfrage absehbar scheitern wird, etwa weil ein benötigtes System nicht erreichbar ist oder Parameter ungültig sind, soll sie sofort scheitern, nicht nach dreißig Sekunden Arbeit. Das schont Ressourcen und gibt dem Aufrufer schnell eine Antwort. Das ist Thomas‘ und Hunts „Tote Programme lügen nicht“ auf Systemebene.
Let It Crash
Aus der Erlang-Welt übernommen: Statt eine Komponente in einem unklaren Zustand zu reparieren, beendet man sie und startet sie sauber neu. Das setzt voraus, dass Komponenten klein, schnell startbar und von einem Überwacher verwaltet sind, etwa Container mit Kubernetes oder Aktoren mit Supervisoren.
Stabilitätsmuster II
Die übrigen Muster behandeln vor allem den Umgang mit Last: wie man sich gegen zu viele Anfragen schützt und wie man Systeme voneinander entkoppelt.
| Muster | Idee |
|---|---|
| Handshaking | Bevor ein Aufrufer Arbeit schickt, fragt er, ob der Empfänger bereit ist. Health Checks, die nicht nur „läuft“, sondern „kann gerade Arbeit annehmen“ melden, sind eine Form davon. |
| Test Harness | Ein eigener Testserver, der sich wie ein schlecht erzogenes Partnersystem verhält: antwortet langsam, gar nicht, mit Unsinn, schließt Verbindungen mitten in der Übertragung. Damit testet man die eigenen Stabilitätsmuster. |
| Decoupling Middleware | Nachrichtenbasierte Kommunikation über Warteschlangen statt synchroner Aufrufe. Sender und Empfänger müssen nicht gleichzeitig verfügbar sein. |
| Shed Load | Wenn mehr Anfragen kommen, als das System verkraftet, lehnt es einige sofort ab, etwa mit HTTP 503, statt alle langsam zu bedienen und dabei unterzugehen. |
| Create Back Pressure | Ein überlasteter Empfänger signalisiert dem Sender, langsamer zu werden, etwa durch begrenzte Warteschlangen, die blockieren oder ablehnen, wenn sie voll sind. |
| Governor | Automatisierung bekommt eine Bremse: Sie darf nicht beliebig schnell beliebig viel tun, etwa höchstens zehn Prozent der Knoten auf einmal neu starten. Das Gegenmittel zum Force Multiplier. |
Test Harness: Fehler gezielt herbeiführen
Nygards Idee eines absichtlich schlechten Testservers ist heute in Werkzeugen wie WireMock oder Toxiproxy verwirklicht:
// WireMock: Partnersystem antwortet erst nach 10 Sekunden
stubFor(get(urlEqualTo("/prices/SKU-1"))
    .willReturn(aResponse().withFixedDelay(10_000).withStatus(200)));

@Test
void fallsBackWhenPricingIsSlow() {
    var price = shop.priceOf("SKU-1");          // Timeout von 3 s muss greifen
    assertThat(price).isEqualTo(Price.unknown());
}
Das ist GOOS‘ „nur eigene Typen mocken“ aus der anderen Richtung: Man prüft den eigenen Adapter gegen eine realistische, aber feindselige Gegenstelle.
Back Pressure in Java
Begrenzte Warteschlangen sind die einfachste Form von Gegendruck:
// unbegrenzt: wächst bis zum OutOfMemoryError
ExecutorService unbounded = Executors.newFixedThreadPool(10);

// begrenzt: Aufrufer bekommt Gegendruck, wenn die Warteschlange voll ist
ExecutorService bounded = new ThreadPoolExecutor(10, 10, 0, TimeUnit.SECONDS,
    new ArrayBlockingQueue<>(100),
    new ThreadPoolExecutor.CallerRunsPolicy());   // Aufrufer arbeitet selbst mit und wird so gebremst
Reactive Streams und Kafka-Consumer setzen Back Pressure auf Protokollebene um.
Muster kombinieren
Nygard betont, dass die Muster zusammenwirken: Timeouts machen Circuit Breaker erst möglich, Bulkheads begrenzen den Schaden, wenn ein Breaker zu spät öffnet, Load Shedding und Back Pressure verhindern, dass ein überlastetes System alle seine Aufrufer mitreißt. Kein einzelnes Muster schützt allein.
Für die Produktion entwerfen (Teil II)
Der zweite Teil ist in der zweiten Auflage weitgehend neu. Nygard geht von unten nach oben durch die Schichten, auf denen ein System läuft, und fragt jeweils, was Entwickler darüber wissen müssen.
Grundlagen: Rechner, virtuelle Maschinen, Container
- Netzwerk: Server haben oft mehrere Netzwerkschnittstellen, etwa für Produktion, Verwaltung und Backups. Code, der an „alle Schnittstellen“ bindet oder den eigenen Hostnamen errät, verhält sich in Produktion anders als auf dem Laptop.
- Virtuelle Maschinen: Uhren können springen, Ressourcen sind geteilt, Maschinen können pausiert und verschoben werden. Das verstärkt die Prozesspausen, die auch Kleppmann beschreibt.
- Container: kurzlebig, ohne lokalen Zustand, jederzeit ersetzbar. Alles, was überleben soll, muss außerhalb des Containers liegen.
Code
- Reproduzierbare Builds, deren Ergebnis ein unveränderliches Artefakt ist, etwa ein Container-Image.
- Keine Änderungen von Hand auf laufenden Servern. Jede Änderung geht durch den Build und das Deployment.
- Dasselbe Artefakt wandert durch alle Umgebungen, nur die Konfiguration ändert sich.
Konfiguration
- Konfiguration ist vom Code getrennt und wird von außen übergeben, etwa über Umgebungsvariablen, Konfigurationsdienste oder eingehängte Dateien.
- Geheimnisse wie Passwörter und Schlüssel gehören nicht in die Versionskontrolle und nicht ins Image, sondern in einen Tresor wie Vault oder die Geheimnisverwaltung der Cloud.
- Benennung nach Funktion, nicht nach Umgebung:
pricing.base-urlstattprod.pricing.url.
Das entspricht weitgehend den „Twelve-Factor App“-Regeln und Thomas‘ und Hunts Kapitel über Konfiguration.
Transparenz
Ein System, dessen Inneres man im Betrieb nicht sieht, kann man nicht betreiben. Nygard unterscheidet:
| Art | Zweck | Beispiel in Java |
|---|---|---|
| Logs | Ereignisse für Menschen und Analysewerkzeuge | strukturiertes Logging mit SLF4J und JSON-Ausgabe |
| Metriken pro Instanz | Zustand eines einzelnen Prozesses: Threads, Speicher, Pools, Antwortzeiten | Micrometer, JVM-Metriken, Pool-Auslastung |
| Systemweite Metriken | Geschäftliche und technische Kennzahlen über alle Instanzen | Bestellungen pro Minute, Fehlerquote, Latenz-Perzentile |
| Health Checks | Ist die Instanz lebendig und bereit, Arbeit anzunehmen? | Spring Boot Actuator, Liveness- und Readiness-Probes |
Zu Logs gibt er praktische Ratschläge: Log-Level bewusst wählen, ERROR nur für Dinge, auf die jemand reagieren muss, Meldungen für den Menschen formulieren, der um drei Uhr nachts aufgeweckt wird, und Kennungen mitschreiben, mit denen sich eine Anfrage über mehrere Systeme verfolgen lässt.
// Readiness, die wirklich prüft, ob Arbeit angenommen werden kann
@Component
class PricingReadiness implements HealthIndicator {
    public Health health() {
        return breaker.getState() == CircuitBreaker.State.OPEN
            ? Health.outOfService().withDetail("pricing", "circuit open").build()
            : Health.up().build();
    }
}
Einordnung
Dieser Teil ist das, was GOOS mit „Logging ist ein Feature“ andeutete, ausgearbeitet für den Betrieb. Und es ist die Grundlage für Accelerates Fähigkeiten „Monitoring“ und „proaktive Benachrichtigung“.
Verbindungen zwischen Systemen
Wie finden Systeme einander, und wie verteilt man Last? Nygard behandelt die Schicht zwischen den Diensten.
- DNS ist einfach und robust, hat aber Tücken: Ergebnisse werden zwischengespeichert, manchmal länger als gedacht. Ältere Java-Versionen speicherten DNS-Ergebnisse unter bestimmten Bedingungen dauerhaft; heute steuert die Einstellung
networkaddress.cache.ttl, wie lange die JVM sie hält. Wer Dienste per DNS umschaltet, muss das kennen. - Load Balancer verteilen Last und erkennen über Health Checks, welche Instanzen gesund sind. Sticky Sessions machen das schwieriger, weil Nutzer an eine Instanz gebunden sind.
- Nachfragesteuerung: Systeme fallen bei zu viel Last oft nicht sanft, sondern abrupt aus. Load Shedding und Back Pressure gehören deshalb an die Grenzen des Systems, in Load Balancer und Gateways.
- Service Discovery über Werkzeuge wie Consul, etcd oder die Mechanismen von Kubernetes. Sie beruhen auf Konsens, wie Kleppmann zeigt, und haben eigene Ausfallarten.
Control Plane
Nygard unterscheidet die Data Plane, die eigentliche Arbeit für Nutzer, von der Control Plane: alles, was das System steuert, überwacht, konfiguriert und ausliefert. Dazu gehören Monitoring, Deployment-Pipelines, Konfigurationsdienste und Automatisierung.
- Mechanischer Hebel: Automatisierung ist ein Hebel, der gute und schlechte Entscheidungen gleichermaßen verstärkt. Nygard erzählt von Ausfällen großer Anbieter, bei denen ein Wartungsskript oder ein Tippfehler in einem Befehl viel mehr Systeme betraf als gedacht. Daher das Governor-Muster.
- Entwicklung ist Produktion: Wenn Build-Server, Repository oder Pipeline ausfallen, kann man keine Fehler mehr beheben. Diese Infrastruktur braucht dieselbe Sorgfalt wie das Produkt.
- Steuerung zur Laufzeit: Ein betreibbares System bietet Stellschrauben, mit denen man im Betrieb eingreifen kann, ohne neu auszuliefern: Feature-Schalter, Circuit Breaker manuell öffnen oder zurücksetzen, Pool-Größen anpassen, Caches leeren, Log-Level ändern.
// Laufzeitsteuerung, etwa über einen geschützten Actuator-Endpunkt
@Endpoint(id = "pricing-breaker")
class PricingBreakerEndpoint {
    @WriteOperation void forceOpen()  { breaker.transitionToForcedOpenState(); }
    @WriteOperation void reset()      { breaker.reset(); }
}
Sicherheit
Das Sicherheitskapitel ist neu in der zweiten Auflage und eher ein Überblick als eine Anleitung:
- OWASP Top 10 als Ausgangspunkt: Injection, fehlerhafte Authentifizierung, Cross-Site-Scripting, unsichere Deserialisierung und andere häufige Schwachstellen. Bloch und Kleppmann warnen ebenfalls vor Java-Serialisierung.
- Minimale Rechte: Jeder Dienst bekommt nur die Rechte, die er braucht, mit eigenen Zugangsdaten statt eines gemeinsamen Superusers.
- Konfigurierte Passwörter gehören in einen Tresor, nicht in Konfigurationsdateien oder Images.
- Sicherheit als laufender Prozess: Abhängigkeiten aktualisieren, Schwachstellen beobachten, Zertifikate erneuern, bevor sie ablaufen. Ein abgelaufenes Zertifikat ist eine der häufigsten selbst verschuldeten Ausfallursachen.
Einordnung
Die Control Plane ist für Java-Entwickler oft ein blinder Fleck: Man schreibt die Anwendung, aber nicht die Stellschrauben, mit denen sie sich im Betrieb steuern lässt. Nygard macht daraus einen Teil des Designs, so wie GOOS Logging zum Feature macht.
Ausliefern (Teil III)
Der dritte Teil beginnt mit einer Fallstudie über ein Deployment, das nur nachts möglich war, Stunden dauerte, viele manuelle Schritte brauchte und regelmäßig schiefging. Nygards Botschaft: Wenn Deployment schmerzhaft ist, wird es selten gemacht, und seltene Deployments sind groß und riskant. Das ist der Deployment-Schmerz aus Accelerate, aus der Perspektive eines Beteiligten.
Für das Deployment entwerfen
Die zentrale Einsicht: Während eines Deployments laufen alte und neue Versionen gleichzeitig. Bei einem schrittweisen Rollout bedienen einige Instanzen schon die neue Version, andere noch die alte, und beide arbeiten auf denselben Daten. Das System muss dafür entworfen sein.
Datenbankschemas ändern: Expand and Contract
Schemaänderungen sind der schwierigste Teil, weil die Datenbank von alter und neuer Version gleichzeitig genutzt wird. Nygard beschreibt ein Vorgehen in Phasen, das heute meist Expand and Contract oder Parallel Change heißt:
| Phase | Schema | Code |
|---|---|---|
| 1. Erweitern | neue Spalte oder Tabelle hinzufügen, alte bleibt | alte Version läuft unverändert |
| 2. Doppelt schreiben | beide Strukturen werden gefüllt | neue Version schreibt alt und neu, liest alt |
| 3. Daten migrieren | Bestandsdaten in die neue Struktur kopieren | – |
| 4. Umstellen | – | neue Version liest neu |
| 5. Zurückbauen | alte Spalte entfernen | Code für die alte Struktur entfernen |
Zwischen den Phasen liegen jeweils eigene Deployments. Jede Phase lässt sich einzeln zurücknehmen. Das ist Becks „Migrate Data“ und Kleppmanns Rückwärts- und Vorwärtskompatibilität, angewandt auf Datenbankschemas. In Java helfen Werkzeuge wie Flyway oder Liquibase, die Phasen als versionierte Migrationen zu verwalten.
Weitere Aspekte
- Schemalose Datenbanken: Code muss mehrere Dokumentversionen lesen können; Migration oft schrittweise beim Lesen.
- Web-Ressourcen: JavaScript und CSS mit Versionsangaben im Namen ausliefern, damit Browser nicht alte und neue Dateien mischen.
- Rollout-Strategien: schrittweise Instanz für Instanz, Blue-Green mit zwei vollständigen Umgebungen, oder Canary mit einem kleinen Anteil der Nutzer zuerst.
- Aufräumen: alte Codepfade, Feature-Schalter und Migrationshilfen nach dem Rollout wieder entfernen. Sonst sammeln sie sich an.
Versionen
Dienste ändern sich, aber ihre Nutzer nicht im selben Takt. Nygard unterscheidet zwei Seiten:
Anderen den Umgang mit den eigenen Versionen erleichtern
- Bestehende Nutzer nicht brechen: neue Felder hinzufügen ist in Ordnung, Felder entfernen oder umbenennen nicht.
- Versionen ausdrücklich machen, etwa in der URL oder in Headern, wenn inkompatible Änderungen unvermeidlich sind.
- Verträge testen: Consumer-Driven Contract Tests, etwa mit Pact oder Spring Cloud Contract, prüfen, ob eine neue Version die Erwartungen ihrer Nutzer noch erfüllt.
Mit den Versionen anderer umgehen
- Damit rechnen, dass sich Partnersysteme ändern, auch ohne Ankündigung.
- Tolerant lesen: unbekannte Felder ignorieren, fehlende optionale Felder mit Standardwerten füllen. Das ist das Robustheitsprinzip, das Kleppmann für Vorwärtskompatibilität fordert.
- Annahmen über Partner prüfen und in Tests festhalten, Feathers‘ Characterization Tests für fremde Schnittstellen.
Systemische Probleme (Teil IV)
Der letzte Teil beginnt mit einer Fallstudie über den Start einer großen Handelsplattform, die unter dem Ansturm der eigenen Kunden zusammenbrach, obwohl sie auf dem Papier ausreichend dimensioniert war. Die Ursachen lagen nicht in einem einzelnen Fehler, sondern im Zusammenspiel: Sitzungen, Suchmaschinen-Crawler, ungünstige Lastverteilung. Die Lektion: Manche Probleme lassen sich nur auf Systemebene verstehen und lösen.
Anpassungsfähigkeit
Nygard argumentiert, dass Systeme sich ständig anpassen müssen, und dass Anpassungsfähigkeit selbst entworfen werden kann.
Konvexe Erträge. Manche Investitionen haben begrenzte Kosten, aber potenziell große Erträge, etwa Experimente oder modulare Strukturen, die neue Kombinationen erlauben. Das ist dieselbe Optionslogik, die Beck in Tidy First? entwickelt.
Prozess und Organisation:
- Plattformteams, die anderen Teams Werkzeuge und Infrastruktur als Dienst bereitstellen, statt Tickets abzuarbeiten. Diese Idee hat Team Topologies ein Jahr später systematisch ausgearbeitet.
- Schmerzlose Releases, damit häufige kleine Änderungen möglich sind.
- Dienste dürfen aussterben: Ein Dienst, der nicht mehr gebraucht wird, sollte abgeschaltet werden können, statt ewig weiterbetrieben zu werden.
- Die Effizienzfalle: Systeme und Organisationen, die auf maximale Effizienz optimiert sind, haben keinen Puffer für Veränderung, ähnlich Accelerates Warnung vor hoher Auslastung.
Systemarchitektur: Nygard greift die Ideen von Baldwin und Clark zu modularen Operatoren auf: Ein modulares System erlaubt es, Module aufzuteilen, zu ersetzen, wegzulassen, zu ergänzen, Gemeinsamkeiten herauszuziehen und Module in andere Kontexte zu übertragen. Jede dieser Operationen ist eine Option, und Modularität schafft solche Optionen.
Informationsarchitektur: Dienste sollen ihre Daten besitzen, Verweise zwischen Diensten über stabile Kennungen wie URLs laufen, und Begriffe eines Dienstes nicht in andere durchsickern. Das ist im Kern Evans‘ Bounded Context und Anticorruption Layer.
Chaos Engineering
Das letzte Kapitel behandelt eine Praxis, die durch Netflix bekannt wurde: in Produktion gezielt Fehler auslösen, um zu prüfen, ob das System sie verkraftet.
- Ausgangspunkt: Netflix‘ Chaos Monkey schaltete zufällig Server in Produktion ab, damit Teams lernen mussten, ihre Dienste ausfallsicher zu bauen. Daraus entstand eine ganze Werkzeugfamilie.
- Voraussetzungen: Man braucht Monitoring, um die Wirkung zu sehen, eine Möglichkeit, das Experiment sofort abzubrechen, und ein System, das zumindest grundlegend ausfallsicher sein soll. Chaos Engineering in einem fragilen System ist nur Chaos.
- Experimente entwerfen: eine Hypothese über das stabile Verhalten aufstellen, eine Störung einführen, etwa Latenz, Ausfall eines Dienstes oder einer Zone, Abweichungen messen, den möglichen Schaden begrenzen.
- Katastrophenübungen: geplante Übungen mit Menschen, etwa der Ausfall eines Rechenzentrums, um Abläufe und Zuständigkeiten zu testen, nicht nur Technik.
Einordnung
Chaos Engineering ist Nygards Test Harness in Produktion, und eine Antwort auf seine eigene Grundthese: Wenn nur die Produktion zählt, muss man auch dort prüfen, ob die Stabilitätsmuster wirken. Werkzeuge wie Chaos Monkey for Spring Boot, Toxiproxy oder Chaos Mesh machen das heute auch für Java-Anwendungen zugänglich.
Kritik und Einordnung
Release It! hat die Sprache geprägt, mit der Entwickler heute über Ausfallsicherheit reden. Circuit Breaker, Bulkhead und Steady State sind Allgemeingut, und viele Bibliotheken und Plattformen setzen die Muster direkt um.
Stärken
- Aus der Praxis: Die Fallstudien sind echte Ausfälle, mit echten Ursachen. Sie sind das Einprägsamste am Buch.
- Benannte Muster: Antipatterns und Muster geben ein gemeinsames Vokabular, ähnlich wie die GoF für Design.
- Entwickler in die Pflicht genommen: Betrieb ist nicht Aufgabe einer anderen Abteilung, sondern Folge von Designentscheidungen.
- Gut gealtert: Die Stabilitätsmuster von 2007 gelten in Cloud und Kubernetes genauso.
- Zweite Auflage modernisiert: Container, Service Discovery, Continuous Deployment und Chaos Engineering sind ergänzt.
Kritikpunkte
1. Breite statt Tiefe in Teil II. Netzwerk, DNS, Load Balancing, Control Plane und Sicherheit werden auf wenigen Seiten pro Thema behandelt. Wer tiefer will, braucht Spezialliteratur, etwa Site Reliability Engineering von Google.
2. Werkzeuge altern. Konkrete Technologien aus der zweiten Auflage haben sich seit 2018 weiterentwickelt, besonders bei Kubernetes, Service Meshes und Observability mit OpenTelemetry.
3. Wenig zu Observability im heutigen Sinn. Verteiltes Tracing, Korrelation über Dienste und die Idee, unbekannte Fragen an ein laufendes System stellen zu können, kommen nur am Rand vor.
4. Muster ohne Konfigurationshilfe. Wie man Timeouts, Schwellwerte für Circuit Breaker oder Pool-Größen konkret wählt, bleibt weitgehend offen. In der Praxis ist das der schwierigste Teil, und falsch eingestellte Muster können selbst Ausfälle verursachen, etwa Retry-Stürme oder zu früh öffnende Breaker.
5. Retries kaum behandelt. Wiederholte Aufrufe mit exponentiellem Backoff und Jitter, eine der häufigsten Fehlerquellen in verteilten Systemen, bekommen wenig Raum.
6. Anekdotisch. Wie fast alle Bücher der Reihe beruht es auf Erfahrung, nicht auf systematischen Daten. Accelerate liefert für einige Aussagen nachträglich Belege, etwa zu Deployment-Schmerz und kleinen Batches.
Gesamturteil
Release It! schließt die Lücke zwischen Code und Betrieb, die fast alle anderen Bücher der Reihe offenlassen. Es ist das Buch, nach dem man Code anders liest: Bei jedem Aufruf über eine Grenze fragt man sich, was passiert, wenn die Gegenstelle langsam ist, hängt oder Unsinn liefert. Für Java-Entwickler mit Spring, Resilience4j und Kubernetes ist es weiterhin eine der lohnendsten Lektüren.
Bezüge zur Reihe
Release It! ist das Gegenstück zu den Büchern über Codequalität und Tests: Es beschreibt, was nach dem letzten grünen Test passiert.
| Thema bei Nygard | Bezug in der Reihe |
|---|---|
| Fehler gegen Ausfall, Risse stoppen | Kleppmann: Fehler sollen nicht zu Ausfällen werden |
| Integration Points als größtes Risiko | Kleppmann: entfernte Aufrufe sind keine lokalen; GOOS: Adapter um Fremd-APIs |
| Timeouts überall | Kleppmann: Timeouts als einziger Ausweg bei unzuverlässigen Netzwerken |
| Blocked Threads | Bloch: Nebenläufigkeit; Weidig und GOOS: Logik von Nebenläufigkeit trennen |
| Fail Fast, Let It Crash | Thomas und Hunt: tote Programme lügen nicht; McConnell: Korrektheit oder Robustheit |
| Unbounded Result Sets | Kleppmann: Lastparameter und Perzentile |
| Test Harness | GOOS: Adapter gegen echte Gegenstellen testen; Feathers: Characterization Tests |
| Logging ist ein Feature, Transparenz | GOOS: Logging für den Betrieb hinter eigener Rolle |
| Expand and Contract | Beck: Migrate Data; Kleppmann: Schema-Evolution |
| Deployment-Schmerz, kleine Releases | Accelerate: Continuous Delivery, Burnout, Deployment-Schmerz |
| Plattformteams | Team Topologies; Accelerate: Teamautonomie |
| Modulare Operatoren, konvexe Erträge | Beck in Tidy First?: Optionen und Kopplung |
| Informationsarchitektur, Dienste besitzen ihre Daten | Evans: Bounded Contexts, Anticorruption Layer |
| Unsichere Deserialisierung | Bloch, Item 85; Kleppmann |
Diskussionsfragen
- Timeouts: Haben alle Aufrufe über Systemgrenzen in deinen Anwendungen ausdrückliche Zeitlimits, auch Datenbank- und Pool-Zugriffe? Wie würdest du das prüfen?
- Fallstudie: Hast du einen Ausfall erlebt, der wie die Fluggesellschaft mit einem kleinen Fehler begann und sich über Verbindungen ausbreitete?
- Circuit Breaker: Was passiert in euren Systemen fachlich, wenn ein Breaker offen ist? Gibt es sinnvolle Rückfallwerte, oder nur Fehlermeldungen?
- Bulkheads: Teilen sich bei euch alle Partnersysteme denselben Thread- oder Verbindungspool?
- Unbegrenzte Abfragen: Wo könnte bei euch eine Abfrage in Produktion plötzlich Millionen Zeilen liefern?
- Expand and Contract: Wie führt ihr Schemaänderungen ohne Ausfallzeit durch?
- Control Plane: Welche Stellschrauben habt ihr, um im Betrieb einzugreifen, ohne neu auszuliefern?
- Chaos Engineering: Wäre es in eurem Umfeld denkbar, gezielt Fehler in Produktion auszulösen? Was müsste dafür erst vorhanden sein?