Hands-On Machine Learning – Zusammenfassung und Einordnung
Aurélien Géron, Hands-On Machine Learning with Scikit-Learn and PyTorch (2025)
Einleitung
Gérons Buch ist seit fast einem Jahrzehnt die meistempfohlene praktische Einführung in Machine Learning. Es führt vom einfachsten Modell, einer linearen Regression, bis zu Transformern, Diffusionsmodellen und Reinforcement Learning, immer mit lauffähigem Code und klaren Erklärungen.
Autor und Ausgaben
Aurélien Géron leitete früher das Team für Videoklassifikation bei YouTube und gründete mehrere Unternehmen. Das Buch hat eine bewegte Geschichte:
| Jahr | Ausgabe | Deep-Learning-Werkzeug |
|---|---|---|
| 2017 | 1. Auflage | TensorFlow 1 |
| 2019 | 2. Auflage | Keras und TensorFlow 2 |
| 2022 | 3. Auflage | Keras und TensorFlow 2, ergänzt um Transformer und Diffusion |
| 2025 | Neue Ausgabe mit PyTorch | PyTorch und das Hugging-Face-Ökosystem |
Der Wechsel zu PyTorch folgt der Entwicklung in Forschung und Praxis, wo PyTorch inzwischen dominiert. Die neue Ausgabe hat rund 880 Seiten und enthält erweiterte Kapitel zu Transformern, Sprachmodellen, Bild-Transformern und Diffusionsmodellen. Diese Zusammenfassung bezieht sich auf sie; die TensorFlow-Ausgabe bleibt erhältlich und ist für den klassischen Teil weitgehend gleich.
Die Kernthese
Machine Learning ist kein Zauber, sondern ein Handwerk: Daten verstehen, ein Problem richtig formulieren, eine einfache Lösung bauen, sorgfältig bewerten, schrittweise verbessern. Wer die Grundlagen versteht, kann auch die modernsten Verfahren einordnen, weil sie auf denselben Ideen beruhen: Verlust minimieren, Überanpassung vermeiden, auf ungesehenen Daten prüfen.
Aufbau
| Teil | Werkzeug | Inhalt |
|---|---|---|
| I. Grundlagen des Machine Learning | Scikit-Learn | Überblick, ein Projekt von Anfang bis Ende, Klassifikation, Training, Entscheidungsbäume, Ensembles, Dimensionsreduktion, unüberwachtes Lernen |
| II. Neuronale Netze und Deep Learning | PyTorch, Hugging Face | neuronale Netze, Training tiefer Netze, Bildverarbeitung, Sequenzen, Transformer, Sprachmodelle, multimodale Modelle, generative Modelle, Reinforcement Learning |
Alle Beispiele liegen als Notebooks auf GitHub und laufen in Google Colab. Die Java-Beispiele in dieser Zusammenfassung zeigen Grundideen in reinem Java.
Die ML-Landschaft
Das erste Kapitel ordnet Machine Learning ein, ohne Formeln und ohne Code.
Arten des Lernens
| Art | Idee | Beispiel |
|---|---|---|
| Überwacht | aus Beispielen mit bekannter Antwort lernen | Spam-Filter, Preisprognose |
| Unüberwacht | Struktur in Daten ohne Antworten finden | Kundensegmente, Anomalien |
| Selbstüberwacht | Antworten aus den Daten selbst erzeugen, etwa das nächste Wort | Vortraining von Sprachmodellen |
| Halbüberwacht | wenige beschriftete, viele unbeschriftete Daten | Fotoalben, die Gesichter gruppieren |
| Reinforcement Learning | durch Belohnung für Handlungen lernen | Spiele, Robotersteuerung |
Außerdem unterscheidet Géron, ob ein System auf einmal oder laufend lernt, und ob es Beispiele auswendig vergleicht oder ein Modell daraus ableitet.
Die Hauptprobleme
Géron nennt zwei Quellen für schlechte Ergebnisse: schlechte Daten und schlechte Modelle. Bei den Daten: zu wenige, nicht repräsentativ, verrauscht, irrelevante Merkmale. Bei den Modellen: zu einfach oder zu komplex.
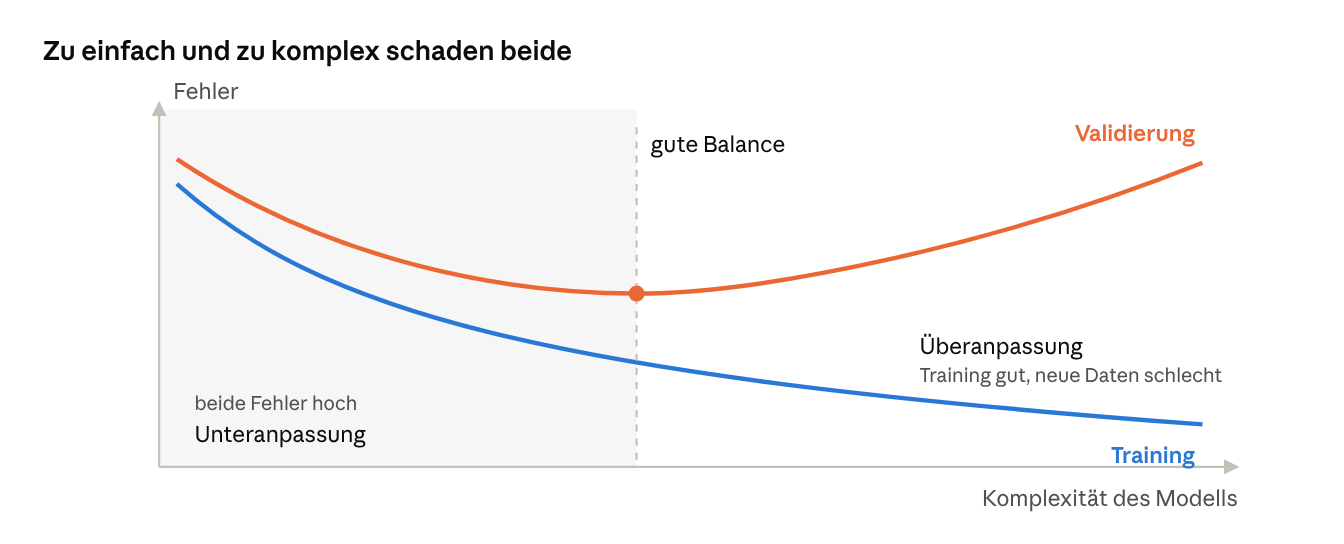
schematisch: Trainings- und Validierungsfehler in Abhängigkeit von der Modellkomplexität
- Unteranpassung: Das Modell ist zu einfach, um die Muster zu erfassen; es macht überall Fehler.
- Überanpassung: Das Modell lernt auch das Rauschen der Trainingsdaten auswendig; es ist im Training hervorragend und auf neuen Daten schlecht.
Gegenmittel für Überanpassung sind mehr Daten, ein einfacheres Modell und Regularisierung, also eine Strafe für zu große Komplexität.
Testen und Validieren
Die wichtigste Regel des Buchs: Ein Modell muss auf Daten geprüft werden, die es nie gesehen hat. Daher teilt man die Daten in Training, Validierung für die Auswahl von Modell und Einstellungen und Test für die abschließende, einmalige Bewertung. Wer die Testdaten mehrfach zur Auswahl nutzt, passt sich ihnen an und überschätzt die Leistung.
Kein kostenloses Mittagessen
Géron erwähnt das No-Free-Lunch-Theorem: Kein Verfahren ist für alle Probleme das beste. Man muss Annahmen treffen und verschiedene Modelle ausprobieren.
Einordnung
Die Trennung von Trainings-, Validierungs- und Testdaten ist dasselbe Prinzip wie Huyens Warnung vor Datenlecks und Raschkas Trainings- und Validierungsverlust. Für Softwareentwickler: Testdaten sind wie ein Abnahmetest, den man nicht während der Entwicklung zum Debuggen verwenden darf.
Ein Projekt von Anfang bis Ende
Das zweite Kapitel ist das bekannteste des Buchs. Es führt durch ein vollständiges Projekt: Hauspreise in Kalifornien vorhersagen, aus Daten einer Volkszählung. Unterwegs zeigt Géron fast alles, was in echten Projekten vorkommt.
Die Schritte
| Schritt | Inhalt |
|---|---|
| Das Gesamtbild sehen | Wofür wird die Vorhersage gebraucht? Wie wird bisher geschätzt? Welche Kennzahl zählt? |
| Daten beschaffen | laden, Aufbau ansehen, sofort einen Testdatensatz beiseitelegen |
| Daten erkunden | Verteilungen, Zusammenhänge, Karten; neue Merkmale ausprobieren, etwa Zimmer pro Haushalt |
| Daten vorbereiten | fehlende Werte, Kategorien, Skalierung, alles als wiederverwendbare Pipeline |
| Modelle auswählen und trainieren | lineare Regression, Entscheidungsbaum, Random Forest; mit Kreuzvalidierung vergleichen |
| Feinabstimmen | Hyperparameter systematisch oder zufällig durchsuchen |
| Fehler analysieren | wo und warum liegt das beste Modell daneben? |
| Auf dem Testdatensatz prüfen | einmal, am Ende |
| Ausliefern, überwachen, pflegen | Modell speichern, als Dienst bereitstellen, Leistung beobachten, regelmäßig neu trainieren |
Wichtige Lektionen
Geschichtete Testdaten. Géron teilt die Daten nicht rein zufällig, sondern so, dass die Einkommensgruppen im Testdatensatz im gleichen Verhältnis vorkommen wie insgesamt. Sonst kann der Test zufällig unrepräsentativ sein.
Kreuzvalidierung. Statt einer einzigen Validierungsmenge teilt man die Trainingsdaten in mehrere Teile, trainiert mehrfach und prüft jeweils auf einem anderen Teil. Das liefert eine verlässlichere Schätzung und zeigt die Streuung.
Der Entscheidungsbaum mit null Fehlern. Auf den Trainingsdaten erreicht ein Entscheidungsbaum perfekte Werte, in der Kreuzvalidierung ist er schlechter als eine lineare Regression: ein Lehrbuchbeispiel für Überanpassung.
Pipelines. Alle Vorverarbeitungsschritte werden zu einer Pipeline verbunden, die beim Training gelernt und dann identisch auf neue Daten angewendet wird. Das verhindert genau die Datenlecks und Unterschiede zwischen Training und Betrieb, vor denen Huyen warnt.
Die Checkliste
Im Anhang steht eine Checkliste für ML-Projekte, die viele Teams übernommen haben. Sie beginnt nicht mit Modellen, sondern mit Fragen: Was ist das Geschäftsziel? Wie wird die Lösung genutzt? Wie wird Erfolg gemessen? Was wäre die Lösung ohne ML?
Einordnung
Das Kapitel ist Huyens Designing Machine Learning Systems im Kleinen und mit Code. Die Reihenfolge, erst Ziel und Messung, dann Daten, dann einfache Modelle, dann Verfeinerung, entspricht Huyens vier Phasen und Becks kleinen Schritten.
Klassische Verfahren
Der Rest des ersten Teils stellt die wichtigsten klassischen Verfahren vor, jeweils mit Intuition, etwas Mathematik und Scikit-Learn-Code.
Klassifikation und ihre Kennzahlen
Am Beispiel handgeschriebener Ziffern zeigt Géron, dass Genauigkeit allein täuscht. Wichtiger sind:
| Kennzahl | Frage |
|---|---|
| Konfusionsmatrix | Welche Klassen werden mit welchen verwechselt? |
| Präzision | Von den als positiv erkannten Fällen: Wie viele sind wirklich positiv? |
| Trefferquote | Von den wirklich positiven Fällen: Wie viele wurden erkannt? |
| F1-Wert | Kombination aus beiden |
| ROC- und Präzisions-Trefferquoten-Kurven | Wie verschieben sich Präzision und Trefferquote, wenn man die Entscheidungsschwelle ändert? |
Die Abwägung ist geschäftlich: Ein Filter für jugendgefährdende Videos braucht hohe Präzision, ein Ladendiebstahl-Detektor eher hohe Trefferquote.
Wie Modelle lernen
Das Kapitel über das Training erklärt Gradientenabstieg, den Kern fast allen modernen Lernens: den Verlust berechnen, die Richtung bestimmen, in der er am stärksten sinkt, und einen kleinen Schritt in diese Richtung gehen.
// Lineare Regression mit Gradientenabstieg in reinem Java
// x: [n][d] Merkmale, y: [n] Zielwerte
record LinearModel(double[] w, double b) {
    double predict(double[] xi) {
        double s = b;
        for (int j = 0; j < w.length; j++) s += w[j] * xi[j];
        return s;
    }
}

static LinearModel fit(double[][] x, double[] y, double learningRate, int epochs) {
    int n = x.length, d = x[0].length;
    double[] w = new double[d];
    double b = 0;
    for (int epoch = 0; epoch < epochs; epoch++) {
        double[] gradW = new double[d];
        double gradB = 0;
        for (int i = 0; i < n; i++) {
            double error = new LinearModel(w, b).predict(x[i]) - y[i];
            for (int j = 0; j < d; j++) gradW[j] += 2 * error * x[i][j] / n;   // Ableitung des mittleren quadratischen Fehlers
            gradB += 2 * error / n;
        }
        for (int j = 0; j < d; j++) w[j] -= learningRate * gradW[j];         // Schritt gegen den Gradienten
        b -= learningRate * gradB;
    }
    return new LinearModel(w, b);
}
Géron unterscheidet Batch, alle Daten pro Schritt, stochastisch, ein Beispiel pro Schritt, und Mini-Batch, kleine Gruppen; letzteres ist der Standard bei neuronalen Netzen. Er zeigt Lernkurven zum Erkennen von Über- und Unteranpassung und Regularisierung: Ridge, Lasso, Elastic Net und das einfache frühe Stoppen, sobald der Validierungsfehler steigt.
Entscheidungsbäume und Ensembles
Entscheidungsbäume sind leicht zu verstehen, aber instabil: Kleine Änderungen der Daten ergeben ganz andere Bäume. Ensembles kombinieren viele Modelle und gleichen das aus:
| Verfahren | Idee |
|---|---|
| Bagging und Random Forest | viele Bäume auf zufälligen Teilmengen trainieren, Ergebnisse mitteln |
| Boosting | Bäume nacheinander trainieren, jeder korrigiert die Fehler der vorigen |
| Stacking | ein weiteres Modell lernt, die Vorhersagen mehrerer Modelle zu kombinieren |
Für tabellarische Geschäftsdaten sind Gradient-Boosting-Verfahren oft die stärkste Wahl, häufig besser als neuronale Netze.
Dimensionsreduktion und unüberwachtes Lernen
- Fluch der Dimensionalität: In sehr vielen Dimensionen liegen alle Punkte weit auseinander; Modelle brauchen exponentiell mehr Daten.
- PCA projiziert die Daten auf die Richtungen mit der größten Streuung.
- Clustering mit k-Means, DBSCAN oder Gaußschen Mischmodellen findet Gruppen.
- Anomalieerkennung findet Ausreißer, etwa Betrug oder defekte Bauteile.
Einordnung
Gradientenabstieg ist derselbe Mechanismus, den Raschka beim Vortraining verwendet, nur mit einer Formel statt Milliarden Parametern. Die Erkenntnis, dass Gradient Boosting bei Tabellendaten oft gewinnt, ist für Geschäftsanwendungen wichtiger als vieles über Deep Learning.
Neuronale Netze mit PyTorch
Der zweite Teil wechselt zu neuronalen Netzen. Géron baut sie wie die klassischen Verfahren von Grund auf auf.
Vom Neuron zum Netz
- Künstliches Neuron: gewichtete Summe der Eingaben, dann eine Aktivierungsfunktion, die eine Nichtlinearität einführt, heute meist ReLU oder eine ihrer Varianten.
- Mehrschichtiges Netz: viele Neuronen in Schichten hintereinander. Ohne Nichtlinearität wären beliebig viele Schichten nicht mächtiger als eine.
- Rückpropagation: das Verfahren, mit dem der Gradient des Verlusts für jedes Gewicht effizient berechnet wird, Schicht für Schicht rückwärts.
PyTorch-Grundlagen
Géron führt PyTorch ausführlicher ein als Raschka: Tensoren und ihre Operationen, automatische Ableitung, Modelle als Unterklassen von nn.Module, die Trainingsschleife, Rechnen auf Grafikkarten, Speichern und Laden. Dazu kommt die systematische Suche nach guten Hyperparametern, also Schichtzahl, Breite und Lernrate.
Tiefe Netze trainieren
Das Kapitel über das Training tiefer Netze ist eine Sammlung von Techniken, die tiefe Netze erst trainierbar machen:
| Problem | Lösungen |
|---|---|
| Verschwindende oder explodierende Gradienten | sorgfältige Initialisierung der Gewichte, passende Aktivierungsfunktionen, Normalisierungsschichten, Begrenzung der Gradienten |
| Zu wenig Daten | Transfer Learning: ein auf einer ähnlichen Aufgabe vortrainiertes Netz wiederverwenden und nur die oberen Schichten neu trainieren |
| Langsames Training | bessere Optimierer: Momentum, RMSProp, Adam und AdamW; Lernraten-Zeitpläne mit Aufwärmphase und Abfall |
| Überanpassung | Gewichtsstrafen, Dropout, frühes Stoppen, Datenerweiterung |
Géron fasst die Empfehlungen am Ende in einer Tabelle mit Standardeinstellungen zusammen, mit denen man in den meisten Fällen gut startet. Das ist eine der hilfreichsten Seiten des Buchs.
Einordnung
Hier findet man die Hintergründe zu Bausteinen, die Raschka einfach verwendet: Warum es Layer Normalization gibt, warum AdamW, warum eine Aufwärmphase. Transfer Learning ist dieselbe Idee, die Alammar und Grootendorst und Huyen als Finetuning beschreiben; Géron zeigt sie zuerst an Bildmodellen.
Bilder und Sequenzen
Bevor Transformer fast alles übernahmen, gab es für Bilder und Sequenzen eigene Architekturen. Géron behandelt sie, weil sie weiterhin eingesetzt werden und weil ihre Ideen in modernen Modellen weiterleben.
Faltungsnetze für Bilder
Convolutional Neural Networks verarbeiten Bilder mit kleinen Filtern, die über das Bild geschoben werden und lokale Muster erkennen: zuerst Kanten, in tieferen Schichten Formen, dann Objekte. Zwei Ideen machen sie effizient:
- Gewichte teilen: Derselbe Filter wird an jeder Stelle des Bildes verwendet. Eine Katze wird erkannt, egal wo sie im Bild ist.
- Verdichten: Schichten, die das Bild schrittweise verkleinern, damit tiefere Schichten größere Zusammenhänge sehen.
Géron führt durch die Geschichte bekannter Architekturen bis zu Restnetzen mit Abkürzungsverbindungen, die Raschka im Transformer wiederverwendet. Er zeigt Klassifikation, Objekterkennung mit Begrenzungsrahmen und Segmentierung, bei der jedes Pixel einer Klasse zugeordnet wird, und nutzt dafür vortrainierte Modelle mit Transfer Learning.
Rekurrente Netze für Sequenzen
Rekurrente Netze verarbeiten Sequenzen Schritt für Schritt und tragen einen Zustand mit, der zusammenfasst, was bisher kam. Géron zeigt sie an Zeitreihenprognosen, etwa Fahrgastzahlen im öffentlichen Nahverkehr, und vergleicht sie mit einfachen Ansätzen wie „morgen wie heute vor einer Woche“ und klassischen statistischen Modellen.
Ihre Schwäche: Sie vergessen Information über lange Strecken und lassen sich schlecht parallelisieren. Varianten mit Gedächtniszellen mildern das Vergessen, das Parallelisierungsproblem löst erst der Transformer.
Einordnung
Für Zeitreihen ist Gérons Ratschlag wertvoll: zuerst einfache Vergleichsbasen. Oft schlägt eine saisonale Wiederholung ein aufwendiges Netz. Das ist Huyens Phase „vor ML“ in der Praxis. Für Geschäftsanwendungen wie Bedarfsprognosen sind Zeitreihenkapitel oft relevanter als alles über Sprachmodelle.
Transformer, Sprachmodelle, multimodale Modelle
Dieser Teil ist in der PyTorch-Ausgabe am stärksten erweitert und nutzt das Hugging-Face-Ökosystem: vortrainierte Modelle, Tokenizer, Datensätze und Trainingswerkzeuge.
Vom rekurrenten Netz zum Transformer
Géron zeigt die Entwicklung nachvollziehbar: Erst Sprachverarbeitung mit rekurrenten Netzen, dann der Engpass, dass eine lange Eingabe in einen einzigen Zustand gepresst werden muss, dann Aufmerksamkeit als Lösung, schließlich der Transformer, der ganz auf Rekurrenz verzichtet. Den Transformer baut er selbst, ähnlich wie Raschka, aber knapper.
Die Modellfamilien
| Familie | Beispiele | Typische Aufgaben |
|---|---|---|
| Nur Encoder | BERT und Nachfolger | Klassifikation, Erkennung von Entitäten, Embeddings |
| Encoder und Decoder | T5, BART | Übersetzung, Zusammenfassung |
| Nur Decoder | GPT, Llama und andere offene Modelle | Textgenerierung, Assistenten |
Sprachmodelle nutzen und anpassen
Géron zeigt den praktischen Umgang mit vortrainierten Sprachmodellen: laden, Text erzeugen, mit Prompts steuern, mit Anweisungsdaten feinabstimmen, parametereffizient mit LoRA. Er erläutert, wie aus einem Basismodell ein Assistent wird, und streift Präferenz-Finetuning. Das überschneidet sich mit Raschka sowie Alammar und Grootendorst; Gérons Darstellung ist knapper, dafür eingebettet in den Gesamtzusammenhang des Machine Learning.
Transformer für Bilder und mehrere Modalitäten
- Vision Transformer: Bilder als Folge von Kacheln, wie bei Alammar und Grootendorst.
- Multimodale Modelle: Bild und Text in einem gemeinsamen Raum oder ein Sprachmodell, das Bilder als Eingabe versteht.
Einordnung
Für Leser der Reihe ist dieser Teil eine Wiederholung aus anderem Blickwinkel. Sein Wert liegt in der Herleitung: Wer die Kapitel über rekurrente Netze und Faltungsnetze gelesen hat, versteht, welches Problem der Transformer gelöst hat und warum Abkürzungsverbindungen, Normalisierung und Aufmerksamkeit dort zusammenkommen.
Generative Modelle
Géron stellt drei Familien vor, die neue Daten erzeugen, etwa Bilder:
| Familie | Idee | Eigenschaft |
|---|---|---|
| Autoencoder | Daten auf eine kompakte Darstellung verdichten und daraus wiederherstellen; Varianten lernen eine Verteilung, aus der man neue Beispiele ziehen kann | auch nützlich für Anomalieerkennung: Was sich schlecht rekonstruieren lässt, ist ungewöhnlich |
| Generative Adversarial Networks | ein Erzeuger und ein Prüfer trainieren gegeneinander; der Erzeuger lernt, den Prüfer zu täuschen | scharfe Ergebnisse, aber schwieriges, instabiles Training |
| Diffusionsmodelle | lernen, schrittweise Rauschen aus einem Bild zu entfernen; zur Erzeugung beginnt man mit reinem Rauschen | heute Standard für Bilderzeugung; stabil, aber rechenintensiv |
Die Anomalieerkennung mit Autoencodern ist für Geschäftsanwendungen interessant, etwa bei Sensordaten oder Transaktionen.
Reinforcement Learning
Im letzten großen Kapitel lernt ein Agent durch Ausprobieren: Er handelt in einer Umgebung, erhält Belohnungen und lernt eine Strategie, die die Gesamtbelohnung maximiert.
Kernideen
- Erkunden oder ausnutzen: Neues ausprobieren oder bei Bewährtem bleiben; dieselbe Abwägung wie bei Huyens Banditen.
- Verzögerte Belohnung: Eine Handlung zahlt sich vielleicht erst viel später aus; welcher Schritt war verantwortlich?
- Strategiegradienten: die Strategie direkt in Richtung höherer Belohnung verändern.
- Wertbasierte Verfahren: lernen, wie viel ein Zustand oder eine Handlung wert ist, etwa mit tiefen Q-Netzen.
Géron zeigt das an klassischen Steuerungsaufgaben, etwa einen Stab auf einem Wagen zu balancieren.
Einordnung
Reinforcement Learning ist der Mechanismus hinter dem Präferenz-Finetuning von Sprachmodellen und hinter den Reasoning-Modellen, um die es in Raschkas Folgeband geht. Für Geschäftsanwendungen ist es selten die erste Wahl; die Kontext-Banditen aus Huyens Buch sind die praktischere, vereinfachte Form.
Was Java-Entwickler mitnehmen
Begriffe und Urteilsvermögen
Der größte Gewinn für Java-Entwickler ist nicht der Python-Code, sondern das Vokabular und das Urteilsvermögen: Wenn ein Data-Science-Team von Kreuzvalidierung, Überanpassung, Präzision und Trefferquote oder Gradient Boosting spricht, kann man mitreden und kritische Fragen stellen. Und man erkennt, wenn ein Modell zu gut aussieht, um wahr zu sein.
Kennzahlen selbst prüfen
Viele Integrationsaufgaben bestehen darin, die Ergebnisse eines Modells im eigenen System zu bewerten, etwa ob die Vorhersagen eines Betrugsmodells im Betrieb so gut sind wie versprochen. Das geht auch in Java:
// Konfusionsmatrix für zwei Klassen und die wichtigsten Kennzahlen
record BinaryMetrics(long tp, long fp, long tn, long fn) {

    static BinaryMetrics of(List<Boolean> predicted, List<Boolean> actual) {
        long tp = 0, fp = 0, tn = 0, fn = 0;
        for (int i = 0; i < predicted.size(); i++) {
            boolean p = predicted.get(i), a = actual.get(i);
            if (p && a) tp++; else if (p) fp++; else if (a) fn++; else tn++;
        }
        return new BinaryMetrics(tp, fp, tn, fn);
    }

    double precision() { return tp + fp == 0 ? 0 : (double) tp / (tp + fp); }   // wie oft stimmt ein Alarm?
    double recall()    { return tp + fn == 0 ? 0 : (double) tp / (tp + fn); }   // wie viele Fälle werden gefunden?
    double f1()        { double p = precision(), r = recall(); return p + r == 0 ? 0 : 2 * p * r / (p + r); }
}
Training in Python, Betrieb in Java
Ein verbreitetes Muster: Modelle werden in Python trainiert und in Java-Systemen ausgeführt. Dafür gibt es mehrere Wege:
| Weg | Vorgehen | Abwägung |
|---|---|---|
| Eigener Python-Dienst | das Modell hinter einer REST-Schnittstelle | einfach, aber ein weiterer Dienst mit eigener Laufzeit |
| ONNX | Modell in ein standardisiertes Format exportieren, in Java mit ONNX Runtime ausführen | geringe Latenz, kein Python im Betrieb; nicht jedes Modell lässt sich exportieren |
| Native Java-Bibliotheken | etwa die Java-Anbindungen von Gradient-Boosting-Bibliotheken, die Deep Java Library oder Tribuo | gut integriert; Training und Betrieb müssen dieselbe Vorverarbeitung verwenden |
Der heikelste Teil ist fast immer die Vorverarbeitung: Gérons Pipelines müssen im Java-Betrieb exakt nachgebildet oder mitexportiert werden. Das ist Huyens Unterschied zwischen Training und Betrieb in der Praxis.
Einordnung
Für einen Architekten, der Java-Systeme verantwortet, ist die Frage weniger, wie man ein Modell trainiert, als wo es läuft, wie es angebunden wird und wie man es prüft. Gérons Buch liefert das Verständnis, Huyens Bücher die Architektur.
Kritik und Einordnung
Stärken
- Didaktik: Géron erklärt außergewöhnlich klar, mit Intuition zuerst und Mathematik nur so weit wie nötig.
- Vollständigkeit: von linearer Regression bis Diffusion und Reinforcement Learning in einem Band, mit durchgehend gleichem Stil.
- Praxisnähe: Das Projekt-Kapitel und die Checkliste spiegeln echte Arbeit, nicht nur Lehrbuchbeispiele.
- Ausgewogenheit: Klassische Verfahren bekommen ihren Platz; Géron sagt deutlich, wann Gradient Boosting oder ein einfaches Modell besser ist als ein neuronales Netz.
- Aktualität: Die PyTorch-Ausgabe von 2025 schließt den Abstand zur heutigen Praxis.
Kritikpunkte
1. Umfang. Rund 880 Seiten sind viel. Als Nachschlagewerk gut, zum Durchlesen eine Herausforderung.
2. Betrieb nur am Rand. Wie man Modelle ausliefert, überwacht und pflegt, wird angesprochen, aber nicht vertieft. Dafür braucht man Huyen.
3. Mathematik bleibt oberflächlich. Für die Begründung vieler Techniken verweist Géron auf Artikel. Wer verstehen will, warum etwas funktioniert, braucht Prince oder Goodfellow.
4. Sprachmodelle in Kürze. Die neuen Kapitel sind gut, aber für Leser dieser Reihe überwiegend Wiederholung; Raschka sowie Alammar und Grootendorst gehen tiefer.
5. Zwei Ausgaben. Wer die TensorFlow-Ausgabe besitzt, muss sich fragen, ob sich die neue lohnt. Für den klassischen Teil kaum; für Deep Learning und Sprachmodelle ja.
Gesamturteil
Das beste Einstiegsbuch in Machine Learning insgesamt, nicht nur in Sprachmodelle. Für Java-Entwickler und Architekten, die mit Data-Science-Teams arbeiten, sind die ersten Kapitel, besonders das Projekt-Kapitel und die Checkliste, Pflichtlektüre; der Rest ist ein hervorragendes Nachschlagewerk.
Bezüge zur Reihe
Die KI-Reihe bisher
| Buch | Rolle |
|---|---|
| Huyen, AI Engineering | Anwendungen mit Foundation Models bauen und betreiben |
| Raschka, Build an LLM | ein Sprachmodell von innen verstehen |
| Alammar und Grootendorst, Hands-On LLMs | was man mit Sprachmodellen praktisch tun kann |
| Huyen, Designing ML Systems | ML-Systeme entwerfen und betreiben |
| Géron, Hands-On ML | die Grundlagen des Machine Learning insgesamt |
Weitere Bezüge
| Thema bei Géron | Bezug in der Reihe |
|---|---|
| Trainings-, Validierungs-, Testdaten | Huyen: Datenlecks; Raschka: Validierungsverlust |
| Projekt-Checkliste, erst Ziel und Messung | Huyen: Problem formulieren, vier Phasen; Thomas und Hunt: Anforderungen |
| Pipelines für Vorverarbeitung | Huyen: Training und Betrieb gleich rechnen; Hohpe und Woolf: Pipes and Filters |
| Kreuzvalidierung | Accelerate und McConnell: belastbare Messung statt Einzelergebnis |
| Präzision und Trefferquote | Huyen: unausgewogene Klassen; Nygard: Fehlalarme in der Überwachung |
| Gradientenabstieg | Raschka: Trainingsschleife |
| Normalisierung, AdamW, Aufwärmphase | Raschka: Bausteine des GPT-Modells |
| Restnetze mit Abkürzungen | Raschka: Residualverbindungen im Transformer |
| Transfer Learning | Alammar und Grootendorst, Huyen: Finetuning |
| Einfache Vergleichsbasen bei Zeitreihen | Huyen: Phase vor ML; Beck: das Einfachste, das funktionieren könnte |
| Reinforcement Learning | Huyen: Banditen; Raschka: Reasoning-Modelle |
Diskussionsfragen
- Tabellen statt Text: Welche eurer Daten sind tabellarisch, etwa Verträge, Schäden, Bestellungen? Wäre Gradient Boosting dort sinnvoller als ein Sprachmodell?
- Checkliste: Würdet ihr Gérons Projekt-Checkliste für eure KI-Vorhaben übernehmen? Welche Fragen fehlen?
- Zu gut: Wie würdest du reagieren, wenn ein Team ein Modell mit 99 Prozent Genauigkeit präsentiert?
- Präzision oder Trefferquote: Bei welchen Entscheidungen in euren Systemen sind Fehlalarme teurer, bei welchen übersehene Fälle?
- Python und Java: Wie bringt ihr Modelle aus Python in eure Java-Systeme, und wer ist für die Vorverarbeitung verantwortlich?
- Prognosen: Gibt es bei euch Zeitreihen, etwa Lastprognosen oder Bedarfe, für die einfache Vergleichsbasen fehlen?
- Ausgabe: Lohnt sich für dich die PyTorch-Ausgabe, oder reicht der klassische Teil?
- Weiter: Als Nächstes Prince, Understanding Deep Learning, das die Mathematik hinter den Techniken erklärt.