Hands-On Large Language Models – Zusammenfassung und Einordnung
Jay Alammar, Maarten Grootendorst, Hands-On Large Language Models: Language Understanding and Generation (2024)
Einleitung
Huyen zeigt, wie man Anwendungen mit Sprachmodellen baut, Raschka, wie ein Sprachmodell innen funktioniert. Hands-On Large Language Models liegt dazwischen: Es zeigt mit vielen Abbildungen und lauffähigem Code, was man mit Sprachmodellen praktisch tun kann, über Chatbots hinaus: klassifizieren, gruppieren, suchen, Themen finden, Bilder verstehen und eigene Modelle anpassen.
Autoren und Kontext
Jay Alammar ist bekannt für seine illustrierten Erklärungen, besonders The Illustrated Transformer, eine der meistgelesenen Einführungen in die Transformer-Architektur. Er arbeitet beim Modellanbieter Cohere. Maarten Grootendorst ist Datenwissenschaftler und Autor von BERTopic, einer verbreiteten Open-Source-Bibliothek zur Themenmodellierung, sowie von visuellen Erklärungen etwa zu Quantisierung und alternativen Architekturen. Das Buch erschien im Herbst 2024 bei O’Reilly und ist weiterhin in der ersten Auflage aktuell. Die Autoren nennen es scherzhaft „The Illustrated LLM Book“.
Die Kernthese
Sprachmodelle sind mehr als Textgeneratoren. Die Autoren unterscheiden durchgehend zwei Arten:
- Repräsentationsmodelle, meist Encoder wie BERT, die Text in Vektoren übersetzen. Sie eignen sich für Klassifikation, Suche und Gruppierung.
- Generative Modelle, meist Decoder wie GPT, die Text erzeugen.
Viele praktische Aufgaben lassen sich mit Repräsentationsmodellen schneller, günstiger und zuverlässiger lösen als mit großen generativen Modellen. Wer beide Arten kennt und kombiniert, baut bessere Anwendungen.
Aufbau
| Teil | Kapitel | Inhalt |
|---|---|---|
| I. Sprachmodelle verstehen | 1–3 | Einführung, Tokens und Embeddings, ein Blick ins Innere |
| II. Vortrainierte Modelle nutzen | 4–9 | Klassifikation, Clustering und Themenmodellierung, Prompt Engineering, fortgeschrittene Textgenerierung, semantische Suche und RAG, multimodale Modelle |
| III. Training und Finetuning | 10–12 | Embedding-Modelle erstellen, Repräsentationsmodelle für Klassifikation feinabstimmen, generative Modelle feinabstimmen |
Rund 430 Seiten, Python mit Hugging Face, Sentence Transformers und LangChain, alle Beispiele als Notebooks auf GitHub. Die Java-Beispiele in dieser Zusammenfassung verwenden Spring AI 2.x.
Sprachmodelle verstehen
Eine kurze Geschichte der Sprach-KI
Das erste Kapitel zeichnet die Entwicklung nach, jeweils mit Abbildungen:
| Stufe | Idee | Grenze |
|---|---|---|
| Bag of Words | Text als Zählung von Wörtern | Bedeutung und Reihenfolge gehen verloren |
| Word2Vec | jedes Wort als Vektor, gelernt aus seinen Nachbarn; ähnliche Wörter liegen nah beieinander | ein Wort hat immer denselben Vektor, egal in welchem Satz |
| Rekurrente Netze mit Aufmerksamkeit | Wörter werden der Reihe nach verarbeitet, mit Blick auf wichtige frühere Wörter | langsam, schwer zu parallelisieren |
| Transformer | Aufmerksamkeit ohne Reihenfolgeverarbeitung, alles parallel | hoher Rechenaufwand bei langen Texten |
| BERT und GPT | Encoder für Verstehen, Decoder für Erzeugen |
Tokens und Embeddings
Das zweite Kapitel vergleicht, wie verschiedene Modelle denselben Text in Tokens zerlegen, etwa Code, Zahlen, Großbuchstaben oder Emojis, und zeigt, warum das Verhalten beeinflusst: Ein Modell, dessen Tokenizer Leerzeichen in Code schlecht abbildet, programmiert schlechter. Dann geht es um Embeddings auf mehreren Ebenen:
- Token-Embeddings im Inneren des Modells, wie bei Raschka.
- Text-Embeddings, ein Vektor für einen ganzen Satz oder Absatz; die Grundlage für Suche und Klassifikation.
- Embeddings über Sprache hinaus, etwa für Empfehlungssysteme, bei denen Lieder in einer Wiedergabeliste wie Wörter in einem Satz behandelt werden.
Ein Blick ins Innere
Das dritte Kapitel erklärt den Vorwärtsdurchlauf eines generativen Modells, ähnlich wie Raschka, aber nur mit Abbildungen statt mit eigenem Code. Wertvoll ist der Abschnitt über Verbesserungen seit dem ursprünglichen Transformer, die in Raschkas GPT-2 fehlen:
| Verbesserung | Idee |
|---|---|
| Effizientere Aufmerksamkeit | mehrere Köpfe teilen sich Keys und Values, das spart Speicher im KV-Cache |
| Rotierende Positionskodierung | Positionen werden als Drehung im Vektorraum kodiert; besser für lange Kontexte |
| Normalisierung vor statt nach dem Teilschritt | stabileres Training |
| Optimierte Aufmerksamkeitsberechnung | geschickte Speicherzugriffe beschleunigen die Berechnung auf Grafikkarten |
Einordnung
Wer Raschka gelesen hat, erkennt hier alles wieder, sieht es aber in Bildern statt in Code und erfährt, wie moderne Modelle sich von GPT-2 unterscheiden. Für Leser, die nicht selbst programmieren wollen, ist dieser Teil die zugänglichere Variante.
Repräsentation und Generierung
Die Unterscheidung zieht sich durch das ganze Buch und ist für Architekturentscheidungen wichtig:
| Repräsentationsmodelle | Generative Modelle | |
|---|---|---|
| Typischer Aufbau | Encoder, etwa BERT und seine Nachfolger | Decoder, etwa GPT, Llama, Claude |
| Ausgabe | ein Vektor oder eine Klasse | Text |
| Größe | oft klein, Millionen Parameter | oft groß, Milliarden Parameter |
| Kosten und Latenz | gering, läuft auch ohne Grafikkarte | höher |
| Stärke | Klassifikation, Suche, Ähnlichkeit, Gruppierung | Erzeugen, Zusammenfassen, Umformulieren, flexible Aufgaben |
Textklassifikation
Am Beispiel von Filmkritiken, die als positiv oder negativ eingeordnet werden sollen, vergleicht das vierte Kapitel mehrere Wege:
| Weg | Vorgehen | Braucht beschriftete Daten? |
|---|---|---|
| Aufgabenspezifisches Modell | ein bereits für Stimmungsanalyse feinabgestimmtes Modell direkt nutzen | nein, falls es eines für die Aufgabe gibt |
| Embeddings plus klassischer Klassifikator | Texte in Vektoren übersetzen, dann eine einfache logistische Regression trainieren | ja, aber wenige |
| Zero-Shot mit Embeddings | auch die Klassenbeschreibungen einbetten, etwa „eine positive Filmkritik“, und jeden Text der ähnlichsten Beschreibung zuordnen | nein |
| Generatives Modell mit Prompt | ein Sprachmodell fragen, ob die Kritik positiv oder negativ ist | nein |
Die Ergebnisse sind lehrreich: Schon einfache, kleine Lösungen erreichen hohe Genauigkeit; große generative Modelle sind nicht automatisch besser, aber teurer und langsamer.
// Zero-Shot-Klassifikation über Embeddings mit Spring AI
@Component
class ZeroShotClassifier {
    private final EmbeddingModel embeddings;
    private final Map<String, float[]> labelVectors;

    ZeroShotClassifier(EmbeddingModel embeddings) {
        this.embeddings = embeddings;
        this.labelVectors = Map.of(
            "WASSERSCHADEN", embeddings.embed("Eine Schadensmeldung über Wasser, Rohrbruch oder Überschwemmung"),
            "EINBRUCH",      embeddings.embed("Eine Schadensmeldung über Einbruch oder Diebstahl"),
            "GLASBRUCH",     embeddings.embed("Eine Schadensmeldung über zerbrochene Fenster oder Glas"));
    }

    String classify(String text) {
        float[] v = embeddings.embed(text);
        return labelVectors.entrySet().stream()
            .max(Comparator.comparingDouble(e -> cosine(v, e.getValue())))
            .orElseThrow().getKey();
    }

    static double cosine(float[] a, float[] b) {
        double dot = 0, na = 0, nb = 0;
        for (int i = 0; i < a.length; i++) { dot += a[i] * b[i]; na += a[i] * a[i]; nb += b[i] * b[i]; }
        return dot / (Math.sqrt(na) * Math.sqrt(nb));
    }
}
Einordnung
Für Architekten ist das eine der wichtigsten Lehren der ganzen KI-Reihe: Nicht jede KI-Aufgabe braucht ein großes Sprachmodell. Eine Klassifikation von Tickets oder Schadensmeldungen lässt sich oft mit Embeddings und wenigen Zeilen Code lösen, mit Latenzen im Millisekundenbereich und Kosten nahe null. Das ist Huyens Rat, das kleinste ausreichende Modell zu wählen, in konkreter Form.
Clustering und Themenmodellierung
Das fünfte Kapitel stammt aus Grootendorsts eigenem Fachgebiet. Die Aufgabe: Aus einer großen Menge unbeschrifteter Texte, im Buch Tausende wissenschaftliche Zusammenfassungen, Gruppen ähnlicher Inhalte finden und benennen, ohne vorher festzulegen, welche Gruppen es gibt.
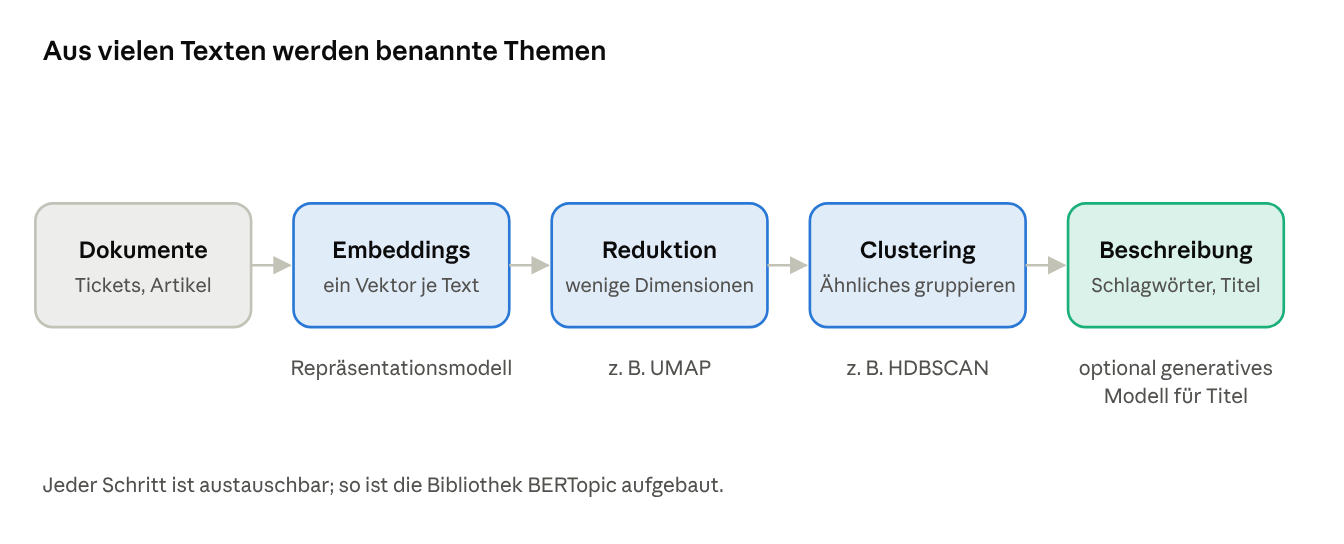
die Pipeline zur Themenmodellierung, wie sie das Buch und BERTopic verwenden
Die Schritte
| Schritt | Zweck |
|---|---|
| Embeddings | jeden Text in einen Vektor übersetzen, sodass ähnliche Texte nah beieinander liegen |
| Dimensionsreduktion | die Vektoren von Hunderten auf wenige Dimensionen verdichten, weil Clustering in sehr hohen Dimensionen schlecht funktioniert |
| Clustering | dichte Gruppen finden; das Verfahren HDBSCAN bestimmt die Zahl der Gruppen selbst und lässt Ausreißer ungruppiert |
| Beschreibung | für jede Gruppe kennzeichnende Begriffe ermitteln, etwa mit einer Variante von TF-IDF, und optional von einem generativen Modell einen lesbaren Titel erzeugen lassen |
Bausteine statt Monolith
BERTopic ist modular aufgebaut: Jeder Schritt lässt sich austauschen, etwa ein anderes Embedding-Modell, ein anderes Clustering-Verfahren oder eine andere Art der Beschreibung. Die Autoren zeigen, wie man die Beschreibung schrittweise verbessert: erst einfache Schlagwörter, dann eine Auswahl, die Wiederholungen vermeidet, schließlich ein Titel von einem Sprachmodell. Der teure Teil, das generative Modell, wird nur einmal pro Gruppe aufgerufen, nicht pro Dokument.
Anwendungen
- Ticketanalyse: Welche Arten von Problemen melden Kunden, und wie entwickeln sie sich über die Zeit?
- Freitext in Umfragen: Was sagen Mitarbeiter in offenen Antworten?
- Dokumentenbestände: Welche Themen stecken in Tausenden von Verträgen oder Berichten?
- Vorbereitung für RAG: Gruppen helfen, Dokumente zu ordnen und Lücken zu erkennen.
Einordnung
Die Pipeline ist Pipes and Filters aus EIP und das Pipeline-Muster aus Fundamentals: unabhängige, austauschbare Schritte. Dass das teure Modell nur am Ende und nur für Gruppen eingesetzt wird, ist dieselbe Abwägung, die Huyen beim Router beschreibt.
Prompting und fortgeschrittene Textgenerierung
Die Kapitel 6 und 7 überschneiden sich stark mit Huyens AI Engineering. Hier nur, was das Buch zusätzlich oder anders zeigt.
Prompt Engineering
Neben den bekannten Grundlagen, klare Anweisungen, Beispiele, Format, behandeln die Autoren Techniken für schwierigere Aufgaben:
| Technik | Idee |
|---|---|
| Prompt-Ketten | eine Aufgabe in mehrere Prompts zerlegen, deren Ausgaben aufeinander aufbauen, etwa erst einen Produktnamen, dann einen Slogan, dann eine Beschreibung |
| Gedankenkette | das Modell zuerst Zwischenschritte aufschreiben lassen, dann antworten |
| Selbstkonsistenz | mehrere Antworten erzeugen und die häufigste wählen |
| Gedankenbaum | mehrere Lösungswege parallel erkunden und bewerten |
| Ausgabe prüfen und beschränken | Ausgaben gegen ein Schema prüfen oder das Sampling auf gültige Formate einschränken |
Fortgeschrittene Generierung
Das siebte Kapitel zeigt mit LangChain, wie man ein lokal laufendes, quantisiertes Modell nutzt und um weitere Bausteine ergänzt:
- Ketten: mehrere Schritte zu einem Ablauf verbinden.
- Gedächtnis: den Gesprächsverlauf mitgeben, ganz, gekürzt oder zusammengefasst.
- Agenten: das Modell im ReAct-Muster abwechselnd überlegen und Werkzeuge aufrufen lassen.
Beim Gedächtnis zeigen die Autoren eine nützliche Abwägung:
| Art | Vorteil | Nachteil |
|---|---|---|
| Ganzer Verlauf | nichts geht verloren | Kontext wächst, Kosten steigen |
| Letzte Nachrichten | begrenzte Größe | ältere Informationen fehlen |
| Zusammenfassung | kompakt, deckt alles ab | zusätzlicher Modellaufruf, Details gehen verloren |
In Spring AI entsprechen diese Bausteine dem ChatClient mit Advisors für Gedächtnis und Kontext und der Werkzeuganbindung über @Tool, wie in der AI-Engineering-Zusammenfassung gezeigt. LangChain4j bietet ähnliche Abstraktionen mit Namen, die näher an LangChain liegen.
Einordnung
Die Gedächtnisvarianten sind klassische Cache- und Puffer-Abwägungen, wie sie Goetz u.a. bei Warteschlangen und Kleppmann bei abgeleiteten Daten beschreiben: vollständig und teuer, begrenzt und verlustbehaftet, oder verdichtet und ungenau.
Semantische Suche und RAG
Das achte Kapitel behandelt die Suche, die RAG zugrunde liegt, genauer als AI Engineering. Es unterscheidet drei Bausteine.
Dichte Suche
Dokumente und Anfrage werden mit demselben Modell in Vektoren übersetzt; gesucht wird nach den nächsten Nachbarn. Weil ein exakter Vergleich mit Millionen Vektoren zu langsam ist, nutzt man näherungsweise Nächste-Nachbarn-Suche, wie sie Vektordatenbanken und Bibliotheken wie FAISS anbieten. Wichtig sind dabei die Zerlegung langer Dokumente in Abschnitte und die Frage, ob sich Anfrage und Dokumente in Sprache und Länge ähneln.
Neu sortieren
Der zweite Baustein ist ein Reranker: Ein Modell, das jeweils Anfrage und Dokument gemeinsam liest und eine Relevanz bewertet. Das ist genauer als der Vergleich zweier getrennt berechneter Vektoren, aber zu teuer für alle Dokumente. Deshalb arbeitet man in zwei Stufen:
| Stufe | Verfahren | Menge | Eigenschaft |
|---|---|---|---|
| 1. Abruf | Vektorsuche, Volltextsuche oder beides | Millionen → etwa 50 | schnell, ungefähr |
| 2. Neu sortieren | Reranker liest Anfrage und Dokument zusammen | 50 → etwa 5 | langsam, genau |
Die Autoren zeigen, dass schon das Hinzufügen eines Rerankers zu einer bestehenden Volltextsuche die Ergebnisse deutlich verbessern kann, ohne die Suche selbst umzubauen.
// Zweistufige Suche: breit abrufen, dann genau sortieren
@Service
class PolicySearch {
    private final VectorStore vectorStore;
    private final Reranker reranker;          // eigenes Interface; Umsetzung z. B. über eine Rerank-API oder ein lokales Modell

    List<Document> search(String query) {
        List<Document> candidates = vectorStore.similaritySearch(
            SearchRequest.builder().query(query).topK(50).build());
        return reranker.rerank(query, candidates).stream()
            .limit(5)
            .toList();
    }
}

interface Reranker {
    List<Document> rerank(String query, List<Document> candidates);   // absteigend nach Relevanz
}
Erzeugen mit Quellen
Der dritte Baustein ist die Generierung: Die besten Abschnitte werden dem Sprachmodell als Kontext gegeben, mit der Anweisung, nur daraus zu antworten und die Quellen zu nennen. Die Autoren zeigen das mit einem API-Modell und mit einem lokal laufenden Modell.
Bewerten
Für die Suche nennen die Autoren klassische Maße aus der Informationssuche, etwa mittlere durchschnittliche Präzision, die berücksichtigt, ob relevante Dokumente weit oben stehen. Für RAG insgesamt verweisen sie auf Kriterien wie Faktentreue, also ob die Antwort durch die Quellen gedeckt ist, und Relevanz der Antwort.
Einordnung
Die zweistufige Suche ist ein bekanntes Muster aus der Informationssuche und entspricht Huyens hybrider Suche mit Neusortierung. Architektonisch ist der Reranker ein austauschbarer Filter in einer Pipeline; das Interface im Beispiel ist Martins Dependency Inversion: Die Suchlogik hängt nicht davon ab, ob der Reranker eine externe API oder ein lokales Modell ist.
Multimodale Modelle
Das neunte Kapitel erweitert den Blick auf Bilder. Die Grundidee ist dieselbe wie bei Text: alles in Vektoren übersetzen, sodass Ähnliches nah beieinander liegt.
Bilder als Tokens
Der Vision Transformer wendet die Transformer-Architektur auf Bilder an: Ein Bild wird in kleine Kacheln zerlegt, jede Kachel wie ein Token behandelt. So können dieselben Bausteine, die Text verarbeiten, auch Bilder verarbeiten.
Bild und Text im selben Raum
Modelle wie CLIP lernen, Bilder und Texte in denselben Vektorraum abzubilden: Das Bild eines Hundes und der Satz „ein Hund im Park“ landen nah beieinander. Das Training erfolgt mit vielen Paaren aus Bild und Bildunterschrift; das Modell lernt, passende Paare nah und unpassende fern zu platzieren. Daraus ergeben sich Anwendungen:
- Bildsuche per Text: „Zeige Fotos von Wasserschäden an Decken.“
- Bildklassifikation ohne Training: Bild mit Beschreibungen der Klassen vergleichen, wie bei der Zero-Shot-Klassifikation für Text.
- Ähnliche Bilder finden.
Sprachmodelle, die sehen
Der dritte Schritt verbindet ein Bildmodell mit einem Sprachmodell, sodass man über Bilder sprechen kann: Bildunterschriften erzeugen, Fragen zu einem Bild beantworten, Text in Bildern lesen. Die Autoren zeigen das am Beispiel von BLIP-2, bei dem eine kleine Brückenkomponente die Bildvektoren in eine Form übersetzt, die das Sprachmodell versteht. Heutige große Modelle verarbeiten Bilder meist direkt.
Einordnung
Für Geschäftsanwendungen ist das relevanter, als es zunächst scheint: Schadensfotos, gescannte Formulare, Lieferscheine, Diagramme in Berichten. Mit Spring AI lassen sich Bilder als Medien an einen Prompt anhängen, wenn das Modell sie unterstützt. Die Architekturfragen bleiben dieselben wie bei Text: Datenschutz, Kosten, Evaluation, und die Frage, ob ein kleines spezialisiertes Modell genügt.
Eigene Modelle trainieren
Der dritte Teil zeigt, wie man Modelle an eigene Daten anpasst. Er ist breiter als Raschkas Finetuning-Kapitel, weil er auch Repräsentationsmodelle abdeckt.
Embedding-Modelle erstellen und anpassen
Embedding-Modelle werden meist mit kontrastivem Lernen trainiert: Man zeigt dem Modell Paare von Texten, die zusammengehören, etwa eine Frage und ihre Antwort, und Paare, die nicht zusammengehören. Das Modell lernt, zusammengehörige Texte nah und andere fern zu platzieren.
| Ansatz | Wann sinnvoll |
|---|---|
| Vorhandenes Modell nutzen | meistens; es gibt viele gute, frei verfügbare Embedding-Modelle, deren Qualität auf öffentlichen Ranglisten verglichen wird |
| Mit eigenen Paaren feinabstimmen | wenn die Fachsprache stark vom Allgemeinen abweicht, etwa Versicherungs- oder Medizintexte |
| Ohne Beschriftungen anpassen | wenn man viele Fachtexte, aber keine Paare hat; ein Verfahren lernt, verrauschte Sätze zu rekonstruieren |
Repräsentationsmodelle für Klassifikation
| Technik | Idee |
|---|---|
| Feinabstimmung eines BERT-Modells | das ganze Modell oder nur die oberen Schichten auf beschriftete Beispiele trainieren |
| Few-Shot mit SetFit | mit nur wenigen beschrifteten Beispielen pro Klasse, etwa acht bis sechzehn: erst das Embedding-Modell kontrastiv anpassen, dann einen einfachen Klassifikator trainieren |
| Weiteres Vortraining | ein Modell zunächst auf unbeschrifteten Fachtexten weitertrainieren, dann feinabstimmen |
| Erkennung benannter Entitäten | für jedes Token klassifizieren, ob es zu einem Namen, Ort, Datum gehört |
SetFit ist für die Praxis besonders interessant: Viele Unternehmen haben nicht Tausende beschriftete Beispiele, aber ein paar Dutzend lassen sich in einer Stunde erstellen.
Generative Modelle feinabstimmen
Das letzte Kapitel behandelt die drei Phasen, die Raschka beschreibt, mit Schwerpunkt auf den beiden letzten:
- Überwachtes Finetuning mit QLoRA, also LoRA auf einem quantisierten Modell, sodass ein kleineres Sprachmodell auf einer einzelnen Grafikkarte angepasst werden kann.
- Präferenz-Finetuning: entweder klassisch mit einem eigenen Bewertungsmodell und Reinforcement Learning, oder direkter mit Verfahren wie DPO, das aus Paaren bevorzugter und abgelehnter Antworten lernt, ohne separates Bewertungsmodell.
Dazu kommt ein Abschnitt über die Bewertung generativer Modelle: öffentliche Benchmarks und ihre Grenzen, Ranglisten auf Basis menschlicher Paarvergleiche, KI als Richter und menschliche Bewertung. Das deckt sich mit Huyens Evaluationskapiteln.
Einordnung
Der Teil ergänzt Raschka um die Seite, die für Geschäftsanwendungen oft wichtiger ist: angepasste Embedding- und Klassifikationsmodelle, die klein, schnell und günstig bleiben. Huyens Faustregel gilt auch hier: erst prüfen, ob ein vorhandenes Modell mit Prompting oder Embeddings reicht, dann anpassen.
Kritik und Einordnung
Stärken
- Die Abbildungen: Rund 300 Illustrationen machen abstrakte Konzepte wie Aufmerksamkeit, Embeddings oder kontrastives Lernen anschaulich. Für visuelle Lerner ist das Buch unübertroffen.
- Über Chatbots hinaus: Klassifikation, Clustering, Themenmodellierung und Suche bekommen das Gewicht, das sie in der Praxis haben.
- Repräsentation und Generierung: Die durchgehende Unterscheidung hilft, für jede Aufgabe das passende Werkzeug zu wählen.
- Lauffähiger Code: Alle Beispiele als Notebooks, die man in Google Colab ausführen kann.
- Breite: von Grundlagen bis Präferenz-Finetuning, einschließlich Bildern.
Kritikpunkte
1. Breite statt Tiefe. Jedes Thema bekommt ein Kapitel, kaum eines wird erschöpfend behandelt. Für Evaluation ist Huyen gründlicher, für das Innere der Modelle Raschka.
2. Werkzeuge altern. Die Beispiele nutzen bestimmte Versionen von LangChain, Hugging Face und Modellen von 2024. Manches funktioniert heute anders oder ist durch bessere Modelle überholt; das GitHub-Repository wird aber gepflegt.
3. Wenig über Produktion. Wie man solche Lösungen betreibt, überwacht und weiterentwickelt, kommt kaum vor. Dafür sind Huyens beide Bücher die Ergänzung.
4. Python-Ökosystem. Für Java-Entwickler bleibt die Übertragung Eigenarbeit, besonders bei Clustering und Themenmodellierung, für die es in Java weniger fertige Bibliotheken gibt.
5. Agenten knapp. Das Kapitel über Agenten zeigt die Grundidee, spiegelt aber den Stand von 2024.
Gesamturteil
Das zugänglichste Buch der KI-Reihe und der beste Überblick, was man mit Sprachmodellen praktisch tun kann. Für Architekten besonders wertvoll ist die Erinnerung, dass viele Aufgaben mit Embeddings und kleinen Modellen besser gelöst sind als mit großen Chat-Modellen. Wer Huyen für das Wie im Betrieb und Raschka für das Innere liest, bekommt hier das Was dazwischen.
Bezüge zur Reihe
Die ersten drei KI-Bücher
| Huyen, AI Engineering | Raschka, Build an LLM | Alammar und Grootendorst, Hands-On LLMs | |
|---|---|---|---|
| Frage | Wie baue und betreibe ich zuverlässige Anwendungen? | Wie funktioniert ein Sprachmodell innen? | Was kann ich mit Sprachmodellen praktisch tun? |
| Stärke | Evaluation, Architektur, Betrieb | Verständnis durch eigenen Code | Breite der Anwendungen, Abbildungen |
| Code | kaum | durchgehend, selbst geschrieben | durchgehend, mit Bibliotheken |
| Für wen | Anwendungsentwickler, Architekten | Neugierige, die verstehen wollen | Praktiker, die ausprobieren wollen |
Weitere Bezüge
| Thema bei Alammar und Grootendorst | Bezug in der Reihe |
|---|---|
| Kleine Repräsentationsmodelle statt großer Chat-Modelle | Huyen: kleinstes ausreichendes Modell, Router |
| Zero-Shot über Embeddings | Huyen: Kontext statt Training |
| Pipeline zur Themenmodellierung | Hohpe und Woolf: Pipes and Filters; Richards und Ford: Pipeline-Stil |
| Teures Modell nur einmal pro Gruppe | Huyen: Kosten, Batch; Sedgewick: Wachstumsordnung |
| Zweistufige Suche mit Reranker | Huyen: hybride Suche; Kleppmann: Indexe |
| Reranker als austauschbare Komponente | Martin: Dependency Inversion; Gang of Four: Strategy |
| Verbesserungen seit GPT-2 | Raschka: GPT-2 als Grundlage; Raschka: Bonusmaterial |
| Gedächtnisvarianten | Goetz u.a.: Puffer; Kleppmann: abgeleitete Daten |
| Few-Shot mit SetFit | Huyen: Dataset Engineering, wenige gute Beispiele |
| Evaluation generativer Modelle | Huyen: Evaluation, KI als Richter |
Diskussionsfragen
- Repräsentation oder Generierung: Welche KI-Aufgaben in deinem Umfeld werden mit großen Chat-Modellen gelöst, obwohl Embeddings und ein kleiner Klassifikator reichen würden?
- Klassifikation: Welche Kategorisierung, etwa von Tickets, Meldungen oder E-Mails, könntet ihr mit Zero-Shot über Embeddings ausprobieren?
- Themen finden: Gibt es bei euch große Mengen Freitext, aus denen Themen gewonnen werden könnten?
- Suche: Wie gut ist eure interne Suche? Würde ein Reranker hinter der bestehenden Volltextsuche helfen?
- Bilder: Gibt es Prozesse mit Fotos oder gescannten Dokumenten, für die multimodale Modelle sinnvoll wären?
- Wenige Beispiele: Wie viele beschriftete Beispiele bräuchtet ihr für eine eigene Klassifikation, und wer könnte sie erstellen?
- Java: Welche der gezeigten Techniken fehlen dir im Java-Ökosystem am meisten?
- Weiter: Als Nächstes Huyens Designing Machine Learning Systems, das Betrieb, Daten und Monitoring von ML-Systemen behandelt.