Growing Object-Oriented Software, Guided by Tests – Zusammenfassung und Einordnung
Steve Freeman, Nat Pryce, Growing Object-Oriented Software, Guided by Tests (2009)
Einleitung
Beck zeigte TDD an Geld und einem Testframework, also an Problemen ohne Datenbank, Netzwerk und Oberfläche. Freeman und Pryce zeigen, wie TDD in einem echten System funktioniert, mit Nachrichtenprotokoll, grafischer Oberfläche und Nebenläufigkeit, und wie man dabei objektorientiertes Design wachsen lässt.
Autoren und Kontext
Steve Freeman und Nat Pryce gehören zum Londoner Kreis um den Extreme Tuesday Club, eine Runde von Entwicklern, die sich ab Ende der 1990er regelmäßig traf und viele Ideen zu Extreme Programming und TDD entwickelte. Aus diesem Kreis stammen auch die Mock Objects: Freeman war Mitautor des Artikels Endo-Testing: Unit Testing with Mock Objects (2000), und mit Pryce, Tim Mackinnon und Joe Walnes schrieb er 2004 den einflussreichen Artikel Mock Roles, not Objects. Freeman und Pryce haben zudem die Bibliothek jMock und die Matcher-Bibliothek Hamcrest mitentwickelt.
Das Buch erschien 2009 und gilt als Hauptwerk der sogenannten London-Schule des TDD. Die Beispiele sind in Java.
Aufbau
| Teil | Kapitel | Inhalt |
|---|---|---|
| I. Einführung | 1–3 | Wozu TDD, TDD mit Objekten, Werkzeuge (JUnit, Hamcrest, jMock) |
| II. Der Prozess | 4–8 | Walking Skeleton, den Zyklus aufrechterhalten, objektorientierter Stil, Design erreichen, Fremdcode einbinden |
| III. Ein durchgearbeitetes Beispiel | 9–19 | der „Auction Sniper“, eine Anwendung, die automatisch auf Online-Auktionen bietet |
| IV. Nachhaltiges TDD | 20–24 | auf Tests hören, Lesbarkeit, Testdaten, Diagnose, Flexibilität |
| V. Fortgeschrittene Themen | 25–27 | Persistenz, Threads, asynchroner Code |
Teil III nimmt rund ein Drittel des Buchs ein. Wie Beck und Fowler wollen die Autoren die Methode zeigen, nicht nur beschreiben, und das an einem Beispiel, das die Schwierigkeiten echter Software enthält.
Grundhaltung
Die Autoren sehen TDD nicht in erster Linie als Testtechnik, sondern als Designtechnik: Tests treiben das Design, und wenn ein Test schwer zu schreiben ist, sagt das etwas über das Design. Objekte verstehen sie im Sinne von Alan Kay als Netzwerk von Objekten, die sich Nachrichten schicken, nicht als Datenbehälter mit Methoden. Mocks sind für sie kein Mittel zum Isolieren, sondern ein Werkzeug, um herauszufinden, welche Rollen und Schnittstellen ein Objekt von seinen Nachbarn braucht.
Wozu TDD? Die doppelte Schleife
Die Autoren nennen drei Gründe für TDD: Tests liefern Feedback über die Korrektheit, Tests als Spezifikation helfen, das Problem zu verstehen, und Tests geben Feedback über das Design. Der dritte Punkt ist für sie der wichtigste.
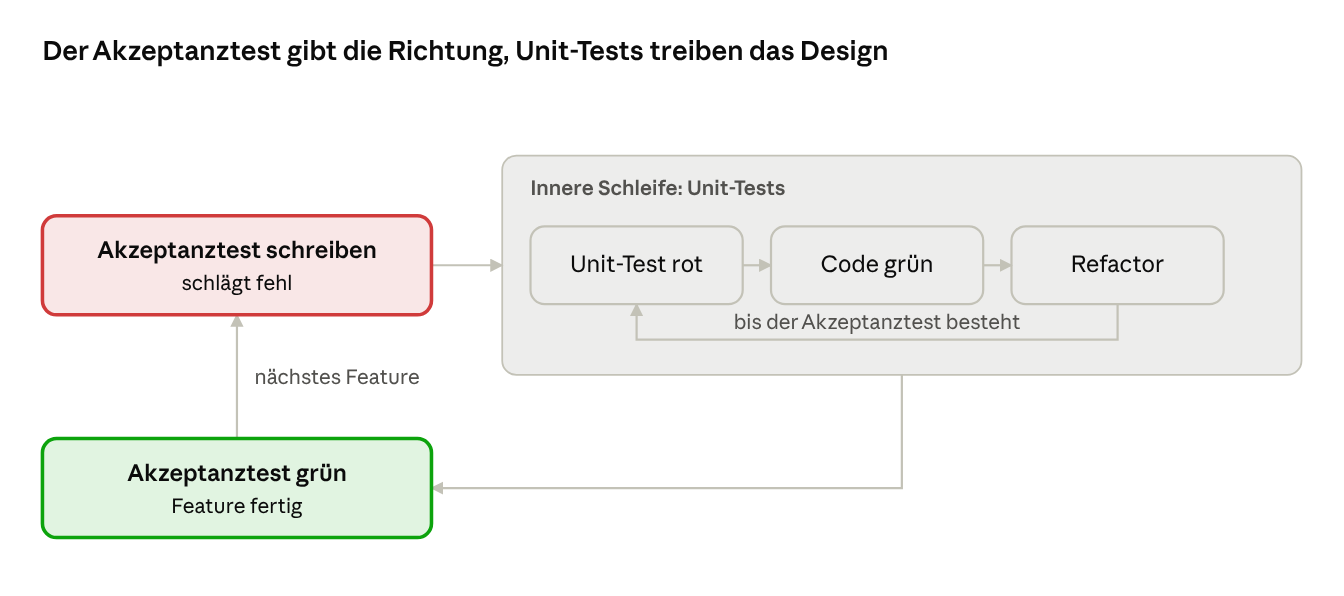
die doppelte Schleife · Akzeptanztest außen, Unit-Tests innen
Zwei Schleifen
Das Herzstück des Buchs ist eine Erweiterung von Becks Zyklus:
- Äußere Schleife: Man beginnt jedes Feature mit einem Akzeptanztest, der das System von außen prüft, über seine echten Schnittstellen. Er schlägt zunächst fehl und bleibt rot, bis das Feature fertig ist.
- Innere Schleife: Innerhalb dieses roten Akzeptanztests arbeitet man im gewohnten Rot-Grün-Refactor-Zyklus mit Unit-Tests, Objekt für Objekt.
- Wenn der Akzeptanztest grün wird, ist das Feature fertig, und man beginnt mit dem nächsten.
Der Akzeptanztest gibt die Richtung vor und sagt, wann man fertig ist. Die Unit-Tests treiben das Design der einzelnen Objekte. Beides zusammen verhindert, dass man perfekte Einzelteile baut, die nicht zusammenpassen, ein Einwand, den Thomas und Hunt und Ousterhout gegen reines Unit-TDD erhoben haben.
End-to-End wirklich meinen
Die Autoren bestehen darauf, dass Akzeptanztests wirklich von Ende zu Ende laufen: über das echte Netzwerk, die echte Oberfläche, mit echter Infrastruktur, und zwar automatisiert im Build. Ein Akzeptanztest, der intern Objekte aufruft, verpasst gerade die Probleme, die an den Grenzen entstehen, etwa bei Deployment, Konfiguration oder Kommunikation.
Sie unterscheiden drei Testebenen:
| Ebene | Prüft | Frage |
|---|---|---|
| Akzeptanztest | ob das ganze System funktioniert | Funktioniert es? |
| Integrationstest | ob unser Code mit fremdem Code zusammenarbeitet | Funktioniert unser Code mit dem, was wir nicht ändern können? |
| Unit-Test | ob ein Objekt seine Aufgabe erfüllt und gut zu benutzen ist | Tun unsere Objekte das Richtige, und sind sie bequem zu nutzen? |
Der letzte Teil der letzten Frage ist typisch für das Buch: Ein Unit-Test prüft nicht nur Verhalten, sondern auch die Benutzbarkeit der Schnittstelle. Wer ein Objekt im Test mühsam aufbauen muss, wird es auch im Produktionscode mühsam aufbauen müssen.
Der Start: Walking Skeleton
Der erste Akzeptanztest ist der schwierigste, weil es noch nichts gibt, das man testen könnte. Die Antwort der Autoren ist das Walking Skeleton: eine winzige Version des Systems, die schon alle Schichten von Ende zu Ende durchläuft, automatisch gebaut, ausgeliefert und getestet.
Was zum Skelett gehört
- ein Build, der alles kompiliert und paketiert
- ein automatisches Deployment in eine produktionsähnliche Umgebung
- ein erster Akzeptanztest, der das ausgelieferte System über seine echten Schnittstellen anspricht
- eine minimale Funktion, die genau diesen Test besteht
Das Skelett kann fast nichts, aber es kann laufen. Alles Weitere wird daran angebaut.
Warum so früh?
Die Autoren argumentieren, dass die riskantesten Teile eines Projekts oft nicht die Fachlogik sind, sondern Infrastruktur, Deployment, Integration mit Fremdsystemen und organisatorische Hürden wie Zugänge, Firewalls oder Freigaben. Wer diese Fragen zu Beginn klärt, entdeckt Probleme früh, wenn sie noch billig zu lösen sind.
Sie empfehlen, sich bewusst zu fragen: Wie würden wir das System ausliefern und testen? Und sie warnen, dass der erste Schritt oft länger dauert, als man denkt. Das ist kein Fehlschlag, sondern genau die Information, die man braucht.
Beziehung zu anderen Büchern
- Das Walking Skeleton ist Thomas‘ und Hunts Tracer Bullet, mit dem Unterschied, dass es von Anfang an automatisiert ausgeliefert und getestet wird.
- Es entspricht McConnells T-förmiger Integration und dem täglichen Build mit Smoke Test.
- Es setzt vorweg, was Accelerate Jahre später mit Daten stützt: Deployment-Automatisierung und Continuous Delivery von Anfang an.
Den Zyklus aufrechterhalten
Nach dem Skelett geht es Feature für Feature weiter, jedes mit einem neuen Akzeptanztest. Die Autoren raten:
- Den nächsten Akzeptanztest so wählen, dass er das System in kleinen Schritten erweitert und früh Rückmeldung bringt.
- Fehlschlagende Akzeptanztests unterscheiden: solche, die ein noch nicht fertiges Feature beschreiben, und solche, die eine Regression anzeigen. Letztere müssen sofort repariert werden.
- Tests aus der Sicht des Nutzers formulieren, in der Sprache der Domäne, nicht in technischen Details.
- Unit-Tests für Verhalten schreiben, nicht für Methoden: Ein Test beschreibt, was ein Objekt in einer Situation tun soll, nicht, wie eine Methode implementiert ist.
- Auf die Tests hören: Wenn ein Test schwer zu schreiben ist, ist das ein Hinweis auf ein Designproblem, dazu mehr in Teil IV.
Objektorientierter Stil
Die Kapitel 6 und 7 beschreiben, welches Design die Autoren anstreben. Es ist ein deutlich anderes Bild von Objektorientierung als bei vielen Java-Projekten mit Entitäten, Services und Getter-Setter-Klassen.
Werte und Objekte
Die Autoren trennen streng zwischen zwei Arten von Dingen:
| Werte | Objekte | |
|---|---|---|
| Identität | keine; zwei gleiche Werte sind austauschbar | ja; ein Objekt bleibt dasselbe, auch wenn es sich ändert |
| Zustand | unveränderlich | veränderlich, aber verborgen |
| Zweck | Daten und Berechnungen | Verhalten und Kommunikation mit anderen Objekten |
| Testen | direkt mit Ergebnisprüfung | über die Nachrichten an Nachbarn |
| Mocken | nie | ja, über ihre Rollen |
Das entspricht Evans‘ Unterscheidung von Value Objects und Entities, nur mit Blick auf das Testen.
Objekte als Netzwerk
Im Sinne von Alan Kay ist ein System ein Netzwerk von Objekten, die sich Nachrichten schicken. Das Verhalten entsteht nicht in einzelnen Objekten, sondern aus ihrem Zusammenspiel. Daraus folgt: Um das System zu ändern, ändert man oft nicht Code in Objekten, sondern die Art, wie sie zusammengesetzt werden.
Drei Arten von Nachbarn
Ein Objekt hat typischerweise drei Arten von Beziehungen zu anderen Objekten, die die Autoren Peer-Stereotypen nennen:
| Art | Bedeutung | Übergabe |
|---|---|---|
| Abhängigkeiten | Dienste, ohne die das Objekt nicht arbeiten kann | im Konstruktor, Pflicht |
| Benachrichtigungen | Nachbarn, die über Ereignisse informiert werden wollen; dem Objekt ist egal, ob jemand zuhört | oft per Setter oder Listener, mit Standard „niemand hört zu“ |
| Anpassungen | Richtlinien oder Strategien, die das Verhalten verändern | im Konstruktor mit sinnvollem Standardwert |
public class AuctionMessageTranslator {
    private final String sniperId;                  // Wert
    private final AuctionEventListener listener;    // Benachrichtigung
    private final FailureReporter failureReporter;  // Abhängigkeit

    public AuctionMessageTranslator(String sniperId, AuctionEventListener listener,
                                    FailureReporter failureReporter) { … }
}
Kontextunabhängigkeit
Ein Objekt soll nichts über das System wissen, in dem es läuft. Alles, was es braucht, bekommt es von außen übergeben. Das macht es in anderen Zusammenhängen und vor allem im Test wiederverwendbar. Die Autoren nennen das Context Independence. Es ist Feathers‘ Seam-Gedanke als Designziel statt als nachträgliche Reparatur.
Das Ganze ist einfacher als die Summe der Teile
Ein zusammengesetztes Objekt soll eine einfachere Schnittstelle haben als die Teile, aus denen es besteht. Es verbirgt deren Zusammenspiel. Das ist Ousterhouts tiefes Modul, aus einer anderen Richtung erreicht.
Wie neue Objekte entstehen
Die Autoren beschreiben drei Wege, auf denen beim Refactoring neue Typen entstehen:
- Herauslösen: Ein Objekt wird zu groß, ein Teil wird zu einem eigenen Objekt.
- Abspalten: Ein neues Konzept taucht auf, etwa ein Wert, der bisher als
Stringoderintherumgereicht wurde, und bekommt einen eigenen Typ. - Bündeln: Mehrere Objekte arbeiten immer zusammen und werden unter einem neuen Objekt zusammengefasst, das sie verbirgt.
Der dritte Weg, das Bündeln, fehlt bei Martin weitgehend und entspricht Becks One Pile und Fowlers Inline Class: Zusammenlegen ist ebenso Design wie Zerlegen.
Tell, Don’t Ask
Objekte sollen anderen Objekten sagen, was sie tun sollen, statt deren Zustand abzufragen und selbst zu entscheiden. Abfragen sind erlaubt, aber sparsam, vor allem für Werte.
Mocks als Designwerkzeug
Der bekannteste und umstrittenste Teil des Buchs. Für die Autoren sind Mocks kein Werkzeug, um Abhängigkeiten wegzuschalten, sondern ein Werkzeug, um Schnittstellen zu entdecken.
Rollen mocken, nicht Objekte
Der Titel ihres Artikels von 2004 fasst die Idee zusammen. Wenn man einen Test für ein Objekt schreibt, fragt man: Was braucht dieses Objekt von seinen Nachbarn? Die Antwort ist eine Rolle, ausgedrückt als Interface, benannt aus der Sicht des Objekts, das sie braucht. Im Test wird diese Rolle gemockt. Das echte Objekt, das die Rolle später erfüllt, entsteht im nächsten Schritt, wieder testgetrieben.
So arbeitet man sich von außen nach innen durch das System: Jeder Test für ein Objekt definiert die Schnittstellen zu den Objekten eine Ebene tiefer.
// Schritt 1: Test für den Sniper. Er braucht eine Rolle "Auction", die es noch nicht gibt.
@Test
void bidsHigherWhenNewPriceArrivesFromOtherBidder() {
    Auction auction = mock(Auction.class);             // Rolle entdeckt
    SniperListener listener = mock(SniperListener.class);
    var sniper = new AuctionSniper(ITEM_ID, auction, listener);

    sniper.currentPrice(1001, 25, PriceSource.FromOtherBidder);

    verify(auction).bid(1001 + 25);                    // Befehl erwartet
    verify(listener).sniperBidding(any());             // Benachrichtigung erwartet
}

// Schritt 2: Die Rolle wird als Interface festgehalten, aus Sicht des Snipers benannt.
public interface Auction {
    void bid(int amount);
    void join();
}
Das Interface Auction beschreibt nicht, wie die Auktion technisch funktioniert, sondern was der Sniper von ihr braucht. Die Implementierung über ein Nachrichtenprotokoll entsteht später.
Die Regeln für Mocks
| Regel | Bedeutung |
|---|---|
| Rollen mocken, nicht Klassen | Mocks für Interfaces, die eine Rolle beschreiben, nicht für konkrete Klassen |
| Keine Werte mocken | Werte wie Money oder Date echt erzeugen; wenn das schwer ist, fehlt ein Builder oder eine Fabrik |
| Nur eigene Typen mocken | keine Fremd-APIs mocken, sondern eigene Adapter darum bauen (nächster Abschnitt) |
| Abfragen erlauben, Befehle erwarten | Abfragen, die nichts verändern, werden nur mit Rückgabewerten versorgt; Befehle, die etwas bewirken, werden geprüft |
| Pro Test auf eine Sache konzentrieren | nur die Interaktionen prüfen, um die es im Test geht |
Die vierte Regel ist entscheidend für robuste Tests. Wer jeden Aufruf prüft, bekommt Tests, die bei jedem Refactoring brechen.
// Abfrage: nur stubben, nicht prüfen
when(priceCatalog.priceFor(ITEM_ID)).thenReturn(Money.of(100));

// Befehl: prüfen, weil er die Wirkung ist
verify(orderGateway).place(any(Order.class));
Das ist im Kern Command-Query-Separation aus Clean Code, angewandt auf Tests.
Warum Mocks hier Design sind
Die Autoren sehen Mocks als Rückmeldung: Wenn ein Objekt viele Nachbarn braucht, sieht man das im Test sofort an vielen Mocks. Wenn eine Rolle viele Methoden hat, sieht man es an langen Erwartungslisten. Wenn man konkrete Klassen mocken muss, fehlt eine Abstraktion. Der Test macht das Design sichtbar, bevor es im Produktionscode verfestigt ist.
Fremdcode: nur eigene Typen mocken
Das achte Kapitel enthält eine der wichtigsten Regeln des Buchs, die in der Praxis oft missachtet wird: Mocke nur Typen, die du selbst besitzt.
Warum keine Fremd-APIs mocken?
- Man kontrolliert ihr Design nicht. Ein Mock soll Rückmeldung über das Design geben. Bei einer fremden API kann man auf diese Rückmeldung nicht reagieren.
- Der Mock kann falsch sein. Wer eine fremde Bibliothek mockt, schreibt sein Verständnis von ihr in den Test. Ist das Verständnis falsch, bestehen die Tests, und das System fällt in Produktion.
- Fremde APIs sind oft unhandlich. Sie sind für viele Zwecke gebaut und haben mehr Methoden, als man braucht. Mocks dafür werden lang und zerbrechlich.
Stattdessen: Adapter
Man baut eine dünne Schicht von Adaptern, die die fremde API in die Begriffe der eigenen Anwendung übersetzt. Die eigene Anwendung hängt nur von eigenen Interfaces ab, und diese werden in Unit-Tests gemockt. Die Adapter selbst werden mit Integrationstests gegen die echte Bibliothek geprüft.
// eigene Rolle, aus Sicht der Anwendung
public interface Notifier {
    void notifyCustomer(CustomerId id, Message message);
}

// Adapter auf eine Fremdbibliothek; wird mit echtem SMTP-Testserver geprüft
class SmtpNotifier implements Notifier {
    private final JavaMailSender mailSender;
    private final CustomerDirectory directory;
    public void notifyCustomer(CustomerId id, Message message) {
        var mail = new SimpleMailMessage();
        mail.setTo(directory.emailOf(id));
        mail.setText(message.text());
        mailSender.send(mail);
    }
}

// Unit-Test der Anwendung: Mock der eigenen Rolle, nicht von JavaMailSender
Notifier notifier = mock(Notifier.class);
Einordnung
Diese Regel verbindet mehrere Fäden der Reihe:
- Grenning in Clean Code: fremden Code hinter eigenen Schnittstellen einkapseln, Learning Tests schreiben.
- Evans: der Anticorruption Layer, nur auf Klassenebene.
- Hexagonal Architecture: Ports als eigene Interfaces, Adapter als Implementierung.
- Kleppmann: Entfernte Aufrufe verhalten sich anders als lokale, und ein Mock verdeckt genau diese Unterschiede.
In der Praxis ist das Mocken von Fremd-APIs, etwa von HTTP-Clients, JPA-EntityManagern oder Cloud-SDKs, eine der häufigsten Ursachen für Tests, die grün sind, obwohl das System nicht funktioniert. Mit Werkzeugen wie Testcontainers, WireMock oder eingebetteten Servern lassen sich die Adapter heute leicht gegen echte oder realistische Gegenstellen testen.
Das Beispiel: Auction Sniper
Teil III ist ein durchgehendes Projekt über elf Kapitel. Die Anwendung ist ein Auction Sniper: ein Programm, das automatisch bei Online-Auktionen mitbietet, bis zu einem festgelegten Höchstpreis.
Die technische Umgebung
Das Beispiel ist bewusst nicht trivial:
- Die Auktionen laufen auf einem Server, mit dem der Sniper über XMPP kommuniziert, ein Chat-Protokoll, das hier als Nachrichtenkanal dient.
- Die Oberfläche ist eine Swing-Anwendung, die den Zustand jeder Auktion anzeigt: Beitreten, Bieten, Führend, Verloren, Gewonnen.
- Nachrichten kommen asynchron auf anderen Threads an als die Oberfläche läuft.
In den Akzeptanztests simuliert ein Fake Auction Server die Auktion über das echte Protokoll, und ein Testtreiber bedient die echte Oberfläche.
Wie das System wächst
Die Autoren entwickeln das System Feature für Feature, jedes mit einem eigenen Akzeptanztest:
| Schritt | Akzeptanztest | Was im Design entsteht |
|---|---|---|
| 1 | Sniper tritt einer Auktion bei und verliert, ohne zu bieten | Walking Skeleton: Build, Server, Oberfläche, Verbindung |
| 2 | Sniper bietet, wenn jemand anderes bietet | Übersetzung von Nachrichten in Ereignisse; die Rolle „Auction“ |
| 3 | Sniper gewinnt eine Auktion | Zustände des Snipers, Unterscheidung eigener und fremder Gebote |
| 4 | Mehrere Auktionen gleichzeitig | Tabelle in der Oberfläche, Trennung von Verbindung und Auktion |
| 5 | Neue Auktionen über die Oberfläche hinzufügen | ein „Portfolio“ von Snipers, Fabriken für Objekte |
| 6 | Höchstpreis, bei dem der Sniper aufhört | neue Zustände, Werteobjekte für Schnappschüsse des Zustands |
| 7 | Fehlerhafte Nachrichten und Verbindungsprobleme | Fehlerbehandlung, Protokollierung über eine eigene Rolle |
Was das Beispiel zeigt
- Das Design entsteht in kleinen Schritten. Zu Beginn steckt fast alles in der Hauptklasse. Mit jedem Feature wandern Verantwortlichkeiten in neue Objekte, und die Hauptklasse wird zu einem Ort, an dem nur noch das Objektnetzwerk zusammengesetzt wird.
- Übersetzung und Logik werden getrennt. Ein Objekt übersetzt XMPP-Nachrichten in fachliche Ereignisse, ein anderes enthält die Bietlogik. Die Bietlogik weiß nichts von XMPP.
- Werte entstehen spät, aber gezielt. Der Zustand eines Snipers wird irgendwann zu einem unveränderlichen Schnappschuss, der durch das System gereicht wird.
- Refactoring ist Alltag. Die Autoren zeigen auch Umwege und Rückbauten, etwa Klassen, die sie später wieder zusammenführen oder umbenennen.
- Benachrichtigungsketten: Ereignisse wandern über Listener von der Netzwerkschicht über die Logik zur Oberfläche, und jede Schicht kennt nur ihre direkten Nachbarn.
Einordnung
Das Beispiel ist das, was Beck in Test-Driven Development fehlte: ein System mit Netzwerk, Oberfläche und Nebenläufigkeit. Es ist allerdings auch das Teil des Buchs, das am stärksten gealtert ist: XMPP, Swing und jMock sind heute selten. Die Prinzipien lassen sich aber direkt auf eine Spring-Anwendung mit REST, Kafka und einer Weboberfläche übertragen.
Nachhaltiges TDD (Teil IV)
Der vierte Teil ist für viele Leser der wertvollste: Er behandelt, wie Tests über Jahre lesbar, aussagekräftig und flexibel bleiben, statt zur Last zu werden.
Auf die Tests hören
Das zentrale Kapitel: Schmerz beim Testen ist ein Designsignal. Die Autoren listen typische Testprobleme und was sie über den Produktionscode verraten.
| Testproblem | Was es über das Design sagt |
|---|---|
| Ein Objekt lässt sich nicht ersetzen, etwa ein Singleton oder statischer Aufruf | versteckte Abhängigkeit; sie sollte übergeben werden |
| Man muss eine konkrete Klasse mocken | eine Rolle fehlt; ein Interface sollte sie benennen |
| Ein Konstruktor braucht sehr viele Argumente | einige davon gehören zusammen und bilden ein eigenes Objekt |
| Ein Objekt hat viele unabhängige Verantwortungen, die Tests sind verwirrend | das Objekt ist „verwirrt“ und sollte geteilt werden |
| Ein Test braucht sehr viele Erwartungen | das Objekt kennt zu viele Nachbarn oder macht zu viel |
| Logging muss im Test berücksichtigt werden | Logging für den Betrieb ist ein Feature und gehört hinter eine eigene Rolle; Debug-Logging ist etwas anderes |
| Man muss Zeit oder Zufall kontrollieren | Uhr und Zufallsquelle sollten als Abhängigkeit übergeben werden |
Das ist im Kern Becks Beobachtung aus TDD-Kapitel 32 und Feathers‘ Seam-Denken, systematisch ausgearbeitet.
// schwer testbar: Zeit ist versteckt
boolean isExpired() { return Instant.now().isAfter(expiresAt); }

// testbar: Uhr als Abhängigkeit
boolean isExpired(Clock clock) { return Instant.now(clock).isAfter(expiresAt); }
// im Test: Clock.fixed(Instant.parse("2026-10-30T12:00:00Z"), ZoneOffset.UTC)
Lesbare Tests
- Testnamen beschreiben Verhalten, etwa
notifiesListenerWhenAuctionCloses, nichttestClose. Liest man alle Testnamen einer Klasse untereinander, ergibt sich eine Spezifikation. - Einheitliche Struktur: vorbereiten, ausführen, prüfen, aufräumen.
- Literale benennen: Statt
bid(1098)lieberbid(PRICE + INCREMENT)oder eine Konstante, die den Sinn erklärt. - Testcode schlank halten: Hilfsmethoden und Matcher, die den Test wie eine Spezifikation lesen lassen.
Testdaten aufbauen: Test Data Builder
Komplexe Testobjekte mit vielen Konstruktorargumenten machen Tests unlesbar und zerbrechlich: Ändert sich der Konstruktor, brechen Hunderte Tests. Die Autoren nutzen Test Data Builder mit sinnvollen Standardwerten, bei denen jeder Test nur das angibt, was für ihn wichtig ist.
class OrderBuilder {
    private CustomerId customer = new CustomerId("C-1");
    private List<OrderLine> lines = List.of(new OrderLine("SKU-1", 1, Money.of(10)));
    private Address shipTo = AddressBuilder.anAddress().build();

    static OrderBuilder anOrder() { return new OrderBuilder(); }
    OrderBuilder from(CustomerId c)            { this.customer = c; return this; }
    OrderBuilder withLines(OrderLine... ls)    { this.lines = List.of(ls); return this; }
    OrderBuilder shippedTo(Address a)          { this.shipTo = a; return this; }
    Order build() { return new Order(customer, lines, shipTo); }
}

// im Test: nur das Wesentliche sichtbar
var order = anOrder().shippedTo(anAddress().inCountry("CH").build()).build();
Das ist der Builder aus Effective Java, eingesetzt für Lesbarkeit und Robustheit von Tests.
Diagnose
Ein fehlschlagender Test soll sofort sagen, was falsch ist. Die Autoren empfehlen aussagekräftige Fehlermeldungen, Matcher, die relevante Details hervorheben, selbstbeschreibende Testwerte mit gutem toString und, wie Beck, jeden Test einmal bewusst fehlschlagen zu lassen, um die Meldung zu prüfen.
Flexible Tests
Tests sollen genau das festlegen, was wichtig ist, und nicht mehr:
- Information prüfen, nicht Darstellung: etwa ob ein Fehler gemeldet wird, nicht den genauen Wortlaut.
- Präzise, aber nicht übergenau prüfen: nur die relevanten Felder vergleichen.
- Abfragen erlauben, Befehle erwarten.
- Reihenfolge nur prüfen, wenn sie wichtig ist.
Übergenaue Tests sind die Hauptursache dafür, dass Mock-lastige Testsuiten bei jedem Refactoring zerbrechen, und genau das wird der London-Schule oft vorgeworfen. Die Autoren kannten das Problem und haben diese Regeln dagegen formuliert.
Fortgeschrittene Themen (Teil V)
Die letzten drei Kapitel behandeln die Bereiche, in denen TDD in der Praxis am häufigsten aufgegeben wird: Datenbanken, Threads und asynchroner Code.
Persistenz testen
- Keine Datenbanken mocken. Persistenzcode wird gegen eine echte Datenbank getestet, sonst testet man nur sein eigenes Verständnis von SQL und ORM.
- Tests unabhängig halten: Jeder Test räumt vor sich auf oder läuft in einer eigenen Transaktion, damit Reihenfolge keine Rolle spielt.
- Round-Trip-Tests: ein Objekt speichern, wieder laden und vergleichen. Das deckt fehlende Felder und Abbildungsfehler zuverlässig auf.
- Transaktionsgrenzen ausdrücklich testen, statt sie implizit vorauszusetzen.
Mit Testcontainers ist das heute deutlich einfacher als 2009, als man dafür lokale Datenbanken installieren und pflegen musste.
@Testcontainers
class OrderRepositoryIT {
    @Container static PostgreSQLContainer<?> db = new PostgreSQLContainer<>("postgres:16");

    @Test
    void roundTripsAnOrder() {
        var order = anOrder().withLines(line("SKU-1", 2)).build();
        repository.save(order);
        assertThat(repository.findById(order.id())).contains(order);
    }
}
Unit-Tests und Threads
Die wichtigste Regel: Funktionalität und Nebenläufigkeit trennen. Die Logik wird synchron getestet, die Nebenläufigkeit getrennt.
- Ein Objekt sollte keine eigenen Threads starten, sondern einen
Executorübergeben bekommen. - Im Unit-Test übergibt man einen Executor, der Aufgaben im selben Thread oder auf Kommando ausführt. Dann ist der Test deterministisch.
- Die Threadsicherheit wird mit eigenen Stresstests geprüft, die viele Threads gleichzeitig auf ein Objekt loslassen. Sie können Fehler nicht beweisen, aber wahrscheinlicher sichtbar machen.
// deterministischer Executor für Unit-Tests
class DeterministicExecutor implements Executor {
    private final Queue<Runnable> tasks = new ArrayDeque<>();
    public void execute(Runnable r) { tasks.add(r); }
    void runUntilIdle() { while (!tasks.isEmpty()) tasks.poll().run(); }
}
Asynchronen Code testen
Akzeptanztests über echte Netzwerke und Oberflächen sind zwangsläufig asynchron. Das größte Problem sind flackernde Tests, die mal grün, mal rot sind.
- **Kein **
Thread.sleep: Feste Wartezeiten sind entweder zu kurz, dann flackert der Test, oder zu lang, dann ist die Suite langsam. - Abfragen bis zum Erfolg oder Timeout: Den erwarteten Zustand in kurzen Abständen prüfen, bis er eintritt oder eine Obergrenze erreicht ist.
- Auf sichtbare Wirkungen warten: nicht auf interne Zustände, sondern auf etwas, das ein Nutzer bemerken würde.
- Erfolg und Fehlschlag unterscheidbar machen: Ein Test darf nicht grün werden, nur weil er zu früh nachgesehen hat, bevor etwas schiefging.
In Java leistet die Bibliothek Awaitility heute genau das, was die Autoren damals von Hand gebaut haben:
await().atMost(Duration.ofSeconds(5))
       .untilAsserted(() -> assertThat(ui.statusOf(ITEM_ID)).isEqualTo("Gewonnen"));
Einordnung
Diese Kapitel ergänzen Feathers, der Persistenz und Threads vor allem als Hindernisse für Tests behandelt, und Bloch, der Nebenläufigkeit aus Sicht der Korrektheit betrachtet. Die Trennung von Logik und Nebenläufigkeit ist zugleich ein gutes Design: Sie entspricht Weidigs funktionalem Kern mit einer dünnen Schale für Seiteneffekte.
Kritik und Einordnung
GOOS gilt vielen als das beste Buch über TDD in echten Systemen. Gleichzeitig ist es die Grundlage einer Schule, die in den Jahren danach stark kritisiert wurde, oft für Dinge, vor denen das Buch selbst warnt.
Stärken
- Echtes System: Netzwerk, Oberfläche, Nebenläufigkeit. Hier sieht man TDD dort, wo es schwer ist.
- Doppelte Schleife: Akzeptanztests geben die Richtung, Unit-Tests das Design. Das beantwortet den Einwand, TDD baue lokal gute, global unpassende Teile.
- Walking Skeleton: Deployment und Infrastruktur von Anfang an, Jahre bevor Continuous Delivery Allgemeingut wurde.
- Auf die Tests hören: die beste Darstellung, wie Testprobleme auf Designprobleme hinweisen.
- Regeln für robuste Mocks: nur eigene Typen, keine Werte, Abfragen erlauben, Befehle erwarten.
- Teil IV: Lesbarkeit, Testdaten-Builder, Diagnose und Flexibilität sind unabhängig von der Schule wertvoll.
Kritikpunkte
1. Zerbrechliche Tests durch Mocks. Der häufigste Einwand gegen die London-Schule: Tests, die Interaktionen prüfen, hängen eng an der Implementierung und brechen bei Refactorings. Die Autoren haben Regeln dagegen formuliert, aber in der Praxis werden sie oft nicht befolgt. Das Ergebnis sind Testsuiten, die jeden Methodenaufruf festschreiben.
2. Viele kleine Interfaces. Der Ansatz erzeugt viele Rollen-Interfaces mit oft nur einer Implementierung. Aus Ousterhouts Sicht kann das zu flachen Modulen und Classitis führen. Die Autoren würden antworten, dass die Rolle aus Sicht des Aufrufers eine eigene, wertvolle Abstraktion ist.
3. Testgetriebener Designschaden. Der Vorwurf von David Heinemeier Hansson von 2014 zielt vor allem auf diese Schule: Code wird mit Interfaces, Indirektionen und Injektion verbogen, nur damit er sich mit Mocks testen lässt.
4. Werkzeuge und Beispiel sind gealtert. jMock, Swing, XMPP und Hamcrest-Syntax wirken heute fremd. Wer das Buch liest, muss die Ideen auf Mockito, Webanwendungen und moderne Messaging-Systeme übertragen.
5. Anspruchsvoll. Teil III ist lang und detailreich. Wer die Codebeispiele nicht mitverfolgt, verliert leicht den Faden.
6. Wenig zu Domänenmodellierung. Das Buch zeigt, wie Objekte über Rollen zusammenarbeiten, aber wenig darüber, wie man reiche Fachmodelle mit Invarianten baut. Dafür braucht man Evans.
Gesamturteil
Wer TDD nur aus Becks Geld-Beispiel kennt, sieht hier, wie es in einem echten System aussieht. Man muss die London-Schule nicht übernehmen, um von dem Buch zu profitieren: Doppelte Schleife, Walking Skeleton, „nur eigene Typen mocken“ und der gesamte Teil IV gelten unabhängig davon, ob man viel oder wenig mit Mocks arbeitet.
London gegen Chicago, mit beiden Quellen in der Hand
In der Beck-Zusammenfassung standen die beiden Schulen nebeneinander. Mit GOOS lässt sich der Unterschied genauer fassen.
| Beck, TDD by Example | Freeman und Pryce, GOOS | |
|---|---|---|
| Einstieg | einfachster nützlicher Unit-Test | Walking Skeleton und Akzeptanztest |
| Richtung | von innen nach außen | von außen nach innen |
| Design entsteht durch | Beseitigen von Duplikation beim Refactoring | Entdecken von Rollen beim Schreiben der Tests |
| Prüfen | Ergebnisse und Zustand | Nachrichten an Nachbarn, Ergebnisse bei Werten |
| Mocks | selten, eher Fakes und Self Shunt | zentral, für Rollen |
| Beispiel | Geld, Testframework | Auktionsprogramm mit Netzwerk und Oberfläche |
| Risiko | Teile passen am Ende nicht zusammen | Tests hängen eng an der Implementierung |
In der Praxis mischen die meisten erfahrenen Entwickler beides: Werte und reine Logik zustandsbasiert testen, Zusammenarbeit an Systemgrenzen über Rollen, echte Infrastruktur über Integrationstests. Die Autoren von GOOS würden dem zustimmen: Sie mocken keine Werte und keine fremden Typen, und das betrifft einen großen Teil jedes Systems.
Bezüge zur Reihe
| Idee in GOOS | Bezug in der Reihe |
|---|---|
| Doppelte Schleife | Beck: Rot-Grün-Refactor; Ousterhout und Thomas/Hunt: Gesamtbild nicht verlieren |
| Walking Skeleton | Thomas und Hunt: Tracer Bullets; McConnell: T-förmige Integration; Accelerate: Continuous Delivery |
| Werte gegen Objekte | Evans: Value Objects und Entities; Weidig: Records |
| Rollen-Interfaces aus Sicht des Aufrufers | Ousterhout: Schnittstelle als Kosten; Bloch: Interfaces statt Klassen |
| Kontextunabhängigkeit | Feathers: Seams; Bloch: Dependency Injection |
| Nur eigene Typen mocken, Adapter bauen | Clean Code: Grenzen; Evans: Anticorruption Layer; Kleppmann: entfernte Aufrufe |
| Das Ganze einfacher als die Teile | Ousterhout: tiefe Module |
| Bündeln als Refactoring | Beck: One Pile; Fowler: Inline Class |
| Auf die Tests hören | Beck: schlechte Tests als Designsignal; Feathers: Testbarkeit |
| Abfragen erlauben, Befehle erwarten | Clean Code: Command-Query-Separation |
| Test Data Builder | Bloch: Builder |
| Logik von Nebenläufigkeit trennen | Weidig: funktionaler Kern; Bloch: Executors |
Diskussionsfragen
- Deine Schule: Testest du eher zustandsbasiert oder interaktionsbasiert? Hat sich das über die Jahre verändert?
- Doppelte Schleife: Beginnt ihr Features mit einem echten Akzeptanztest von Ende zu Ende? Was hindert euch, wenn nicht?
- Walking Skeleton: Wie lange dauert es in einem neuen Projekt bei euch, bis der erste Commit automatisch in einer produktionsähnlichen Umgebung läuft?
- Fremd-APIs mocken: Wie oft findest du in Tests Mocks von
EntityManager,RestTemplate,KafkaTemplateoder Cloud-SDKs? Was würde ein Adapter ändern? - Zerbrechliche Tests: Welche Regel aus Teil IV würde in euren Testsuiten am meisten helfen?
- Rollen-Interfaces: Sind Interfaces mit nur einer Implementierung für dich Designgewinn oder Ballast?
- Test Data Builder: Nutzt ihr Builder oder Fixtures? Wie oft brechen Tests, wenn sich ein Konstruktor ändert?
- Nächstes Buch: Nach so viel Testen und Design wäre Release It! mit Stabilitätsmustern aus dem Betrieb ein guter Kontrast, oder Team Topologies als Organisationsthema. Was reizt dich mehr?