Designing Machine Learning Systems – Zusammenfassung und Einordnung
Chip Huyen, Designing Machine Learning Systems: An Iterative Process for Production-Ready Applications (2022)
Einleitung
Designing Machine Learning Systems ist Chip Huyens erstes Buch und das Vorgängerwerk zu AI Engineering. Es behandelt nicht Sprachmodelle, sondern klassisches Machine Learning im Betrieb: Systeme, die etwa Betrug erkennen, Empfehlungen geben, Preise vorhersagen oder Kunden einordnen, und die man auf eigenen Daten trainiert. Seine Fragen sind zeitlos: Woher kommen die Daten, wie bleiben sie gut, wie bringt man ein Modell zuverlässig in Produktion, wie merkt man, dass es schlechter wird, und was tut man dann?
Kontext
Das Buch entstand aus Huyens Vorlesung CS 329S: Machine Learning Systems Design an der Stanford University und aus ihrer Arbeit bei NVIDIA, Netflix und Snorkel AI. Es erschien im Mai 2022, ein halbes Jahr vor dem Start von ChatGPT, und ist weiterhin in der ersten Auflage aktuell. Es wurde in über zehn Sprachen übersetzt.
Die Kernthese
Der Algorithmus ist nur ein kleiner Teil eines ML-Systems. Der größere Teil sind Daten, Infrastruktur, Monitoring, Prozesse und Menschen. Und anders als klassische Software verändert sich ein ML-System, auch wenn niemand den Code ändert, weil sich die Daten ändern, auf die es trifft. Deshalb muss man ML-Systeme so entwerfen, dass sie iterativ verbessert, überwacht und neu trainiert werden können.
Aufbau
| Kapitel | Thema |
|---|---|
| 1–2 | Überblick über ML-Systeme; Einführung in den Systementwurf |
| 3 | Grundlagen des Data Engineering |
| 4 | Trainingsdaten |
| 5 | Feature Engineering |
| 6 | Modellentwicklung und Offline-Evaluation |
| 7 | Deployment und Vorhersagedienst |
| 8 | Verteilungsverschiebungen und Monitoring |
| 9 | Kontinuierliches Lernen und Testen in Produktion |
| 10 | Infrastruktur und Werkzeuge für MLOps |
| 11 | Die menschliche Seite des Machine Learning |
Rund 380 Seiten, kaum Code, viele Fallbeispiele und Literaturhinweise. Huyen hat das Buch bewusst werkzeugunabhängig geschrieben, damit es nicht so schnell veraltet.
ML-Systeme im Überblick
Mehr als ein Modell
Huyen beginnt mit einer Abbildung, die viele aus einem bekannten Google-Artikel kennen: Der eigentliche Modellcode ist ein kleiner Kasten inmitten vieler größerer.
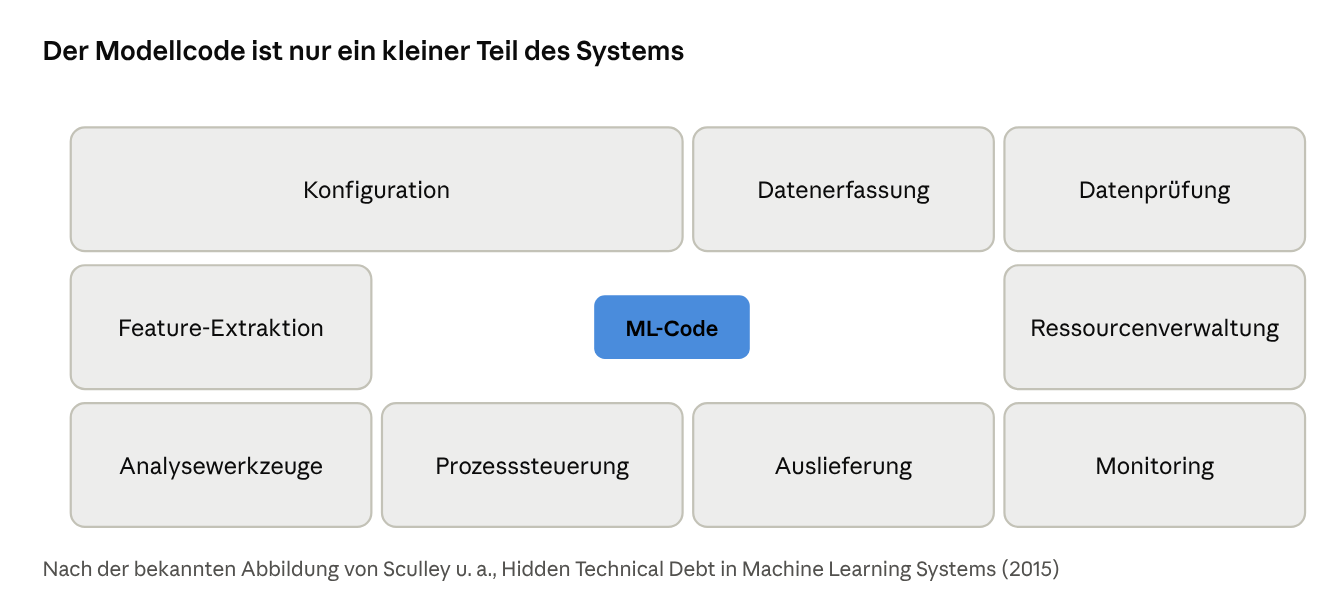
die Bestandteile eines ML-Systems in Produktion, schematisch
Wann Machine Learning passt
ML lohnt sich, wenn man komplexe Muster aus vorhandenen Daten lernen will, um Vorhersagen für neue, ähnliche Fälle zu treffen, die Aufgabe sich häufig wiederholt, ein einzelner Fehler günstig ist und es um große Mengen geht. Wenn sich die Regeln einfach hinschreiben lassen, ist klassischer Code meist besser.
Forschung und Produktion
| Forschung | Produktion | |
|---|---|---|
| Anforderungen | bestes Ergebnis auf einem Vergleichsdatensatz | viele Beteiligte mit verschiedenen Zielen |
| Rechenpriorität | schnelles Training, hoher Durchsatz | schnelle Vorhersagen, niedrige Latenz |
| Daten | statisch, bereinigt | wechselnd, verrauscht, verzerrt |
| Fairness, Erklärbarkeit | oft nebensächlich | wichtig, teils gesetzlich gefordert |
Vier Anforderungen
Huyen übernimmt die drei Anforderungen, die Kleppmann für datenintensive Systeme nennt, und ergänzt eine vierte für ML:
| Anforderung | Bedeutung für ML |
|---|---|
| Zuverlässigkeit | ML-Systeme versagen oft still: Sie liefern weiter Vorhersagen, nur falsche |
| Skalierbarkeit | mehr Daten, mehr Anfragen, mehr Modelle |
| Wartbarkeit | Code, Daten, Modelle und Konfiguration nachvollziehbar und reproduzierbar halten |
| Anpassungsfähigkeit | auf veränderte Daten und Geschäftsanforderungen reagieren, ohne Unterbrechung |
Ein iterativer Prozess
ML-Entwicklung ist kein Wasserfall. Huyen beschreibt einen Kreislauf aus Projektabgrenzung, Data Engineering, Modellentwicklung, Auslieferung, Monitoring und Weiterlernen, und geschäftlicher Auswertung, der immer wieder durchlaufen wird.
Das Problem richtig formulieren
Wie man eine Aufgabe als ML-Problem fasst, bestimmt viel: Klassifikation oder Regression, zwei Klassen oder viele, eine Klasse pro Fall oder mehrere. Ein Beispiel aus dem Buch: Statt eine Klassifikation über alle Apps zu bauen, welche App ein Nutzer als Nächstes öffnet, kann man für jede App eine Wahrscheinlichkeit vorhersagen; dann muss das Modell nicht bei jeder neuen App neu trainiert werden. Huyen rät außerdem, mehrere Ziele getrennt zu modellieren, etwa Relevanz und Qualität, und sie erst bei der Entscheidung zu gewichten.
Einordnung
Die Abbildung ist Brooks‘ Unterscheidung von Programm und Produkt, auf ML übertragen: Das Modell ist das Programm, das System drumherum ist das Produkt, und es kostet ein Vielfaches.
Data Engineering
Das dritte Kapitel ist eine kompakte Einführung in Themen, die Leser von Kleppmann und Hohpe kennen, aus dem Blickwinkel von ML.
Datenquellen
| Quelle | Besonderheit |
|---|---|
| Nutzereingaben | fehlerhaft, unvollständig, manchmal böswillig; immer prüfen |
| Systemerzeugte Daten | Logs, Ereignisse; in großen Mengen, oft schlecht dokumentiert |
| Interne Datenbanken | Bestellungen, Kunden, Verträge; meist die wertvollste Quelle |
| Daten von Dritten | zugekauft; Herkunft und Rechtslage prüfen |
Formate
Huyen unterscheidet zeilenorientierte Formate wie CSV, gut zum Schreiben ganzer Datensätze, von spaltenorientierten wie Parquet, gut zum Lesen einzelner Spalten über viele Zeilen. Für Training und Auswertung, bei denen man oft wenige Spalten aus Millionen Zeilen braucht, sind spaltenorientierte Formate meist überlegen. Außerdem: Textformate wie JSON sind lesbar, aber groß; Binärformate kompakt und schnell.
Verarbeitung
| Art | Inhalt |
|---|---|
| Transaktional | viele kleine Lese- und Schreibzugriffe, wie in operativen Datenbanken |
| Analytisch | wenige große Abfragen über viele Zeilen, wie im Data Warehouse |
| ETL und ELT | Daten erst umformen, dann laden, oder umgekehrt erst laden und bei Bedarf umformen |
Wie Daten fließen
Daten können zwischen Prozessen über eine gemeinsame Datenbank, über Dienstaufrufe wie REST oder RPC oder über Echtzeit-Transport wie Kafka fließen. Für ML ist der Echtzeit-Transport wichtig, weil viele Features aus aktuellen Ereignissen berechnet werden, etwa die Zahl der Bestellungen eines Kunden in der letzten Stunde.
Batch und Stream
| Batch | Stream | |
|---|---|---|
| Daten | ruhend, in großen Mengen | in Bewegung, Ereignis für Ereignis |
| Typische Features | langsam veränderlich, etwa der Durchschnitt eines Kunden über ein Jahr | schnell veränderlich, etwa Aktivität der letzten Minuten |
| Werkzeuge | Spark, SQL im Data Warehouse | Flink, Kafka Streams |
Einordnung
Das Kapitel ist eine verdichtete Fassung von Kleppmanns Kapiteln über Speicher, Kodierung, Batch- und Stream-Verarbeitung und von Hohpes und Woolfs Integrationsstilen. Für Java-Entwickler ist es vertrautes Gelände; Kafka Streams und Flink sind ohnehin Java-Werkzeuge.
Trainingsdaten
Huyen betont: Trainingsdaten sind nicht einfach „die Daten“, sondern eine bewusst zusammengestellte Auswahl, und ihre Qualität bestimmt das Modell mehr als jeder Algorithmus.
Stichproben
| Verfahren | Idee | Einsatz |
|---|---|---|
| Einfache Zufallsstichprobe | jeder Datensatz gleich wahrscheinlich | Standard, aber seltene Gruppen fehlen leicht |
| Geschichtete Stichprobe | aus jeder Gruppe gezielt ziehen | seltene Klassen sicher abdecken |
| Gewichtete Stichprobe | Wahrscheinlichkeit nach Bedeutung | neuere Daten stärker gewichten |
| Reservoir Sampling | aus einem Datenstrom unbekannter Länge eine gleichverteilte Stichprobe fester Größe ziehen | Streams, Logs |
| Importance Sampling | aus einer leicht zugänglichen Verteilung ziehen und umgewichten | wenn die Zielverteilung schwer zugänglich ist |
// Reservoir Sampling: k Elemente gleichverteilt aus einem Strom unbekannter Länge
static <T> List<T> reservoirSample(Iterator<T> stream, int k, RandomGenerator rnd) {
    var reservoir = new ArrayList<T>(k);
    long n = 0;
    while (stream.hasNext()) {
        T item = stream.next();
        n++;
        if (reservoir.size() < k) {
            reservoir.add(item);
        } else {
            long j = rnd.nextLong(n);              // 0 .. n-1
            if (j < k) reservoir.set((int) j, item); // mit Wahrscheinlichkeit k/n ersetzen
        }
    }
    return reservoir;
}
Beschriftung
- Von Hand: teuer, langsam, oft mit Datenschutzfragen, und Experten sind sich nicht immer einig. Huyen rät, Richtlinien für Annotatoren zu schreiben und die Herkunft jeder Beschriftung festzuhalten.
- Natürliche Beschriftungen: Manche Aufgaben liefern die richtige Antwort von selbst, etwa ob ein Nutzer auf eine Empfehlung klickt oder ob eine geschätzte Ankunftszeit stimmte. Entscheidend ist die Länge der Rückkopplungsschleife: Bei Klicks Sekunden, bei Betrug manchmal Monate.
- Ohne Beschriftungen: schwache Überwachung mit Heuristiken als Beschriftungsfunktionen, halbüberwachtes Lernen, Transfer von vortrainierten Modellen, aktives Lernen, bei dem das Modell selbst auswählt, welche Fälle beschriftet werden sollen.
Unausgewogene Klassen
In vielen echten Aufgaben ist die interessante Klasse selten: Betrug, Ausfälle, seltene Krankheiten. Ein Modell, das immer „kein Betrug“ sagt, ist dann zu 99,9 Prozent genau und völlig nutzlos. Huyens Rat:
- Passende Kennzahlen: Präzision, Trefferquote und ihre Kombination statt Genauigkeit.
- Daten ausgleichen: seltene Klasse vermehren oder häufige ausdünnen, mit Vorsicht.
- Fehler gewichten: einen übersehenen Betrug teurer bewerten als einen Fehlalarm.
Daten erweitern
Vorhandene Beispiele lassen sich variieren: Bilder drehen, Wörter durch Synonyme ersetzen, gezielt Störungen hinzufügen. Das macht Modelle robuster und kann fehlende Daten teilweise ersetzen.
Feature Engineering
Features sind die Eingaben, aus denen ein Modell lernt: Alter des Kunden, Zahl der Bestellungen im letzten Monat, Uhrzeit einer Transaktion. Auch im Zeitalter neuronaler Netze, die manche Features selbst lernen, bleibt gutes Feature Engineering oft der größte Hebel.
Typische Operationen
| Operation | Zweck |
|---|---|
| Fehlende Werte behandeln | entfernen oder auffüllen; dabei unterscheiden, ob Werte zufällig fehlen oder aus einem Grund |
| Skalieren | Werte auf vergleichbare Größenordnungen bringen |
| Diskretisieren | kontinuierliche Werte in Bereiche einteilen, etwa Altersgruppen |
| Kategorien kodieren | etwa mit dem Hashing-Trick, der auch mit neuen, unbekannten Kategorien umgehen kann |
| Features kreuzen | Kombinationen bilden, etwa Familienstand und Kinderzahl |
Datenlecks
Ein besonders wertvoller Abschnitt behandelt Datenlecks: Informationen über das Ziel gelangen beim Training in die Features, sind aber bei echten Vorhersagen nicht verfügbar. Das Modell wirkt im Test hervorragend und versagt in Produktion. Huyen nennt typische Ursachen:
| Ursache | Beispiel |
|---|---|
| Zufällige Aufteilung zeitabhängiger Daten | Trainings- und Testdaten mischen Zeitpunkte; das Modell lernt aus der „Zukunft“. Bei Zeitreihen nach Zeit aufteilen. |
| Statistiken vor der Aufteilung berechnen | Mittelwerte für Skalierung oder Auffüllen über alle Daten berechnet, einschließlich Testdaten |
| Duplikate | dieselben Datensätze in Training und Test |
| Gruppen | Aufnahmen desselben Patienten in Training und Test |
| Entstehung der Daten | ein Feature verrät das Ziel indirekt, etwa die Art des Scanners, der nur bei Verdachtsfällen eingesetzt wird |
Ihr Rat: Leistungen, die zu gut aussehen, misstrauisch prüfen; Features einzeln auf ihren Einfluss untersuchen; Testdaten erst ganz am Ende anfassen.
Gute Features
Ein gutes Feature ist wichtig für das Modell und verallgemeinert: Es hilft auch bei neuen Daten. Huyen warnt vor zu vielen Features: Jedes zusätzliche erhöht Pflegeaufwand, Speicher, Latenz und die Gefahr von Lecks.
Einordnung
Datenlecks sind das ML-Gegenstück zu Tests, die gegen die Implementierung statt gegen das Verhalten prüfen, und damit zu Khorikovs falsch-positiven Tests: Die Prüfung meldet Erfolg, wo keiner ist. Die Aufteilung nach Zeit erinnert an Kleppmanns Unterscheidung von Ereigniszeit und Verarbeitungszeit.
Modellentwicklung und Offline-Evaluation
Ratschläge zur Modellwahl
- Nicht dem neuesten Stand der Forschung hinterherlaufen. Das beste Modell auf einem Vergleichsdatensatz ist nicht unbedingt das beste für die eigene Aufgabe.
- Mit dem Einfachsten anfangen. Ein einfaches Modell ist schneller in Produktion, leichter zu verstehen und dient als Vergleichsbasis.
- Eigene Voreingenommenheit vermeiden: Wer ein Lieblingsmodell länger optimiert als die Alternativen, vergleicht unfair.
- Abwägungen kennen: Genauigkeit gegen Latenz, Erklärbarkeit gegen Leistung, Fehlalarme gegen Übersehenes.
Vier Phasen
Huyen beschreibt einen bewährten Weg:
| Phase | Vorgehen |
|---|---|
| 1. Vor ML | eine einfache Regel oder Heuristik; oft erstaunlich gut |
| 2. Einfachstes ML | ein einfaches Modell, um die ganze Pipeline von Daten bis Auslieferung aufzubauen |
| 3. Einfaches ML verbessern | Features, Daten, Hyperparameter, Ensembles |
| 4. Komplexe Modelle | erst wenn die Grenzen einfacher Modelle erreicht sind |
Das ist Thomas‘ und Hunts Tracer Bullet: zuerst ein dünner, vollständiger Durchstich, dann verbessern.
Experimente nachvollziehbar machen
Modellentwicklung besteht aus vielen Experimenten. Huyen rät, für jedes Code, Daten, Konfiguration, Kennzahlen und Ergebnisse zu versionieren, damit man später weiß, was funktioniert hat und warum. Werkzeuge dafür sind etwa MLflow oder Weights & Biases. Das ist Continuous Deliverys „alles in die Versionskontrolle“, erweitert um Daten und Modelle.
Offline bewerten
| Methode | Frage |
|---|---|
| Vergleichsbasis | Wie schneidet das Modell gegenüber Zufall, einer einfachen Regel, Menschen und dem bisherigen System ab? |
| Störungstests | Bleibt die Vorhersage stabil, wenn man Eingaben leicht verrauscht? |
| Invarianztests | Ändert sich die Vorhersage, wenn sich etwas Unerhebliches ändert, etwa Name oder Geschlecht bei einer Kreditentscheidung? Das sollte sie nicht. |
| Richtungstests | Ändert sich die Vorhersage in die erwartete Richtung, etwa höherer Preis bei größerer Wohnfläche? |
| Kalibrierung | Wenn das Modell 80 Prozent sagt, stimmt es dann in etwa 80 Prozent der Fälle? |
| Auswertung nach Teilgruppen | Ist das Modell für alle Gruppen gut, oder nur im Durchschnitt? |
Die Auswertung nach Teilgruppen ist besonders wichtig: Ein Modell kann insgesamt besser werden und für eine kleine, wichtige Gruppe schlechter.
Einordnung
Invarianz- und Richtungstests sind eigenschaftsbasierte Tests, wie Thomas und Hunt sie beschreiben: Man prüft nicht einzelne Ergebnisse, sondern Eigenschaften, die für alle Eingaben gelten sollen. In Java lassen sie sich etwa mit jqwik formulieren.
Deployment und Vorhersagedienst
Vier Mythen
Huyen räumt mit verbreiteten Annahmen auf:
| Mythos | Wirklichkeit |
|---|---|
| „Man liefert nur ein oder zwei Modelle aus.“ | Größere Unternehmen betreiben Hunderte oder Tausende Modelle, oft eines pro Land, Produkt oder Kundengruppe. |
| „Die Leistung bleibt gleich, wenn man nichts ändert.“ | Modelle werden schlechter, weil sich die Welt ändert. |
| „Modelle muss man selten aktualisieren.“ | Je häufiger man aktualisiert, desto besser bleibt meist die Leistung. |
| „Um Skalierung müssen sich die meisten nicht kümmern.“ | Viele Entwickler arbeiten in Unternehmen, in denen Skalierung zählt. |
Batch oder online vorhersagen
| Batch-Vorhersage | Online-Vorhersage | |
|---|---|---|
| Wann | im Voraus, regelmäßig, etwa nachts | bei Bedarf, pro Anfrage |
| Vorteil | günstig, keine Latenzprobleme | aktuell, auch für neue Fälle |
| Nachteil | veraltet; nur für bekannte Fälle | Latenz und Kapazität müssen stimmen |
| Beispiel | Empfehlungen für alle Kunden über Nacht berechnen | Betrugsprüfung beim Bezahlen |
Huyen beobachtet einen Trend zur Online-Vorhersage mit aktuellen Features aus Datenströmen.
Training und Betrieb gleich rechnen
Ein häufiger, schwer zu findender Fehler: Features werden beim Training anders berechnet als im Betrieb, etwa im Training mit SQL im Data Warehouse, im Betrieb mit Java im Dienst. Kleine Unterschiede, etwa bei Zeitzonen oder Rundung, führen dazu, dass das Modell in Produktion andere Eingaben sieht als im Training. Huyens Rat: dieselbe Logik für beides, oder ein Feature Store, der Features einheitlich berechnet und bereitstellt.
// Eine Feature-Berechnung, die sowohl im Batch als auch im Stream verwendet wird
public final class OrderFeatures {
    public static FeatureVector compute(Customer customer, List<Order> recentOrders, Instant now) {
        var lastHour = recentOrders.stream()
            .filter(o -> o.placedAt().isAfter(now.minus(Duration.ofHours(1))))
            .count();
        var avgAmount = recentOrders.stream()
            .mapToDouble(o -> o.total().doubleValue()).average().orElse(0);
        return new FeatureVector(customer.ageInDays(now), lastHour, avgAmount);
    }
}
// Batch-Job (Training) und Kafka-Streams-Topologie (Betrieb) rufen dieselbe Methode auf.
Modelle verkleinern
Für niedrige Latenz oder Geräte mit wenig Rechenleistung beschreibt Huyen Techniken, die in AI Engineering wiederkehren: Quantisierung, Destillation, Pruning, also das Entfernen unwichtiger Gewichte, und Faktorisierung.
Cloud oder Gerät
Modelle können zentral in der Cloud oder auf Geräten wie Smartphones laufen. Auf dem Gerät spart man Netzwerklatenz und Kosten und schützt Daten, ist aber durch Rechenleistung und Speicher begrenzt.
Einordnung
Der Unterschied zwischen Training und Betrieb ist ein Fall von Konnaszenz des Algorithmus, wie Richards und Ford sie beschreiben: Zwei Stellen müssen denselben Algorithmus verwenden, und wenn sie auseinanderlaufen, bricht etwas, ohne dass ein Test es merkt. Die Lösung ist dieselbe wie überall: die Konnaszenz an einer Stelle bündeln.
Verteilungsverschiebungen und Monitoring
Das achte Kapitel ist für viele Leser das wichtigste, weil es den Unterschied zwischen ML-Systemen und klassischer Software am deutlichsten zeigt.
Warum ML-Systeme versagen
Huyen betont zunächst, dass viele Ausfälle gar nicht ML-spezifisch sind: Abhängigkeiten, Auslieferungsfehler, Hardware, Netzwerk. Dafür gelten Nygards und die SRE-Ratschläge. Dazu kommen Fehler, die es nur bei ML gibt:
| Fehler | Beschreibung |
|---|---|
| Produktion sieht anders aus als das Training | die Daten im Betrieb unterscheiden sich von denen, mit denen trainiert wurde |
| Randfälle | seltene Eingaben, bei denen das Modell katastrophal falsch liegt |
| Entartete Rückkopplung | die Vorhersagen beeinflussen die künftigen Trainingsdaten; etwa ein Empfehlungssystem, das beliebte Artikel empfiehlt, die dadurch noch beliebter werden |
Drei Arten der Verschiebung
| Art | Was sich ändert | Beispiel |
|---|---|---|
| Kovariatenverschiebung | die Verteilung der Eingaben | plötzlich viel mehr junge Kunden durch eine Werbekampagne |
| Label-Verschiebung | die Verteilung der Ergebnisse | mehr Schadensfälle nach einem Unwetter |
| Konzeptdrift | der Zusammenhang zwischen Eingaben und Ergebnis | dieselbe Wohnung ist nach einer Krise anders viel wert |
Außerdem gibt es banale Änderungen: ein Feld, das plötzlich in einer anderen Einheit geliefert wird, oder ein Upstream-System, das einen Wert anders kodiert.
Erkennen
Verschiebungen erkennt man, indem man Statistiken der aktuellen Daten mit denen der Trainingsdaten vergleicht: Mittelwerte, Verteilungen, Anteile. Dafür gibt es statistische Tests und Kennzahlen. Wichtig ist das Zeitfenster: Zu kurz, und man sieht Rauschen; zu lang, und man bemerkt Änderungen spät.
// Population Stability Index: wie stark hat sich eine Verteilung verschoben?
// expected, actual: Anteile pro Bereich (gleiche Bereiche, Summe jeweils 1)
static double psi(double[] expected, double[] actual) {
    double eps = 1e-6, sum = 0;
    for (int i = 0; i < expected.length; i++) {
        double e = Math.max(expected[i], eps), a = Math.max(actual[i], eps);
        sum += (a - e) * Math.log(a / e);
    }
    return sum;   // verbreitete Faustregel: unter 0,1 stabil, über 0,25 deutliche Verschiebung
}
Die Faustregel im Kommentar stammt aus der Praxis, etwa im Kredit-Scoring, nicht aus dem Buch; sie ist ein Anfang, kein Gesetz.
Was man überwachen sollte
| Ebene | Beispiele |
|---|---|
| Betrieb | Latenz, Durchsatz, Fehler, Auslastung; wie bei jedem Dienst |
| Genauigkeit | sofern Rückmeldung verfügbar ist: Klickrate, korrigierte Vorhersagen, bestätigte Betrugsfälle |
| Vorhersagen | Verteilung der Ausgaben; plötzlich nur noch eine Klasse ist ein Alarmzeichen |
| Features | Schema, Wertebereiche, fehlende Werte, Verteilungen |
| Rohdaten | Format und Herkunft der Eingaben |
Huyen unterscheidet Monitoring, das bekannte Kennzahlen verfolgt, von Beobachtbarkeit, die es erlaubt, auch unerwartete Probleme aus den Daten heraus zu verstehen; ganz wie im SRE-Buch und bei Newman.
Einordnung
Das Kapitel ist die Antwort auf eine Frage, die in klassischer Software kaum vorkommt: Was, wenn das System schlechter wird, ohne dass sich der Code ändert? Die Werkzeuge kennt man aus dem SRE-Buch, nur die Kennzahlen sind neue: Verteilungen statt nur Fehlerraten.
Kontinuierliches Lernen
Wenn sich die Welt ändert, muss das Modell mitlernen. Das neunte Kapitel beschreibt, wie man das organisiert.
Neu trainieren oder weitertrainieren
| Ansatz | Vorgehen | Abwägung |
|---|---|---|
| Zustandsloses Neutraining | jedes Mal von vorn auf allen relevanten Daten trainieren | einfach, aber teuer und langsam |
| Zustandsbehaftetes Training | das vorhandene Modell nur mit neuen Daten weitertrainieren | deutlich günstiger und schneller; braucht sorgfältige Überwachung |
Vier Stufen
Huyen beschreibt, wie Organisationen typischerweise reifen:
| Stufe | Beschreibung |
|---|---|
| 1. Manuelles Neutraining | ein Data Scientist trainiert gelegentlich von Hand neu, wenn jemand merkt, dass das Modell schlechter wird |
| 2. Automatisches Neutraining | ein Zeitplan, etwa wöchentlich, trainiert und liefert automatisch aus |
| 3. Automatisches Weitertrainieren | wie Stufe 2, aber zustandsbehaftet |
| 4. Kontinuierliches Lernen | Training wird durch Ereignisse ausgelöst: neue Daten, nachlassende Leistung, erkannte Verschiebung |
Wie oft aktualisieren?
Huyen schlägt ein einfaches Experiment vor, um den Wert frischer Daten zu messen: Modelle auf unterschiedlich alten Datenfenstern trainieren und auf aktuellen Daten vergleichen. Wenn ein Modell mit Daten von gestern deutlich besser ist als eines mit Daten vom letzten Monat, lohnt sich häufiges Training.
Herausforderungen
- Frische Daten: Beschriftungen kommen oft spät, besonders bei langen Rückkopplungsschleifen.
- Evaluation: Jede Aktualisierung ist eine Änderung mit Risiko und muss geprüft werden, bevor sie live geht.
- Algorithmen: Manche Modellarten lassen sich nur schwer schrittweise weitertrainieren.
Testen in Produktion
Offline-Evaluation reicht nicht, weil die echten Daten anders sind. Huyen beschreibt Verfahren, um neue Modelle unter realen Bedingungen zu prüfen:
| Verfahren | Idee |
|---|---|
| Schattenbetrieb | das neue Modell rechnet parallel mit, seine Vorhersagen werden protokolliert, aber nicht verwendet |
| A/B-Test | ein Teil der Nutzer bekommt das neue Modell, Ergebnisse werden statistisch verglichen |
| Canary Release | das neue Modell erhält zunächst wenig Verkehr, der schrittweise erhöht wird |
| Interleaving | bei Empfehlungen werden Ergebnisse beider Modelle gemischt gezeigt; man sieht, welche häufiger gewählt werden |
| Banditen | der Verkehr wird laufend dem Modell zugeteilt, das sich besser bewährt; schneller als ein A/B-Test, aber komplexer |
Einordnung
Das ist Continuous Delivery für Modelle: Pipeline, automatisierte Prüfung, Canary, Rücknahme. Der Schattenbetrieb entspricht Newmans Parallel Run, die Stufen der Automatisierung erinnern an die Reifegrade aus Continuous Delivery. Und die Frage „wie oft“ ist eine Messung im Sinne von Accelerate: nicht nach Gefühl, sondern nach dem gemessenen Nutzen.
Infrastruktur und Werkzeuge
Huyen beschreibt die Infrastruktur für ML in vier Schichten:
| Schicht | Inhalt |
|---|---|
| Speicher und Rechenleistung | wo Daten liegen und wo gerechnet wird; Cloud oder eigene Rechenzentren |
| Ressourcenverwaltung | Zeitpläne und Abhängigkeiten von Aufgaben; Werkzeuge wie Airflow, Argo, Kubeflow oder Metaflow |
| ML-Plattform | gemeinsame Bausteine für viele Modelle: Auslieferung, Model Store für Modelle mit Herkunft, Feature Store für einheitlich berechnete Features |
| Entwicklungsumgebung | einheitliche Umgebungen für alle, idealerweise in Containern, damit Experimente reproduzierbar sind |
Selbst bauen oder kaufen
Für jede Schicht stellt sich die Frage, ob man selbst baut oder einkauft. Huyen nennt Kriterien: wie weit die eigene Organisation ist, ob die Komponente ein Wettbewerbsvorteil ist, und wie reif die verfügbaren Werkzeuge sind. Ihr Hinweis: Viele Unternehmen bauen am Anfang selbst und stellen später fest, dass sie eine Plattform pflegen, die nicht ihr Kerngeschäft ist.
Die menschliche Seite
Das letzte Kapitel behandelt Themen, die in technischen ML-Büchern oft fehlen.
Nutzererfahrung
- Konsistenz: Nutzer erwarten, dass dieselbe Eingabe dasselbe Ergebnis liefert. Wahrscheinlichkeitsbasierte Modelle tun das nicht immer.
- Mehrere Vorschläge statt eines: Wenn ein Modell unsicher ist, kann es mehrere Möglichkeiten anbieten und den Nutzer wählen lassen.
- Würdig scheitern: Wenn eine Vorhersage zu lange dauert oder unsicher ist, auf eine einfachere Lösung zurückfallen. Das ist Nygards Fallback.
Teamstruktur
Huyen diskutiert, ob Data Scientists nur Modelle entwickeln und andere Teams den Betrieb übernehmen, oder ob sie den ganzen Weg bis zur Produktion verantworten. Ihre Beobachtung: Wenn die Übergabe zu groß ist, entstehen Missverständnisse und lange Wartezeiten; wenn Data Scientists alles selbst machen müssen, sind sie überfordert. Die Lösung ist eine gute Plattform, die Data Scientists den Betrieb erleichtert, ganz im Sinne von Team Topologies‘ Plattform-Team.
Verantwortungsvolle KI
Anhand bekannter Fälle, etwa eines britischen Bewertungsalgorithmus für Schulnoten während der Pandemie, der systematisch bestimmte Gruppen benachteiligte, zeigt Huyen, wie Modelle Schaden anrichten können. Ihr Rahmen für verantwortungsvolle Systeme umfasst: Quellen von Verzerrung kennen, Daten kritisch prüfen, Abwägungen zwischen Genauigkeit und Fairness bewusst treffen, früh handeln, Modelle dokumentieren, etwa mit Model Cards, und Verantwortlichkeiten klären.
Einordnung
Der Feature Store ist eine Plattformkomponente im Sinne von Team Topologies und eine Lösung für das Problem der doppelten Berechnung aus dem Deployment-Kapitel. Das Thema verantwortungsvolle KI führt direkt zu Christians The Alignment Problem, das später in dieser Reihe folgt.
Kritik und Einordnung
Stärken
- Systemdenken: Das Buch betrachtet ML als System mit Daten, Betrieb, Menschen und Organisation, nicht als Algorithmus.
- Werkzeugunabhängig: Es altert langsam, weil es Prinzipien statt Werkzeuge beschreibt.
- Praxisnah: Datenlecks, Unterschiede zwischen Training und Betrieb, Verschiebungen, Rückkopplungsschleifen; Fehler, die man sonst erst teuer lernt.
- Brücke zur Softwaretechnik: Viele Konzepte schließen an Kleppmann, Continuous Delivery und SRE an; für Softwareentwickler gut zugänglich.
- Verantwortung und Menschen: ein ganzes Kapitel zu Nutzererfahrung, Teams und Fairness.
Kritikpunkte
1. Vor den Sprachmodellen geschrieben. Das Buch erschien kurz vor ChatGPT. Foundation Models, Prompting und RAG kommen nicht vor; das behandelt AI Engineering.
2. Breite statt Tiefe. Jedes Kapitel könnte ein eigenes Buch sein, und für einige gibt es diese Bücher. Wer etwa Feature Stores oder Monitoring im Detail aufbauen will, braucht weitere Quellen.
3. Wenig Code. Wie AI Engineering erklärt es Konzepte, keine Umsetzungen.
4. Große Unternehmen als Maßstab. Hunderte Modelle, eigene ML-Plattform, Echtzeit-Features: Für ein mittelständisches Unternehmen mit wenigen Modellen ist manches überdimensioniert.
Zwei Bücher von Huyen
| Designing Machine Learning Systems (2022) | AI Engineering (2025) | |
|---|---|---|
| Modelle | selbst trainiert, auf eigenen Daten | vorhandene Foundation Models, angepasst |
| Hauptproblem | Daten: Qualität, Lecks, Verschiebungen | Evaluation offener Ausgaben |
| Typische Aufgaben | Betrug, Empfehlungen, Prognosen, Klassifikation | Assistenten, Zusammenfassung, Suche, Agenten |
| Gemeinsam | iterativer Prozess, Monitoring, Testen in Produktion, Architektur um das Modell herum |
Huyen selbst beschreibt AI Engineering als Ergänzung, nicht als Ersatz. Viele Themen, Daten, Monitoring, Verschiebungen, Rückkopplung, gelten für KI-Anwendungen mit Sprachmodellen genauso; nur heißen sie dort manchmal anders.
Gesamturteil
Für Softwarearchitekten, die mit ML-Teams zusammenarbeiten oder ML-Systeme in ihre Landschaft integrieren, ist das Buch eine der besten Einführungen. Wer nur mit Sprachmodellen über APIs arbeitet, liest zuerst AI Engineering und nimmt dieses Buch für die Kapitel über Daten, Monitoring und kontinuierliches Lernen dazu.
Bezüge zur Reihe
Kein KI-Buch der Reihe ist so eng mit den klassischen Büchern verbunden wie dieses.
| Thema bei Huyen | Bezug in der Reihe |
|---|---|
| Modellcode als kleiner Teil des Systems | Brooks: Programm, Produkt, System |
| Zuverlässigkeit, Skalierbarkeit, Wartbarkeit | Kleppmann: dieselben drei Anforderungen |
| Datenformate, Batch und Stream | Kleppmann; Hohpe und Woolf: Integrationsstile |
| Reservoir Sampling | Sedgewick: Algorithmen auf Datenströmen |
| Datenlecks | Khorikov: falsch-positive Tests; Kleppmann: Ereigniszeit |
| Training und Betrieb rechnen unterschiedlich | Richards und Ford: Konnaszenz des Algorithmus |
| Einfach anfangen, vier Phasen | Thomas und Hunt: Tracer Bullets; Newman: grob anfangen |
| Experimente versionieren | Humble und Farley: alles in die Versionskontrolle |
| Invarianz- und Richtungstests | Thomas und Hunt: eigenschaftsbasierte Tests |
| Batch- und Online-Vorhersage | Kleppmann: abgeleitete Daten; Huyen AI Engineering: Batch-Schnittstellen |
| Verteilungsverschiebungen erkennen | SRE: Monitoring, SLOs; Ford u.a.: kontinuierliche Fitness Functions |
| Entartete Rückkopplungsschleifen | Hohpe: jedes System ist perfekt für seine Ergebnisse |
| Schattenbetrieb, Canary, A/B | Newman: Parallel Run; Humble und Farley: Canary Release |
| Stufen der Automatisierung | Continuous Delivery: Reifegradmodell |
| ML-Plattform, Feature Store | Team Topologies: Plattform-Team |
| Würdig scheitern | Nygard: Fallback, Stabilitätsmuster |
Diskussionsfragen
- ML im eigenen Umfeld: Gibt es bei euch klassische ML-Modelle in Produktion, etwa für Betrug, Prognosen oder Empfehlungen? Wer betreibt sie?
- Stilles Versagen: Woran würdet ihr merken, dass ein Modell schlechter geworden ist, wenn niemand sich beschwert?
- Training und Betrieb: Werden Features bei euch im Training und im Betrieb mit demselben Code berechnet?
- Datenlecks: Hast du schon ein Modell gesehen, das im Test zu gut war? Was war die Ursache?
- Wie oft: Wie häufig werden eure Modelle neu trainiert, und auf welcher Grundlage wurde das entschieden?
- Plattform: Würde ein gemeinsamer Feature Store oder eine ML-Plattform bei euch Sinn ergeben, oder wäre das zu viel?
- Fairness: Gibt es Entscheidungen in euren Systemen, bei denen ein Modell bestimmte Gruppen benachteiligen könnte?
- Weiter: Als Nächstes Gérons Hands-On Machine Learning, das klassisches ML und Deep Learning praktisch einführt.