Deep Learning (Goodfellow, Bengio, Courville) – Zusammenfassung und Einordnung
Ian Goodfellow, Yoshua Bengio, Aaron Courville, Deep Learning (2016)
Einleitung
Deep Learning von Goodfellow, Bengio und Courville war bei seinem Erscheinen 2016 das Standardwerk und wurde jahrelang an Universitäten weltweit verwendet. Es fasst den Stand des Wissens kurz vor der Transformer-Ära zusammen, und genau das macht es heute interessant: als Grundlagenwerk, dessen Fundament weitgehend trägt, und als Zeitdokument, an dem man sieht, wie schnell sich das Feld verändert hat.
Die Autoren
| Autor | Bekannt für |
|---|---|
| Ian Goodfellow | Erfinder der Generative Adversarial Networks, später bei Google Brain, OpenAI, Apple und Google DeepMind |
| Yoshua Bengio | einer der Pioniere des Deep Learning, 2018 mit Geoffrey Hinton und Yann LeCun mit dem Turing Award ausgezeichnet; gründete das Forschungsinstitut Mila in Montreal; widmet sich seit einigen Jahren vor allem der Sicherheit von KI |
| Aaron Courville | Professor an der Université de Montréal und Mila |
Ausgabe
Das Buch erschien Ende 2016 bei MIT Press und wurde nie neu aufgelegt. Der vollständige Text ist kostenlos auf deeplearningbook.org lesbar. Mit rund 800 Seiten ist es das umfangreichste Buch der KI-Reihe.
Die Kernthese
Deep Learning ist ein Ansatz, bei dem Computer die Welt als Hierarchie von Konzepten verstehen lernen: Einfache Konzepte werden zu immer abstrakteren zusammengesetzt, über viele Schichten. Die Autoren sehen darin einen Weg, Wissen nicht von Hand zu programmieren, sondern aus Daten zu lernen, und gute Repräsentationen als Schlüssel dazu.
Aufbau
| Teil | Kapitel | Inhalt |
|---|---|---|
| I. Angewandte Mathematik und ML-Grundlagen | 2–5 | lineare Algebra, Wahrscheinlichkeit und Informationstheorie, numerische Berechnung, Grundlagen des Machine Learning |
| II. Tiefe Netze: moderne Praxis | 6–12 | Feedforward-Netze, Regularisierung, Optimierung, Faltungsnetze, rekurrente Netze, praktische Methodik, Anwendungen |
| III. Forschung | 13–20 | lineare Faktormodelle, Autoencoder, Repräsentationslernen, strukturierte probabilistische Modelle, Monte-Carlo-Methoden, Partitionsfunktion, näherungsweise Inferenz, tiefe generative Modelle |
Der erste Teil ist ein kompakter Mathematikkurs, der zweite der praktische Kern, der dritte ein Blick auf die damalige Forschungsfront.
Mathematische Grundlagen
Der erste Teil ist für viele Leser der Grund, das Buch heute noch aufzuschlagen. Er bündelt die Mathematik, die man für Deep Learning braucht, kompakt und mit Blick auf die Anwendung.
| Kapitel | Inhalt | Wofür man es braucht |
|---|---|---|
| Lineare Algebra | Vektoren, Matrizen, Tensoren, Normen, Eigenwerte, Singulärwertzerlegung, Hauptkomponentenanalyse | jede Schicht ist Matrizenrechnung; Embeddings sind Vektoren |
| Wahrscheinlichkeit und Informationstheorie | Verteilungen, bedingte Wahrscheinlichkeit, Satz von Bayes, Entropie, Kreuzentropie, Kullback-Leibler-Divergenz | Verlustfunktionen, Sampling, generative Modelle |
| Numerische Berechnung | Über- und Unterlauf, Konditionierung, Gradientenverfahren, Optimierung mit Nebenbedingungen | stabiles Rechnen, etwa beim Softmax |
Ein Beispiel aus dem Numerik-Kapitel, das jeder Entwickler kennen sollte: Softmax direkt zu berechnen führt bei großen Werten zum Überlauf. Die Lösung ist, vor dem Exponentieren den größten Wert abzuziehen; genau das tut die softmax-Methode im Java-Beispiel der Raschka-Zusammenfassung.
Grundlagen des Machine Learning
Das fünfte Kapitel ist eine dichte Einführung in Machine Learning insgesamt:
- Kapazität, Über- und Unteranpassung, wie bei Géron, aber formaler.
- Schätzer, Verzerrung und Varianz als statistische Begriffe.
- Maximale Likelihood als allgemeines Prinzip für Verlustfunktionen, das Prince später ausführlich entfaltet.
- Bayessche Statistik als Alternative, die Unsicherheit über Parameter ausdrückt.
- Stochastischer Gradientenabstieg als das Verfahren, das Lernen auf großen Datenmengen erst möglich macht.
Warum Deep Learning nötig ist
Am Ende des Kapitels begründen die Autoren, warum klassische Verfahren an Grenzen stoßen:
| Herausforderung | Erklärung |
|---|---|
| Fluch der Dimensionalität | in vielen Dimensionen gibt es exponentiell viele mögliche Konfigurationen; man kann nicht für jede Beispiele sammeln |
| Lokale Glattheit reicht nicht | klassische Verfahren nehmen an, dass ähnliche Eingaben ähnliche Ausgaben haben; das genügt für komplexe Aufgaben nicht |
| Mannigfaltigkeitshypothese | echte Daten wie Bilder oder Sprache liegen auf niedrigdimensionalen Strukturen im hochdimensionalen Raum; tiefe Netze können diese Strukturen lernen |
Einordnung
Die Mannigfaltigkeitshypothese ist der theoretische Hintergrund dafür, dass Embeddings funktionieren: Sie bilden diese niedrigdimensionalen Strukturen ab. Für Leser mit Informatikstudium ist der erste Teil eine gute Auffrischung; wer nur die Anwendung verstehen will, kann ihn überspringen und bei Bedarf nachschlagen.
Tiefe Feedforward-Netze
Das XOR-Beispiel
Das sechste Kapitel beginnt mit einem berühmten Beispiel. Die XOR-Funktion, „genau eine der beiden Eingaben ist 1“, lässt sich mit keinem linearen Modell darstellen, weil sich die vier Punkte nicht durch eine Gerade trennen lassen. Ein Netz mit einer verborgenen Schicht aus zwei ReLU-Einheiten löst das Problem. Die Autoren geben die Gewichte explizit an:
// XOR mit einem winzigen Netz, Gewichte wie im Buch
// h = ReLU(W·x + c),  y = w·h + b
static double xor(double x1, double x2) {
    double h1 = Math.max(0, 1 * x1 + 1 * x2 + 0);    // W-Spalte 1, c1 = 0
    double h2 = Math.max(0, 1 * x1 + 1 * x2 - 1);    // W-Spalte 2, c2 = -1
    return 1 * h1 - 2 * h2 + 0;                        // w = (1, -2), b = 0
}

// xor(0,0) = 0   xor(1,0) = 1   xor(0,1) = 1   xor(1,1) = 0
Die verborgene Schicht verformt den Eingaberaum so, dass die Punkte danach linear trennbar sind. Das ist dieselbe Einsicht, die Prince später mit dem Bild des Faltens veranschaulicht. Historisch ist das Beispiel bedeutsam: Dass einfache Perzeptrons XOR nicht lernen können, trug Ende der 1960er-Jahre zum ersten Rückgang des Interesses an neuronalen Netzen bei.
Bausteine
| Thema | Kernaussage |
|---|---|
| Verlustfunktionen | aus maximaler Likelihood; Kreuzentropie statt quadratischem Fehler bei Klassifikation, weil sonst Gradienten verschwinden |
| Ausgabeeinheiten | linear für Zahlen, Sigmoid für ja oder nein, Softmax für mehrere Klassen |
| Verborgene Einheiten | ReLU als Standard; Sigmoid und Tangens hyperbolicus in verborgenen Schichten wegen Sättigung meist schlechter |
| Architektur | universeller Approximationssatz; tiefe Netze brauchen oft exponentiell weniger Einheiten als flache |
Rückpropagation als Rechengraph
Die Autoren beschreiben Rückpropagation allgemein: Jede Berechnung wird als Rechengraph dargestellt, dessen Knoten Operationen sind. Für die Ableitungen wird der Graph rückwärts durchlaufen, wobei jede Operation weiß, wie sie ihre eigene Ableitung beiträgt. Das ist genau das Prinzip, auf dem PyTorch und andere Frameworks aufbauen.
Einordnung
Dieses Kapitel ist zeitlos. Wer verstehen will, was PyTorch beim Aufruf von backward() tut, findet hier die klarste Darstellung. Für Softwareentwickler interessant: Rückpropagation ist ein Fall von dynamischer Programmierung, bei der Zwischenergebnisse gespeichert und wiederverwendet werden, damit man nicht für jeden Parameter neu rechnen muss; dasselbe Prinzip wie Memoisierung in klassischen Algorithmen, und derselbe Tausch von Speicher gegen Rechenzeit.
Regularisierung
Das siebte Kapitel ist eine systematische Sammlung von Techniken gegen Überanpassung, mit theoretischer Begründung:
| Technik | Idee | Bemerkung der Autoren |
|---|---|---|
| Gewichtsstrafen | große Gewichte im Verlust bestrafen | L2 macht Gewichte klein, L1 macht viele exakt null |
| Datenerweiterung | Varianten vorhandener Beispiele erzeugen | besonders wirksam bei Bildern |
| Frühes Stoppen | Training abbrechen, wenn der Validierungsfehler steigt | bei einfachen Modellen gleichwertig mit L2-Strafe |
| Parameter teilen | dieselben Gewichte an mehreren Stellen verwenden | Grundlage der Faltungsnetze |
| Ensembles | mehrere Modelle mitteln | zuverlässig, aber teuer |
| Dropout | zufällig Einheiten abschalten | wie ein Ensemble aus exponentiell vielen Teilnetzen, fast zum Preis eines einzigen |
| Lernen mehrerer Aufgaben | gemeinsame Schichten für verwandte Aufgaben | die Aufgaben regularisieren sich gegenseitig |
| Adversarielles Training | mit gezielt gestörten Beispielen trainieren | macht Modelle robuster gegen Täuschung |
Das adversarielle Training geht auf Goodfellows eigene Forschung zurück: Er zeigte, dass winzige, für Menschen unsichtbare Änderungen an einem Bild ein Netz zu völlig falschen Vorhersagen bringen können. Diese adversariellen Beispiele sind bis heute ein Sicherheitsthema, und Prompt-Injection bei Sprachmodellen ist ihr Verwandter in Textform.
Optimierung
Das achte Kapitel behandelt, warum das Training tiefer Netze schwierig ist und wie man es dennoch schafft.
Herausforderungen
- Schlechte Konditionierung: In manchen Richtungen ist die Landschaft steil, in anderen flach; ein einziger Schrittweitenwert passt dann nicht für alle.
- Lokale Minima, Plateaus und Sattelpunkte: Die Autoren argumentieren bereits 2016, dass in hohen Dimensionen Sattelpunkte das größere Problem sind als lokale Minima.
- Klippen und explodierende Gradienten: Plötzliche, sehr große Gradienten werfen das Training aus der Bahn; Begrenzung der Gradientenlänge hilft.
- Lange Abhängigkeiten: Bei rekurrenten Netzen werden Gradienten über viele Schritte hinweg zu klein oder zu groß.
Werkzeuge
Momentum, adaptive Verfahren wie RMSProp und Adam, das damals erst zwei Jahre alt war, sorgfältige Initialisierung und Batch-Normalisierung, die damals neueste und wichtigste Technik zum Stabilisieren des Trainings. Dazu Verfahren zweiter Ordnung, die die Krümmung der Landschaft nutzen, aber für große Netze zu teuer sind.
Einordnung
Die Grundlagen sind gültig; die Praxis hat sich verschoben. Heute dominiert AdamW statt Adam, in Transformern Layer-Normalisierung statt Batch-Normalisierung, und Restverbindungen, die im Buch noch kaum vorkommen, sind Standard. Die Aussage, dass Sattelpunkte wichtiger sind als lokale Minima, hat sich dagegen als weitsichtig erwiesen.
Faltungsnetze
Das neunte Kapitel begründet Faltungsnetze mit drei Eigenschaften:
| Eigenschaft | Bedeutung | Vorteil |
|---|---|---|
| Spärliche Verbindungen | jede Einheit sieht nur einen kleinen Ausschnitt der Eingabe | viel weniger Rechenaufwand |
| Geteilte Parameter | derselbe Filter wird überall angewendet | viel weniger Parameter |
| Äquivarianz | verschiebt man die Eingabe, verschiebt sich die Ausgabe mit | Muster werden überall erkannt |
Dazu kommen Verdichtung, Varianten der Faltung und ein Abschnitt über die neurowissenschaftlichen Wurzeln: Faltungsnetze sind vom Aufbau der Sehrinde inspiriert, wo einfache Zellen auf Kanten reagieren und komplexere auf Muster.
Rekurrente Netze
Das zehnte Kapitel ist eines der ausführlichsten und behandelt Sequenzen, also Text, Sprache und Zeitreihen.
Grundidee
Ein rekurrentes Netz wendet dieselbe Funktion Schritt für Schritt auf eine Sequenz an und trägt einen Zustand weiter. Für das Training wird es über die Zeit aufgefaltet, sodass es wie ein sehr tiefes Netz mit geteilten Gewichten aussieht; die Rückpropagation läuft dann rückwärts durch die Zeit.
Das Problem langer Abhängigkeiten
Bei langen Sequenzen werden Gradienten über viele Schritte hinweg mit denselben Gewichten multipliziert und schrumpfen oder explodieren dadurch. Das Netz „vergisst“ frühe Information. Die Autoren beschreiben die Lösungen der damaligen Zeit:
| Lösung | Idee |
|---|---|
| LSTM und GRU | Gatter steuern, was gespeichert, vergessen und ausgegeben wird; die meistgenutzten Sequenzmodelle bis etwa 2018 |
| Begrenzung der Gradienten | gegen explodierende Gradienten |
| Encoder-Decoder | eine Sequenz in eine andere übersetzen, etwa für maschinelle Übersetzung |
| Expliziter Speicher | Netze, die auf einen externen Speicher zugreifen; eine Vorstufe der Aufmerksamkeit |
Einordnung
Dieses Kapitel zeigt am deutlichsten, wie sich das Feld verändert hat. 2016 waren LSTMs der Stand der Technik für Sprache. Ein Jahr später erschien der Transformer, und heute verwendet kaum noch jemand rekurrente Netze für Text. Aufmerksamkeit kommt im Buch nur als Erweiterung der Encoder-Decoder-Modelle für Übersetzung vor. Trotzdem lohnt das Kapitel: Es zeigt das Problem, das der Transformer gelöst hat, und rekurrente Ideen kehren in neueren Architekturen für sehr lange Sequenzen zurück, wie Alammar und Grootendorst erwähnen.
Praktische Methodik
Das elfte Kapitel ist kurz, praktisch und erstaunlich zeitlos. Es beschreibt, wie man ein Deep-Learning-Projekt angeht, und deckt sich in vielem mit Huyen und Géron.
Das Vorgehen
- Ziele festlegen: Welche Kennzahl, welcher Zielwert? Die Autoren betonen, dass man das vor dem Bauen entscheiden muss.
- Schnell eine vollständige Pipeline aufbauen mit einem vernünftigen Standardmodell.
- Messen und Engpässe finden: Liegt es an Überanpassung, Unteranpassung, Daten oder Fehlern im Code?
- Gezielt verbessern: mehr Daten, andere Hyperparameter, andere Architektur, je nach Diagnose.
Abdeckung als Kennzahl
Aus Goodfellows Arbeit an der Erkennung von Hausnummern in Street-View-Bildern stammt ein schönes Beispiel: Das System musste nicht jedes Bild verarbeiten, durfte aber fast nie falsch liegen. Gemessen wurde deshalb die Abdeckung: der Anteil der Fälle, für die das System bei geforderter Genauigkeit eine Antwort gibt; den Rest übernehmen Menschen. Das ist ein Muster, das für viele Geschäftsanwendungen passt: lieber eine automatische Teilmenge mit hoher Sicherheit als alles mit mittlerer.
Hyperparameter
Die Lernrate ist der wichtigste Hyperparameter; wenn man nur einen einstellen kann, dann diesen. Für die automatische Suche empfehlen die Autoren Zufallssuche statt systematischer Gitter, weil meist nur wenige Hyperparameter wirklich zählen und Zufallssuche diese besser abdeckt.
Fehlersuche
Neuronale Netze haben eine unangenehme Eigenschaft: Fehler im Code führen oft nicht zum Absturz, sondern nur zu etwas schlechteren Ergebnissen. Die Autoren empfehlen:
| Technik | Zweck |
|---|---|
| Modell bei der Arbeit ansehen | Ausgaben betrachten, nicht nur Kennzahlen |
| Die schlimmsten Fehler ansehen | Muster in Fehlern finden |
| Einen winzigen Datensatz auswendig lernen | wenn das nicht gelingt, ist etwas grundsätzlich falsch |
| Gradienten numerisch prüfen | selbst implementierte Ableitungen mit einer Näherung vergleichen |
| Aktivierungen und Gradienten beobachten | Verteilungen über die Zeit, um tote Einheiten oder Explosionen zu erkennen |
// Numerische Gradientenprüfung: analytischen Gradienten mit zentraler Differenz vergleichen
static double maxRelativeError(ToDoubleFunction<double[]> loss,
                               double[] params, double[] analyticGrad) {
    double h = 1e-5, worst = 0;
    for (int i = 0; i < params.length; i++) {
        double original = params[i];
        params[i] = original + h; double up = loss.applyAsDouble(params);
        params[i] = original - h; double down = loss.applyAsDouble(params);
        params[i] = original;
        double numeric = (up - down) / (2 * h);
        double denom = Math.max(1e-12, Math.abs(numeric) + Math.abs(analyticGrad[i]));
        worst = Math.max(worst, Math.abs(numeric - analyticGrad[i]) / denom);
    }
    return worst;   // deutlich unter 1e-4 ist meist in Ordnung
}
Einordnung
„Einen winzigen Datensatz auswendig lernen“ ist ein Rauchtest im Sinne von Continuous Delivery: Er prüft schnell, ob das Gerüst grundsätzlich funktioniert. Die Gradientenprüfung ist ein Orakel-Test, wie man ihn aus der Softwareprüfung kennt: Eine langsame, aber offensichtlich richtige Berechnung prüft eine schnelle, aber fehleranfällige. Und die Abdeckung ist dasselbe Prinzip wie Nygards Fallback: Was das System nicht sicher kann, gibt es ab.
Anwendungen
Das zwölfte Kapitel gibt einen Überblick über den Stand von 2016: Training im großen Maßstab auf Grafikkarten und verteilten Systemen, Modellkompression, Bildverarbeitung, Spracherkennung, Sprachverarbeitung mit neuronalen Sprachmodellen und Aufmerksamkeit für Übersetzung, Empfehlungssysteme. Vieles davon ist überholt, aber der Abschnitt über neuronale Sprachmodelle zeigt die Wurzeln dessen, was später GPT wurde: Wörter als Vektoren, die nächste Einheit vorhersagen.
Der Forschungsteil
Der dritte Teil beschreibt, was die Autoren 2016 für die wichtigsten Forschungsrichtungen hielten. Er ist der anspruchsvollste und der am stärksten gealterte Teil des Buchs.
| Kapitel | Inhalt | Bedeutung heute |
|---|---|---|
| Lineare Faktormodelle | PCA, unabhängige Komponenten, Sparse Coding | Grundlagen, weiterhin nützlich |
| Autoencoder | verdichten und wiederherstellen, verrauschte Varianten | weiter im Einsatz, etwa zur Anomalieerkennung |
| Repräsentationslernen | wie Netze nützliche Darstellungen lernen, Transfer Learning, verteilte Darstellungen | zentral, die Grundidee hinter Embeddings und Foundation Models |
| Strukturierte probabilistische Modelle | Graphen zur Darstellung von Abhängigkeiten | Hintergrund, heute selten im Zentrum |
| Monte-Carlo-Methoden, Partitionsfunktion, näherungsweise Inferenz | mathematische Werkzeuge für probabilistische Modelle | teils in Diffusionsmodellen und Variational Autoencodern wiederzufinden |
| Tiefe generative Modelle | Boltzmann-Maschinen, Variational Autoencoder, GANs, autoregressive Netze | Boltzmann-Maschinen weitgehend verschwunden; GANs abgelöst; autoregressive Modelle sind heute die Grundlage der Sprachmodelle |
Repräsentationslernen
Das fünfzehnte Kapitel erweist sich rückblickend als besonders weitsichtig. Die Autoren argumentieren, dass gute Darstellungen die zugrunde liegenden Ursachen der Daten erfassen, dass Wissen aus einer Aufgabe auf andere übertragbar ist, und dass unbeschriftete Daten helfen können, solche Darstellungen zu lernen. Das ist im Kern das Rezept der heutigen Foundation Models: selbstüberwachtes Vortraining auf riesigen unbeschrifteten Daten, dann Anpassung an viele Aufgaben.
Was verschwunden ist
Das schichtweise unüberwachte Vortraining, das zwischen 2006 und etwa 2012 den Durchbruch tiefer Netze ermöglichte, beschreibt das Buch noch ausführlich. Durch ReLU, bessere Initialisierung und Normalisierung wurde es überflüssig. Ähnlich ging es den Boltzmann-Maschinen, denen das Buch viel Raum gibt.
Einordnung
Der Forschungsteil ist ein Lehrstück darüber, wie schwer Vorhersagen in einem schnellen Feld sind. Einige Richtungen, die viel Raum bekommen, sind verschwunden; eine, die eher am Rand steht, autoregressive Modelle, hat sich als der Weg zu den heutigen Sprachmodellen erwiesen. Brooks hätte darin eine Bestätigung gesehen, dass auch Experten die Zukunft ihres Fachs nur begrenzt vorhersehen.
Was seitdem geschah
Das Buch beschreibt den Stand kurz vor einem Umbruch. Fast alles, was die anderen KI-Bücher dieser Reihe behandeln, entstand danach.
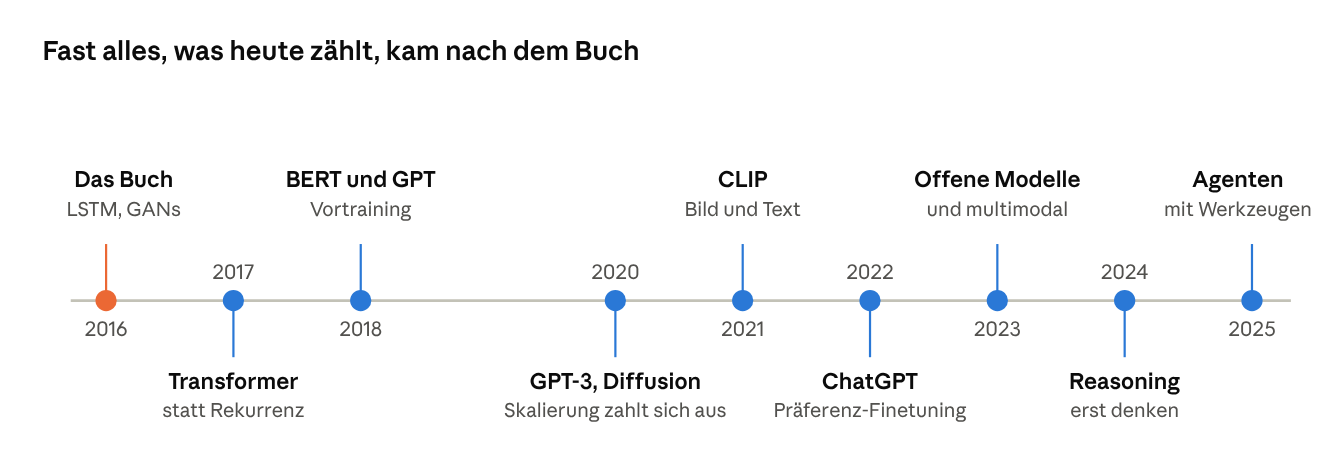
die wichtigsten Entwicklungen seit dem Erscheinen des Buchs, vereinfacht
Was trägt
| Thema | Warum es weiter gilt |
|---|---|
| Mathematische Grundlagen | lineare Algebra, Wahrscheinlichkeit und Numerik altern nicht |
| Maximale Likelihood, Kreuzentropie | jedes Sprachmodell wird damit trainiert |
| Rückpropagation als Rechengraph | Grundlage aller Frameworks |
| Regularisierung, Optimierung | Begriffe und Prinzipien gelten, Details haben sich verschoben |
| Praktische Methodik | fast unverändert gültig |
| Repräsentationslernen | Grundidee der Foundation Models |
| Adversarielle Beispiele | aktueller denn je, als Sicherheitsthema |
Was überholt ist
| Thema im Buch | Heute |
|---|---|
| LSTM als Stand der Technik für Sprache | Transformer |
| Aufmerksamkeit als Zusatz | Aufmerksamkeit als Kern |
| Batch-Normalisierung | Layer-Normalisierung in Transformern |
| GANs als führende Bilderzeugung | Diffusionsmodelle |
| Boltzmann-Maschinen, schichtweises Vortraining | praktisch verschwunden |
| Modelle für einzelne Aufgaben trainieren | ein großes vortrainiertes Modell für viele Aufgaben anpassen |
| Größenordnung von Millionen Parametern | Milliarden bis Billionen |
Was fehlt ganz
Skalierungsgesetze, Prompting und In-Context-Learning, Präferenz-Finetuning, RAG, Agenten, Evaluation offener Ausgaben. Dafür sind Huyen, Raschka sowie Alammar und Grootendorst die Ergänzung.
Einordnung
Bemerkenswert ist, was nicht veraltet ist: die Grundlagen. Das bestätigt eine Erfahrung aus der Softwaretechnik, die man aus Brooks und The Pragmatic Programmer kennt: Prinzipien überleben Werkzeuge. Wer die Grundlagen aus diesem Buch kennt, kann neue Architekturen schnell einordnen; wer nur die neuesten Werkzeuge kennt, muss bei jedem Umbruch neu anfangen.
Kritik und Einordnung
Stärken
- Autorität: von drei Forschern geschrieben, die das Feld selbst geprägt haben.
- Gründlichkeit: sorgfältige mathematische Darstellung, die bis heute als Referenz dient.
- Zeitlose Kapitel: Mathematik, Feedforward-Netze, Rückpropagation, praktische Methodik.
- Weitblick an einzelnen Stellen: Repräsentationslernen, Sattelpunkte, adversarielle Beispiele.
- Kostenlos online.
Kritikpunkte
1. Veraltet in den Anwendungen. Kein Transformer, keine Sprachmodelle im heutigen Sinn, keine Diffusion. Für das, was heute praktisch zählt, braucht man andere Bücher.
2. Gewichtung des Forschungsteils. Viel Raum für Richtungen, die sich nicht durchgesetzt haben, wenig für die, die es taten.
3. Schwer zugänglich. Dichter und formaler als Prince, mit weniger Abbildungen und Intuition. Wer neu einsteigt, ist mit Prince besser bedient.
4. Kein Code. Weder Übungen noch Notebooks; Verständnis entsteht nur durch Lesen.
Prince oder Goodfellow?
| Goodfellow, Bengio, Courville (2016) | Prince (2023) | |
|---|---|---|
| Mathematik | ausführlich, eigener Grundlagenteil | vorausgesetzt, Anhänge zum Auffrischen |
| Abbildungen | wenige | sehr viele |
| Transformer, Diffusion | fehlen | enthalten |
| Offene Fragen | kaum thematisiert | eigenes Kapitel |
| Ethik | nicht behandelt | eigenes Kapitel |
| Übungen | keine | rund 70 Notebooks |
| Stärke heute | Grundlagen, Methodik, historischer Kontext | aktuelles Verständnis |
Gesamturteil
Für Neueinsteiger ist Prince heute die bessere Wahl. Goodfellow, Bengio und Courville bleibt wertvoll als Referenz für Grundlagen, für die praktische Methodik und als Zeitdokument: Es zeigt, wie das Feld unmittelbar vor seinem größten Umbruch dachte. Für einen Leser dieser Reihe lohnt sich vor allem die Lektüre der Kapitel 5, 6 und 11; der Rest bei Bedarf zum Nachschlagen.
Bezüge zur Reihe
| Thema bei Goodfellow, Bengio, Courville | Bezug in der Reihe |
|---|---|
| Numerisch stabiler Softmax | Raschka: Java-Beispiel zur Aufmerksamkeit |
| Maximale Likelihood | Prince: Verlustfunktionen; Raschka: Kreuzentropie |
| XOR und verborgene Schichten | Prince: Faltung des Eingaberaums |
| Rückpropagation als Rechengraph | Raschka, Géron: PyTorch; Sedgewick: Graphalgorithmen |
| Dropout als günstiges Ensemble | Géron: Ensembles |
| Adversarielle Beispiele | Huyen: Prompt-Injection und Sicherheit |
| Sattelpunkte statt lokaler Minima | Prince: Verlustlandschaft |
| LSTM und lange Abhängigkeiten | Raschka, Géron: Transformer als Lösung |
| Praktische Methodik, erst Ziele und Pipeline | Huyen: vier Phasen; Géron: Projekt-Checkliste; Thomas und Hunt: Tracer Bullets |
| Abdeckung als Kennzahl | Nygard: Fallback; Huyen: würdig scheitern |
| Kleinen Datensatz auswendig lernen | Humble und Farley: Rauchtests |
| Gradientenprüfung | Feathers, Khorikov: Tests gegen ein einfaches Orakel |
| Repräsentationslernen | Alammar und Grootendorst: Embeddings; Huyen: Foundation Models |
| Überholte Forschungsrichtungen | Brooks: begrenzte Vorhersagbarkeit; Prinzipien überleben Werkzeuge |
Diskussionsfragen
- Zeitlos oder veraltet: Welche Teile deines eigenen Fachwissens sind in den letzten zehn Jahren veraltet, welche haben getragen?
- Grundlagen: Wie viel Mathematik sollte ein Architekt beherrschen, der KI-Systeme verantwortet?
- Abdeckung: Gibt es bei euch Prozesse, in denen ein System nur die sicheren Fälle automatisch erledigen und den Rest an Menschen geben sollte?
- Fehlersuche: Welche der Debugging-Techniken, etwa einen winzigen Datensatz auswendig lernen, ließen sich auf eure KI-Anwendungen übertragen?
- Adversarielle Beispiele: Wie robust sind eure KI-Anwendungen gegen gezielte Täuschung?
- Prognosen: Wenn du heute ein Buch über KI schreiben würdest, welche Kapitel würden in zehn Jahren veraltet sein?
- Lesen: Lohnt sich für dich die Lektüre des Originals, oder reicht Prince mit dieser Zusammenfassung?
- Weiter: Als Nächstes Russell und Norvig, Artificial Intelligence: A Modern Approach, das KI weit über Deep Learning hinaus behandelt.