Continuous Delivery – Zusammenfassung und Einordnung
Jez Humble, David Farley, Continuous Delivery: Reliable Software Releases through Build, Test, and Deployment Automation (2010)
Einleitung
Continuous Delivery ist das Buch, das die technische Grundlage für alles liefert, was Accelerate acht Jahre später empirisch untersucht hat. Die Kernthese: Software soll jederzeit auslieferbar sein. Jede Änderung durchläuft einen automatisierten Prozess, an dessen Ende eine Version steht, die man mit einem Knopfdruck in Produktion bringen könnte. Ob man es tut, ist dann eine geschäftliche Entscheidung, keine technische.
Autoren und Kontext
Jez Humble und David Farley arbeiteten Mitte der 2000er bei ThoughtWorks an großen Projekten, in denen Releases Wochen der Vorbereitung, nächtliche Einsätze und viel Angst bedeuteten. Farley hatte zuvor an Hochleistungssystemen für den Börsenhandel gearbeitet, unter anderem bei LMAX. Das Buch erschien 2010 und gewann im folgenden Jahr den Jolt Award.
Der Begriff selbst stammt aus dem ersten Prinzip des Agilen Manifests von 2001: Kunden durch frühe und kontinuierliche Auslieferung wertvoller Software zufriedenstellen. Humble und Farley machten daraus eine konkrete technische Disziplin.
Humble wurde später Mitautor von Accelerate und Mitgründer von DORA. Farley schrieb 2021 Modern Software Engineering und betreibt einen bekannten YouTube-Kanal zu Continuous Delivery.
Abgrenzung der Begriffe
| Begriff | Bedeutung |
|---|---|
| Continuous Integration | Alle Entwickler integrieren ihre Änderungen mindestens täglich in den Hauptzweig; ein automatischer Build mit Tests prüft jede Integration. |
| Continuous Delivery | Jede Änderung, die alle Stufen der Pipeline besteht, ist auslieferbar. Die Auslieferung in Produktion ist ein Knopfdruck, aber eine bewusste Entscheidung. |
| Continuous Deployment | Jede Änderung, die alle Stufen besteht, geht automatisch in Produktion, ohne manuellen Schritt. |
Das Buch behandelt vor allem Continuous Delivery; Continuous Deployment beschreibt es als mögliche Erweiterung.
Aufbau
| Teil | Kapitel | Inhalt |
|---|---|---|
| I. Grundlagen | 1–4 | das Problem der Auslieferung, Konfigurationsmanagement, Continuous Integration, Teststrategie |
| II. Die Deployment-Pipeline | 5–10 | Aufbau der Pipeline, Build-Skripte, Commit-Stufe, Akzeptanztests, nichtfunktionale Tests, Ausliefern und Freigeben |
| III. Das Ökosystem | 11–15 | Infrastruktur und Umgebungen, Daten, Komponenten und Abhängigkeiten, Versionskontrolle, Steuerung von Continuous Delivery |
Mit rund 500 Seiten ist das Buch ausführlich; viele Kapitel lassen sich unabhängig lesen.
Das Problem der Auslieferung
Die Autoren beginnen mit einem Bild, das 2010 vielen vertraut war: Ein Release-Tag rückt näher. Das Team hat Wochen oder Monate entwickelt, aber nie in einer produktionsähnlichen Umgebung ausgeliefert. Jetzt wird ein Dokument mit Dutzenden manueller Schritte abgearbeitet, nachts, unter Druck. Etwas geht schief, niemand weiß genau warum, und am Ende wird ein Hotfix direkt auf dem Server eingespielt.
Drei Antipatterns
| Antipattern | Symptom | Folge |
|---|---|---|
| Manuelle Auslieferung | ausführliche Anleitungen, Spezialisten, die als einzige wissen, wie es geht | Fehler, Abhängigkeit von Einzelpersonen, jede Auslieferung ist anders |
| Produktionsähnliche Umgebung erst am Ende | erste Auslieferung auf Test- oder Produktionsumgebung kurz vor dem Release | Integrationsprobleme werden spät entdeckt, wenn sie am teuersten sind |
| Manuelle Konfiguration der Produktion | Server werden von Hand eingerichtet und angepasst | Umgebungen unterscheiden sich unbemerkt, Fehler lassen sich nicht reproduzieren |
Das Ziel
Statt seltener, großer, riskanter Releases: häufige, kleine, langweilige Auslieferungen. Jede Auslieferung soll so routiniert sein, dass sie kein Ereignis mehr ist. Die Autoren nennen dafür vier Vorteile: geringeres Risiko, weil jede Änderung klein ist; schnellere Rückmeldung, weil Fehler früh auffallen; weniger Stress für das Team; und die Möglichkeit, geschäftliche Ideen schnell zu überprüfen.
Die acht Prinzipien
| Prinzip | Bedeutung |
|---|---|
| Ein wiederholbarer, zuverlässiger Prozess | Ausliefern soll immer gleich ablaufen, für jede Umgebung |
| Fast alles automatisieren | Build, Tests, Auslieferung, Infrastruktur, Datenbankänderungen; manuell bleiben nur Entscheidungen und explorative Tests |
| Alles in die Versionskontrolle | Code, Tests, Skripte, Konfiguration, Infrastruktur, Datenbankschemata, Dokumentation |
| Was weh tut, öfter tun | Wenn Integration oder Auslieferung schmerzhaft sind, häufiger durchführen, bis sie es nicht mehr sind |
| Qualität einbauen | Fehler früh finden und sofort beheben, statt am Ende testen; Deming und Lean |
| Fertig heißt ausgeliefert | Eine Funktion ist erst fertig, wenn sie in Produktion oder zumindest in einer produktionsähnlichen Umgebung läuft |
| Alle sind verantwortlich | Entwicklung, Test und Betrieb tragen den Auslieferungsprozess gemeinsam |
| Ständige Verbesserung | Den Prozess regelmäßig betrachten und verbessern |
„Was weh tut, öfter tun“
Das vielleicht bekannteste Prinzip verdient einen Moment. Die Intuition sagt: Wenn etwas schmerzhaft ist, tut man es selten. Die Autoren argumentieren umgekehrt: Seltenes Integrieren und Ausliefern führt zu großen Unterschieden, die dann umso schwieriger zusammenzuführen sind. Häufiges Tun macht jeden Schritt klein und zwingt dazu, den Prozess zu automatisieren. Der Schmerz wird nach vorn geholt, wo er billig ist.
Das ist dasselbe Argument, das Beck in Tidy First? für kleine Änderungen macht und das Accelerate mit Daten belegt: Kleine Losgrößen senken Risiko und Kosten.
Einordnung
Die Prinzipien wirken 2026 selbstverständlich. 2010 waren sie es nicht; in vielen Unternehmen galten quartalsweise Releases mit wochenlanger Testphase als verantwortungsvoll. Das Buch hat maßgeblich dazu beigetragen, dass sich das geändert hat.
Konfigurationsmanagement
Konfigurationsmanagement heißt bei Humble und Farley: Jedes Artefakt, das für Bau, Test und Betrieb nötig ist, wird versioniert und ist reproduzierbar. Die Prüffrage: Könnte man aus dem Inhalt der Versionskontrolle und einer leeren Maschine die Produktionsumgebung jedes beliebigen Releases wiederherstellen?
Was versioniert wird
- Quellcode und Tests
- Build- und Auslieferungsskripte
- Konfiguration für alle Umgebungen
- Datenbankschemata und Migrationsskripte
- Infrastrukturdefinitionen, Betriebssystem- und Middleware-Konfiguration
- Abhängigkeiten in festgelegten Versionen
Konfiguration der Anwendung
Die Autoren unterscheiden, wann Konfiguration angewendet wird: beim Bauen, beim Ausliefern, beim Start oder zur Laufzeit. Ihre wichtigste Regel: Ein Binärartefakt für alle Umgebungen. Was sich zwischen Test und Produktion unterscheidet, gehört in die Konfiguration, die beim Ausliefern oder Start angewendet wird, nicht in unterschiedliche Builds. Konfiguration soll außerdem getestet werden, etwa durch Prüfen, ob alle referenzierten Dienste erreichbar sind.
Umgebungen
Umgebungen sollen vollautomatisch aufgebaut werden können. Ein Server, der über Jahre von Hand angepasst wurde und den niemand mehr nachbauen kann, ist ein Risiko. Später etablierte sich dafür der Gegensatz von Schneeflocken-Servern, die einzigartig und unersetzlich sind, und Phönix-Servern, die jederzeit neu aus ihrer Definition entstehen können.
Continuous Integration
CI ist die Voraussetzung für alles Weitere. Die Autoren betonen, dass CI eine Praxis ist, kein Werkzeug: Ein CI-Server allein macht noch keine Continuous Integration.
Voraussetzungen
- Versionskontrolle für alles
- Ein automatischer Build, der von der Kommandozeile startet
- Die Zustimmung des Teams, sich an die Regeln zu halten
Die Regeln
- Nicht einchecken, wenn der Build rot ist. Erst reparieren, dann weiter.
- Vor dem Einchecken lokal alle Commit-Tests ausführen.
- Nach dem Einchecken warten, bis der Build grün ist, bevor man an etwas anderem arbeitet.
- Nie mit rotem Build nach Hause gehen.
- Immer bereit sein, zurückzurollen. Wenn eine Reparatur nicht in wenigen Minuten gelingt, die Änderung zurücknehmen.
- Fehlschlagende Tests nicht auskommentieren.
- Verantwortung für das übernehmen, was man kaputtgemacht hat, auch in fremdem Code.
Integrieren heißt in den Hauptzweig
Ein wichtiger Punkt, der oft übersehen wird: Continuous Integration heißt, mindestens täglich in den Hauptzweig zu integrieren. Wer wochenlang auf einem Feature-Branch arbeitet und dort einen CI-Server laufen lässt, integriert nicht kontinuierlich, sondern nur mit sich selbst. Accelerate hat genau das als Trunk-Based Development untersucht und als Merkmal leistungsfähiger Teams bestätigt.
Einordnung
Die CI-Regeln sind eine Teamvereinbarung, keine Technik. Sie ähneln Toyotas Andon-Leine, die jeder Arbeiter ziehen kann, um das Band anzuhalten, wenn ein Fehler auftritt. Ein roter Build ist ein angehaltenes Band, und das Team kümmert sich zuerst darum.
Teststrategie
Die Autoren räumen gleich zu Beginn mit einer Vorstellung auf: Qualität entsteht nicht durch eine Testphase am Ende. Tests sind Teil der Entwicklung, und automatisierte Tests sind die Voraussetzung dafür, dass eine Pipeline überhaupt etwas über die Auslieferbarkeit sagen kann.
Die Testquadranten
Zur Einordnung übernehmen sie die Quadranten von Brian Marick. Eine Achse unterscheidet fachliche von technischen Tests, die andere Tests, die die Entwicklung unterstützen, von solchen, die das Produkt kritisch prüfen.
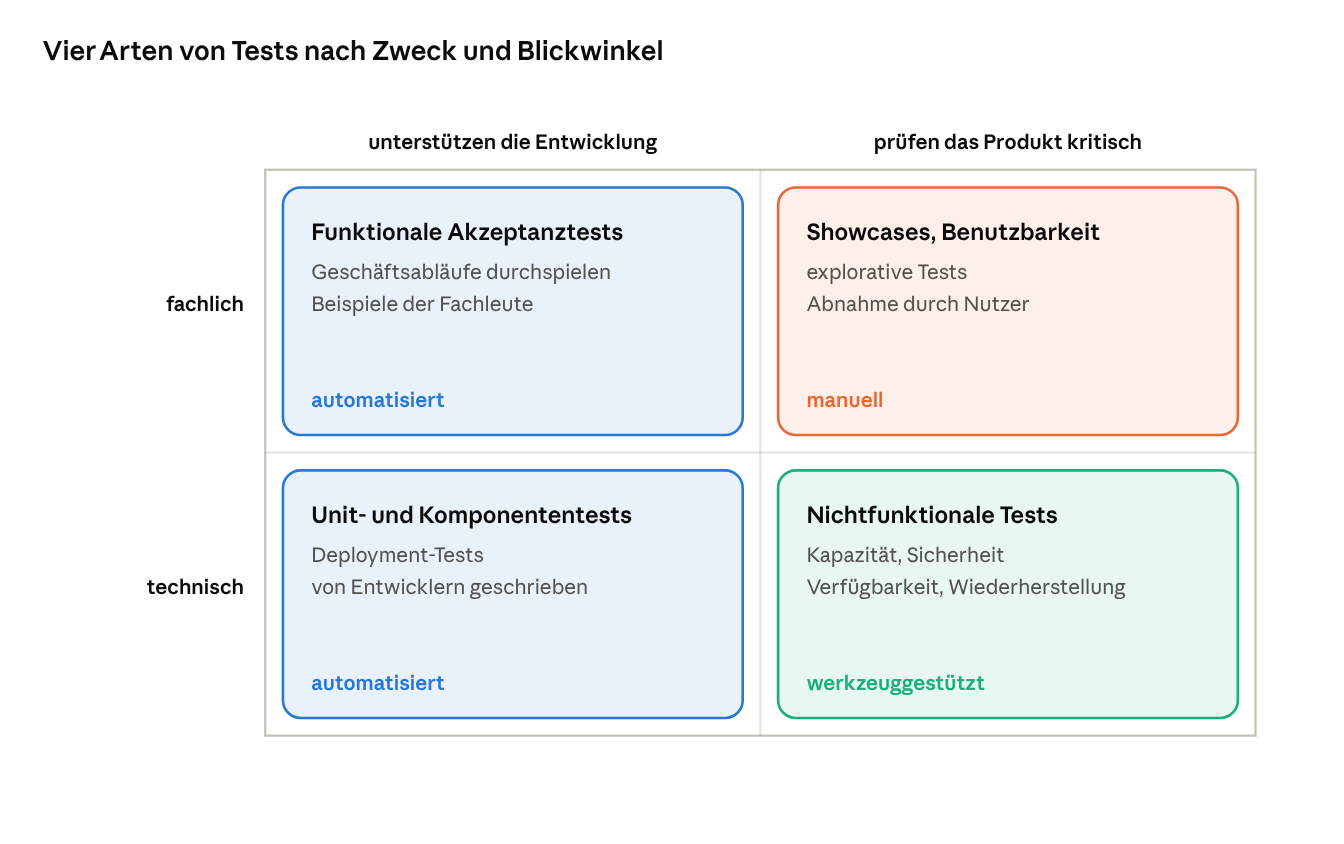
die Testquadranten nach Brian Marick, wie Humble und Farley sie verwenden
- Unterstützende Tests zeigen den Entwicklern, ob sie das Richtige richtig bauen. Sie müssen schnell und automatisiert sein.
- Kritische Tests suchen nach dem, was niemand vorhergesehen hat: Benutzbarkeitsprobleme, Lastgrenzen, Sicherheitslücken.
Was automatisiert wird
Die Autoren empfehlen, die beiden linken Quadranten vollständig zu automatisieren und die nichtfunktionalen Tests weitgehend. Manuell bleiben explorative Tests, Benutzbarkeitstests und Vorführungen, also die Arbeit, bei der menschliches Urteil gefragt ist. Menschen sollen nicht wiederholen, was Maschinen besser können, sondern das tun, was Maschinen nicht können.
Die Testpyramide
Ergänzend verweisen sie auf die Pyramide von Mike Cohn: viele schnelle Unit-Tests an der Basis, weniger Integrations- und Akzeptanztests darüber, wenige Tests über die Oberfläche an der Spitze. Oberflächentests sind langsam und brüchig.
Bestehende Projekte
Für Projekte ohne Tests empfehlen sie, mit Akzeptanztests für die wertvollsten Abläufe zu beginnen und dann bei jeder Änderung Tests hinzuzufügen. Das ist Feathers‘ Strategie aus Working Effectively with Legacy Code, auf Systemebene angewandt.
Die Deployment-Pipeline
Das zentrale Konzept des Buchs ist die Deployment-Pipeline: eine automatisierte Darstellung des Weges, den jede Änderung von der Versionskontrolle bis in die Produktion nimmt. Jede Stufe prüft einen Aspekt der Auslieferbarkeit; besteht eine Änderung eine Stufe nicht, kommt sie nicht weiter.
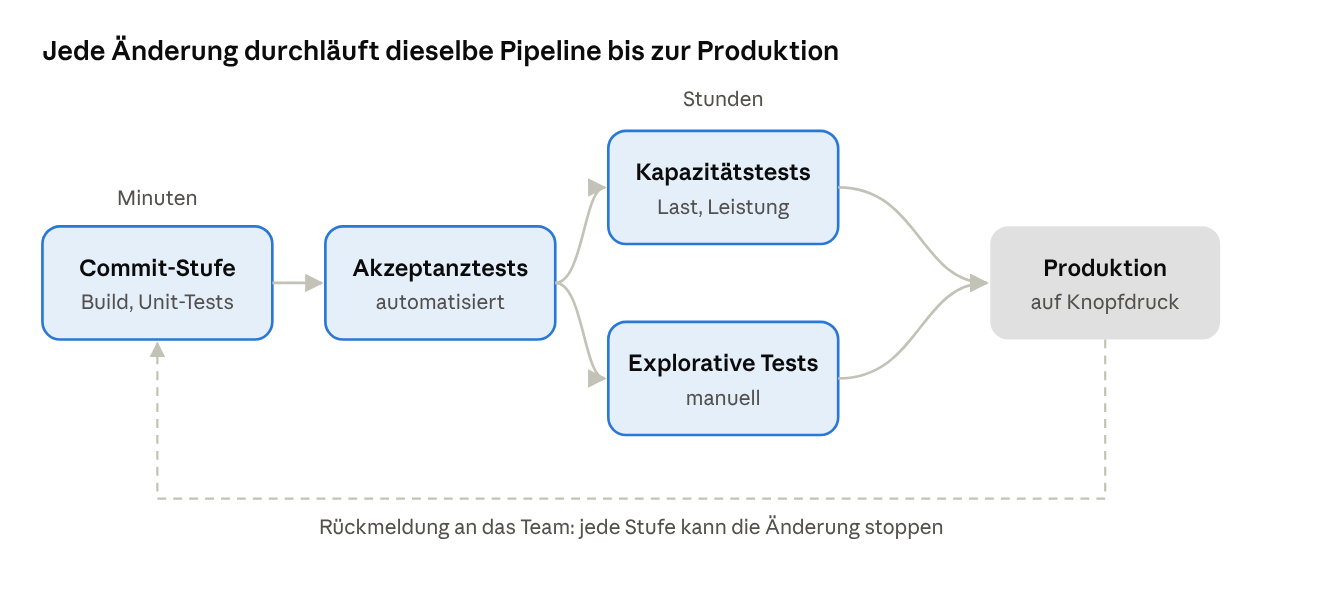
eine typische Deployment-Pipeline nach Humble und Farley · schnelle Stufen zuerst
Die Stufen
| Stufe | Zweck | Dauer |
|---|---|---|
| Commit-Stufe | kompilieren, Unit-Tests, statische Analyse, Binärartefakt erzeugen | wenige Minuten, idealerweise unter zehn |
| Automatisierte Akzeptanztests | fachliche Abläufe in einer produktionsähnlichen Umgebung prüfen | bis zu einer Stunde oder mehr |
| Kapazitätstests | Leistung und Last prüfen | je nach Umfang |
| Manuelle Tests | explorative Tests, Benutzbarkeit, Abnahme | nach Bedarf |
| Produktion | Auslieferung auf Knopfdruck | Minuten |
Die Reihenfolge folgt einem einfachen Prinzip: Schnelle Tests zuerst. Die Commit-Stufe soll die meisten Fehler in wenigen Minuten finden, damit Entwickler sofort reagieren können. Langsamere Stufen laufen danach, oft parallel.
Die Regeln der Pipeline
- Binärartefakte nur einmal bauen. Dasselbe Artefakt, das in der Commit-Stufe entstand, läuft durch alle Stufen bis in die Produktion. Sonst testet man etwas anderes, als man ausliefert.
- In jede Umgebung auf dieselbe Weise ausliefern. Dasselbe Skript für Test, Abnahme und Produktion; nur die Konfiguration unterscheidet sich. So wird das Auslieferungsskript selbst bei jeder Stufe getestet.
- Nach jeder Auslieferung einen Rauchtest. Ein kurzer Test prüft, ob die Anwendung läuft und ihre Abhängigkeiten erreicht.
- In eine Kopie der Produktion ausliefern. Testumgebungen sollen der Produktion so ähnlich wie möglich sein: Betriebssystem, Middleware, Netzwerk, Konfiguration.
- Jede Änderung läuft sofort durch die Pipeline.
- Schlägt eine Stufe fehl, stoppt die Linie. Das Team kümmert sich zuerst um den Fehler.
Die Pipeline als Sichtbarkeit
Neben der Automatisierung hat die Pipeline eine zweite Funktion: Sie macht den Zustand jeder Änderung sichtbar. Jeder kann sehen, welche Version welche Stufe bestanden hat, welche in welcher Umgebung läuft und wer sie wann freigegeben hat. Das ersetzt viele Besprechungen und Freigabedokumente.
Einordnung
Die Pipeline ist eine Wertstromdarstellung im Sinne von Lean, angewandt auf Software. Sie ist der technische Mechanismus hinter Accelerates Kennzahlen: Lead Time ist die Zeit durch die Pipeline, Deployment-Häufigkeit die Rate, mit der sie Produktion erreicht.
Die Commit-Stufe
Die Commit-Stufe ist der wichtigste Teil der Pipeline, weil sie die schnellste Rückmeldung gibt. Sie läuft bei jedem Einchecken und soll in weniger als zehn Minuten zeigen, ob die Änderung grundsätzlich in Ordnung ist.
Was sie tut
- Code kompilieren
- Unit-Tests ausführen, plus eine kleine Auswahl schneller Tests anderer Art
- Statische Analyse: Codemetriken, Testabdeckung, Architekturregeln
- Binärartefakte erzeugen und in einem Artefakt-Repository ablegen
- Testdaten und Datenbankmigrationen für spätere Stufen vorbereiten
Regeln für Commit-Tests
- Schnell: keine Datenbank, kein Dateisystem, kein Netzwerk, keine Oberfläche, keine Wartezeiten. Abhängigkeiten werden durch Test-Doubles ersetzt.
- Aussagekräftig: Die Commit-Stufe soll etwa achtzig Prozent der Fehler finden, die später auftauchen würden.
- Den Build auch aus anderen Gründen scheitern lassen: etwa bei Compiler-Warnungen, Verstößen gegen Architekturregeln oder sinkender Testabdeckung. Das sind die Fitness Functions, die Richards und Ford später so nennen.
Automatisierte Akzeptanztests
Akzeptanztests prüfen, ob die Anwendung tut, was die Fachleute erwarten, aus Sicht eines Nutzers und in einer produktionsähnlichen Umgebung.
Drei Schichten
Die Autoren empfehlen, Akzeptanztests in Schichten aufzubauen, damit sie nicht bei jeder Änderung der Oberfläche brechen:
| Schicht | Inhalt |
|---|---|
| Akzeptanzkriterien | in fachlicher Sprache, etwa als Gegeben–Wenn–Dann |
| Testimplementierung | Code, der die Kriterien ausführt, in der Sprache der Domäne |
| Application Driver | eine Schicht, die weiß, wie man mit der Anwendung spricht: über die Oberfläche, eine API oder Nachrichten |
// Akzeptanztest in der Sprache der Domäne
@Test
void customerCanPlaceOrderForAvailableProduct() {
    var customer = shop.registerCustomer("Sven");               // Application Driver
    var product  = shop.stockProduct("Clean Code", 10);

    var order = customer.placeOrder(product, 2);

    assertThat(order.status()).isEqualTo("confirmed");
    assertThat(shop.stockOf(product)).isEqualTo(8);
}

// Application Driver kapselt den Zugang, hier über die REST-API
class ShopDriver {
    private final RestClient client;
    CustomerDriver registerCustomer(String name) { … POST /customers … }
    ProductRef stockProduct(String title, int quantity) { … POST /products … }
    int stockOf(ProductRef p) { … GET /products/{id}/stock … }
}
Wenn sich der Zugang ändert, etwa von einer Weboberfläche zu einer API, muss nur der Driver angepasst werden. Das ist dasselbe Prinzip wie GOOS‘ Application Runner und eine Form von Fowlers Gateway.
Weitere Regeln
- Jeder Test bringt seine eigenen Daten mit und ist unabhängig von anderen Tests. So lassen sich Tests parallel ausführen.
- Asynchrones Verhalten wird durch Abfragen mit Zeitlimit statt durch feste Wartezeiten geprüft.
- Die Suite muss gepflegt werden wie Produktionscode. Langsame oder flackernde Tests untergraben das Vertrauen.
- Akzeptanztests sind Sache des ganzen Teams, nicht einer separaten Testabteilung.
Einordnung
Die Schichtung entspricht der Testpyramide und GOOS‘ äußerer Schleife. Accelerate bestätigte später, dass automatisierte Tests, die von Entwicklern geschrieben und gepflegt werden, mit hoher Leistung zusammenhängen, ausgelagerte Testautomatisierung dagegen nicht.
Ausliefern und Freigeben
Eine der wichtigsten Unterscheidungen des Buchs: Ausliefern (Deployment) heißt, eine Version technisch in eine Umgebung zu bringen. Freigeben (Release) heißt, sie für Nutzer verfügbar zu machen. Wer beides trennt, kann häufig ausliefern, ohne jedes Mal Nutzer einem Risiko auszusetzen.
Strategien
| Strategie | Funktionsweise | Vorteil |
|---|---|---|
| Blue-Green Deployment | zwei identische Produktionsumgebungen; die neue Version wird auf der inaktiven ausgeliefert und getestet, dann wird der Router umgeschaltet | Umschalten in Sekunden, Rücknahme ebenso |
| Canary Release | die neue Version erhält zunächst nur einen kleinen Teil des Verkehrs | Fehler betreffen wenige Nutzer, Leistung lässt sich unter echter Last messen |
| Feature Toggles | neue Funktionen sind im Code, aber abgeschaltet, bis sie freigegeben werden | unfertige Arbeit kann im Hauptzweig liegen, Freigabe ohne Auslieferung |
| Dark Launching | neue Funktion läuft im Hintergrund mit echten Daten, ohne dass Nutzer sie sehen | Leistung und Korrektheit vor der Freigabe prüfen |
// Feature Toggle: Auslieferung und Freigabe getrennt
@Service
class CheckoutService {
    private final FeatureFlags flags;
    private final LegacyPricing legacy;
    private final NewPricing next;

    Money price(Cart cart, Customer customer) {
        return flags.isEnabled("new-pricing", customer)      // z. B. 5 % der Kunden
            ? next.price(cart)
            : legacy.price(cart);
    }
}
Die Autoren warnen bereits, dass Feature Toggles Schulden sind: Jeder Schalter verdoppelt die möglichen Pfade durch den Code. Alte Schalter müssen nach der Freigabe entfernt werden.
Rücknahme
Jeder Auslieferungsplan braucht einen Rücknahmeplan, und dieser soll genauso automatisiert und getestet sein wie die Auslieferung selbst. Am einfachsten: die vorherige Version mit demselben Prozess erneut ausliefern. Die eigentliche Schwierigkeit liegt bei Datenbankänderungen, die rückwärtskompatibel sein müssen.
Notfallkorrekturen
Auch Notfallkorrekturen laufen durch die Pipeline. Wer im Notfall Abkürzungen nimmt, etwa direkt auf dem Server ändert, erzeugt eine Version, die nirgends dokumentiert und nicht reproduzierbar ist. Wenn die Pipeline für Notfälle zu langsam ist, ist sie zu langsam, und man sollte sie beschleunigen statt umgehen.
Einordnung
Blue-Green und Canary sind heute in Kubernetes, Service Meshes und Cloud-Plattformen eingebaut. Feature Toggles haben sich zu eigenen Produkten entwickelt, etwa LaunchDarkly, Unleash oder OpenFeature als offener Standard. Nygards Kapitel über Auslieferung ohne Ausfallzeit beschreibt dieselben Techniken aus Betriebssicht.
Infrastruktur und Umgebungen
Die Autoren fordern, dass Infrastruktur wie Code behandelt wird: Server, Netzwerk, Middleware und Betriebssystemkonfiguration werden in Skripten beschrieben, versioniert und automatisch aufgebaut. 2010 hießen die Werkzeuge Puppet, Chef und CFEngine; der Begriff Infrastructure as Code setzte sich erst in den Jahren danach durch. Sie betonen außerdem, dass Entwicklung und Betrieb von Anfang an zusammenarbeiten müssen, eine der Wurzeln der DevOps-Bewegung, die etwa zur selben Zeit entstand.
Daten verwalten
Datenbanken sind der schwierigste Teil der Automatisierung, weil sie Zustand haben, der nicht verloren gehen darf.
- Migrationen versionieren: Jede Schemaänderung ist ein nummeriertes Skript in der Versionskontrolle. Die Datenbank kennt ihre aktuelle Version und spielt fehlende Skripte ein.
- Rückwärtskompatibel ändern: Schemaänderungen werden so gestaltet, dass alte und neue Anwendungsversion gleichzeitig damit arbeiten können. So lassen sich Anwendung und Datenbank unabhängig ausliefern und zurücknehmen.
- Testdaten kontrollieren: Tests sollen ihre Daten selbst erzeugen oder mit kleinen, bekannten Datensätzen arbeiten, nicht mit Kopien der Produktion.
-- V41__add_email_column.sql  (Expand: neue Spalte, alte bleibt)
ALTER TABLE customers ADD COLUMN email_address VARCHAR(255);
UPDATE customers SET email_address = email;

-- Anwendung schreibt in beide Spalten, liest aus der neuen …

-- V42__drop_old_email_column.sql  (Contract: erst nach Umstellung aller Versionen)
ALTER TABLE customers DROP COLUMN email;
In Java übernehmen Flyway oder Liquibase das Einspielen. Das Muster heißt heute meist Expand and Contract oder Parallel Change, wie in der Release-It!-Zusammenfassung beschrieben.
Komponenten und Abhängigkeiten
Große Systeme bestehen aus Komponenten, die getrennt gebaut, aber zusammen ausgeliefert werden. Die Autoren behandeln, wie man Abhängigkeiten zwischen Komponenten verwaltet, Versionen festlegt und eine Pipeline für mehrere Komponenten aufbaut.
Besonders bekannt geworden ist Branch by Abstraction: Statt einen langen Branch für eine große Umstellung anzulegen, führt man im Hauptzweig eine Abstraktion ein, implementiert dahinter schrittweise die neue Lösung, schaltet um und entfernt die alte. Das System bleibt die ganze Zeit auslieferbar. Das ist Feathers‘ Seam und Becks kleiner Schritt, auf große Umbauten angewendet.
Versionskontrolle
Das Kapitel über Branching ist eines der meistdiskutierten. Die Autoren argumentieren:
- Lange lebende Feature-Branches widersprechen Continuous Integration, weil Änderungen erst spät zusammengeführt werden. Je länger ein Branch lebt, desto teurer wird das Zusammenführen.
- Entwicklung auf dem Hauptzweig mit Feature Toggles und Branch by Abstraction ist der bevorzugte Weg.
- Release-Branches sind akzeptabel, um eine ausgelieferte Version zu stabilisieren, solange Korrekturen auch in den Hauptzweig fließen.
Diese Position war 2010 umstritten und ist es teilweise bis heute. Accelerate hat sie mit Daten gestützt: Teams mit kurzlebigen Branches, die nach höchstens einem Tag zusammengeführt werden, liefern schneller und stabiler aus.
Continuous Delivery steuern
Das letzte Kapitel beschreibt ein Reifegradmodell in mehreren Stufen für Build, Umgebungen, Tests, Daten und Releasemanagement, mit dem Organisationen ihren Stand einschätzen können. Es betont außerdem, dass Continuous Delivery Risiken senkt, nicht erhöht, und dass Compliance-Anforderungen durch automatisierte, nachvollziehbare Prozesse besser erfüllt werden als durch manuelle Freigaben.
Was sich seit 2010 geändert hat
Kein Buch dieser Reihe ist so stark in der Praxis aufgegangen wie Continuous Delivery. Die Ideen sind geblieben, die Werkzeuge haben sich fast vollständig gewandelt.
| Bereich | 2010 | 2026 |
|---|---|---|
| Pipeline-Werkzeuge | Jenkins (damals Hudson), Go, CruiseControl | GitHub Actions, GitLab CI, Jenkins, Argo, Tekton |
| Pipeline-Definition | meist über Oberflächen konfiguriert | als Code im Repository, etwa YAML |
| Infrastruktur | Puppet, Chef, virtuelle Maschinen | Terraform, OpenTofu, Kubernetes, Container |
| Umgebungen | wenige, teure, langlebige Testumgebungen | kurzlebige Umgebungen pro Pull Request, Testcontainers |
| Auslieferungsstrategien | Blue-Green und Canary von Hand gebaut | in Kubernetes, Service Mesh und Cloud-Plattformen eingebaut |
| Feature Toggles | selbst gebaut | eigene Produkte, OpenFeature als Standard |
| Artefakte | WAR- und JAR-Dateien | Container-Images, signiert und mit Stückliste (SBOM) |
| Deployment | Push aus der Pipeline | zusätzlich GitOps: Zielzustand im Repository, ein Agent gleicht ab |
Neue Themen
- Sicherheit in der Lieferkette: Signierte Artefakte, Software-Stücklisten und Nachweise über die Herkunft von Builds, etwa nach SLSA, sind seit Angriffen wie SolarWinds ein eigener Teil der Pipeline.
- Testcontainers haben die Grenze zwischen Commit-Stufe und Akzeptanztests verschoben: Echte Datenbanken und Broker laufen in Sekunden in Containern, auch in Tests, die Entwickler lokal ausführen.
- Plattform-Teams stellen Pipelines als Dienst bereit, wie Team Topologies es beschreibt. Ein Produktteam baut seine Pipeline nicht mehr von Grund auf.
- Messung: Accelerate und die DORA-Berichte haben die Wirkung von Continuous Delivery mit Daten belegt und Kennzahlen dafür etabliert.
- KI in der Pipeline: Laut DORA 2025 erhöht KI-gestützte Entwicklung den Durchsatz, aber nicht automatisch die Stabilität. Eine gute Pipeline mit automatisierten Tests ist die Voraussetzung, damit mehr Code nicht mehr Fehler bedeutet.
Was gleich geblieben ist
Die Prinzipien: ein Artefakt für alle Umgebungen, schnelle Tests zuerst, alles versioniert, auf den Hauptzweig integrieren, Auslieferung von Freigabe trennen, was weh tut öfter tun. Wer das Buch heute liest, überspringt die Werkzeugbeschreibungen und findet einen Kern, der sich nicht verändert hat.
David Farley hat diesen Kern 2021 in Modern Software Engineering weiterentwickelt, mit dem Schwerpunkt auf Lernen und Komplexitätsmanagement statt auf Pipelines.
Kritik und Einordnung
Stärken
- Ein vollständiges Bild: Das Buch verbindet Versionskontrolle, Tests, Infrastruktur, Daten und Auslieferung zu einem durchgängigen Prozess. Vorher wurden diese Themen getrennt behandelt.
- Die Pipeline als Begriff: Ein Konzept, das jeder versteht und das sich in jedem Werkzeug umsetzen lässt.
- Wirkung: Kaum ein Buch hat die Praxis der Softwareentwicklung so verändert. Was es 2010 als Ziel beschrieb, ist heute in vielen Teams Normalzustand.
- Durch Daten bestätigt: Accelerate hat fast alle zentralen Empfehlungen empirisch gestützt.
- Auch für regulierte Umgebungen: Das Argument, dass Automatisierung Nachvollziehbarkeit verbessert, hat vielen Teams in Banken und Behörden geholfen.
Kritikpunkte
1. Werkzeuge veraltet. Große Teile beschreiben Werkzeuge und Techniken von 2010. Kapitel über Build-Skripte mit Ant und Maven oder Infrastruktur mit Puppet liest man heute nur noch historisch.
2. Umfangreich und teils wiederholend. Mit rund 500 Seiten ist das Buch lang; einige Prinzipien werden in mehreren Kapiteln erneut erklärt.
3. Monolithische Perspektive. Das Buch denkt meist an eine große Anwendung mit einer Pipeline. Viele Dienste mit eigenen Pipelines, Verträgen zwischen Diensten und unabhängigen Auslieferungen kommen nur am Rand vor. Dafür braucht man Newman und Richards und Ford.
4. Wenig über Organisation. Wie man eine Organisation dazu bringt, Continuous Delivery einzuführen, bleibt knapp. Das holen Accelerate, Team Topologies und The DevOps Handbook nach, an dem Humble mitgeschrieben hat.
5. Branching-Position absolut. Die Ablehnung von Feature-Branches wurde oft als dogmatisch empfunden, besonders nachdem Pull Requests auf GitHub zum Standard wurden. Die Antwort der Autoren und von DORA: Kurze Branches mit schneller Integration sind in Ordnung, lange nicht.
Gesamturteil
Continuous Delivery ist eines der einflussreichsten Bücher der Reihe, gerade weil seine Ideen so selbstverständlich geworden sind. Wer es heute liest, liest die Kapitel 1, 5 und 10 sowie die Abschnitte zu Daten und Versionskontrolle und überspringt den Rest. Für die Einordnung reicht oft auch Accelerate, das die Ergebnisse zusammenfasst und belegt.
Bezüge zur Reihe
| Thema bei Humble und Farley | Bezug in der Reihe |
|---|---|
| Kleine, häufige Auslieferungen | Accelerate: Deployment-Häufigkeit, kleine Losgrößen; Beck in Tidy First?: kleine Schritte |
| Trunk statt lange Branches | Accelerate: Trunk-Based Development als Treiber |
| Was weh tut, öfter tun | Beck: TDD in kleinen Schritten; Thomas und Hunt: Tracer Bullets |
| Commit-Stufe unter zehn Minuten | Beck: schnelle Tests; GOOS: innere Schleife |
| Akzeptanztests mit Application Driver | GOOS: äußere Schleife, Application Runner; Fowler PoEAA: Gateway |
| Architekturregeln im Build | Richards und Ford: Fitness Functions; Martin und Brown: Grenzen durchsetzen |
| Bestehende Systeme schrittweise testen | Feathers: Characterization Tests |
| Expand and Contract, Branch by Abstraction | Nygard: Auslieferung ohne Ausfallzeit; Feathers: Seams |
| Feature Toggles als Schulden | Ousterhout: Komplexität durch Sonderfälle |
| Alle sind verantwortlich | Team Topologies: Stream-aligned Teams; Accelerate: Westrum-Kultur |
| Automatisierung statt Freigabegremien | Accelerate: Change Advisory Boards ohne Nutzen |
| Infrastruktur als Code | Team Topologies: Plattform; Nygard: Control Plane |
| Qualität einbauen | McConnell: Fehler früh finden ist billiger |
Diskussionsfragen
- Auslieferbarkeit: Ist euer Hauptzweig jederzeit auslieferbar? Wenn nicht, was müsste sich ändern?
- Commit-Stufe: Wie lange dauert euer Build mit Unit-Tests? Wartet ihr darauf, oder arbeitet ihr schon am Nächsten weiter?
- Ein Artefakt: Baut ihr für jede Umgebung neu, oder läuft dasselbe Artefakt von Test bis Produktion?
- Branches: Wie lange leben eure Feature-Branches im Durchschnitt? Was hindert euch, schneller zu integrieren?
- Ausliefern und Freigeben: Trennt ihr beides, etwa mit Feature Toggles? Und räumt ihr alte Schalter auf?
- Datenbank: Wie geht ihr mit Schemaänderungen um, wenn alte und neue Version gleichzeitig laufen müssen?
- Notfälle: Gibt es bei euch Notfallkorrekturen, die an der Pipeline vorbeigehen?
- Weiter: Als Nächstes Vladimir Khorikovs Unit Testing: Principles, Practices, and Patterns, das den TDD-Faden der Reihe zusammenführt.