Building Microservices – Zusammenfassung und Einordnung
Sam Newman, Building Microservices: Designing Fine-Grained Systems (2015, 2. Auflage 2021)
Einleitung
Kein Architekturstil wurde in den letzten zehn Jahren so häufig diskutiert, so oft gewählt und so oft bereut wie Microservices. Sam Newmans Buch ist das Standardwerk dazu, und es ist bemerkenswert vorsichtig: Es erklärt, wie man Microservices gut baut, und warnt zugleich auf fast jeder Seite davor, sie ohne guten Grund einzusetzen.
Autor und Kontext
Sam Newman arbeitete wie Humble, Farley und Hohpe bei ThoughtWorks, wo um 2012 viele der Ideen entstanden, die James Lewis und Martin Fowler 2014 in ihrem Artikel Microservices zusammenfassten. Die erste Auflage erschien 2015 auf dem Höhepunkt des Hypes. 2019 folgte Monolith to Microservices über die Migration bestehender Systeme. Die zweite Auflage von 2021 ist mit rund 600 Seiten fast doppelt so umfangreich und vorsichtiger im Ton.
Die Kernthese
Microservices sind unabhängig auslieferbare Dienste, die um eine fachliche Domäne herum modelliert sind. Alles andere, Größe, Technologie, Kommunikationsart, folgt daraus. Ihr Hauptvorteil ist Unabhängigkeit: Teams können ihre Dienste ändern, ausliefern und skalieren, ohne sich mit anderen abzustimmen. Ihr Hauptnachteil ist Komplexität: Ein verteiltes System ist schwerer zu bauen, zu testen, zu betreiben und zu verstehen als ein Monolith.
Newmans Rat zieht sich durch das ganze Buch: Microservices sollten eine bewusste Entscheidung sein, nicht der Standard. Wer nicht klar sagen kann, welches Problem sie lösen, sollte beim Monolithen bleiben, idealerweise einem modularen.
Aufbau der 2. Auflage
| Teil | Kapitel | Inhalt |
|---|---|---|
| I. Grundlagen | 1–4 | was Microservices sind, wie man sie modelliert, wie man einen Monolithen aufteilt, Kommunikationsstile |
| II. Umsetzung | 5–13 | Kommunikation umsetzen, Abläufe, Build, Deployment, Tests, Beobachtbarkeit, Sicherheit, Resilienz, Skalierung |
| III. Menschen | 14–16 | Benutzeroberflächen, Organisationsstrukturen, der evolutionäre Architekt |
Die Kapitel lassen sich weitgehend unabhängig lesen. Teil I ist der wichtigste; Teil II ist ein Überblick über Themen, zu denen jeweils eigene Bücher existieren.
Was Microservices sind
Die Kernmerkmale
| Merkmal | Bedeutung |
|---|---|
| Unabhängige Auslieferbarkeit | Ein Dienst lässt sich ändern und ausliefern, ohne andere Dienste anzufassen. Für Newman das wichtigste Merkmal. |
| Fachlich geschnitten | Grenzen folgen Geschäftsfähigkeiten, nicht technischen Schichten. |
| Eigener Zustand | Jeder Dienst besitzt seine Daten; andere greifen nur über seine Schnittstelle darauf zu. Keine gemeinsame Datenbank. |
| Größe | nachrangig; ein Dienst soll so groß sein, dass ein Team ihn versteht und verantworten kann |
| Flexibilität | Technologie, Skalierung und Ausfallsicherheit lassen sich pro Dienst wählen |
Newman betont, dass Größe das am wenigsten nützliche Kriterium ist. Die Frage „wie klein?“ führt in die Irre; die richtige Frage ist „wie unabhängig?“.
Arten von Monolithen
Newman verwendet „Monolith“ nicht abwertend, sondern unterscheidet drei Formen:
| Form | Beschreibung | Bewertung |
|---|---|---|
| Einprozess-Monolith | eine Anwendung, eine Auslieferung | für viele Organisationen der richtige Ausgangspunkt |
| Modularer Monolith | eine Auslieferung, intern fachlich getrennte Module | Newmans Empfehlung für die meisten neuen Systeme |
| Verteilter Monolith | mehrere Dienste, die aber gemeinsam ausgeliefert werden müssen | das Schlechteste aus beiden Welten: Komplexität eines verteilten Systems ohne Unabhängigkeit |
Der verteilte Monolith ist das häufigste Ergebnis gescheiterter Microservices-Projekte: Dienste, die so eng gekoppelt sind, dass jede Änderung mehrere davon betrifft und alle gemeinsam ausgeliefert werden müssen. Martins Katzenproblem aus Clean Architecture ist ein Beispiel dafür.
Vorteile und Probleme
| Vorteile | Probleme |
|---|---|
| unabhängige Auslieferung und kürzere Lead Time | Entwicklererfahrung: lokale Umgebung mit vielen Diensten |
| Teamautonomie, passend zu Conway | Technologievielfalt wird schnell zur Last |
| gezielte Skalierung einzelner Teile | Kosten für Infrastruktur und Betrieb |
| Ausfälle bleiben begrenzt | Berichte und Auswertungen über verteilte Daten |
| Technologie pro Dienst wählbar | Überwachung, Fehlersuche, Tests über Dienstgrenzen |
| Datenkonsistenz ohne gemeinsame Transaktionen | |
| Latenz und Netzwerkfehler |
Wann nicht?
Newman nennt Situationen, in denen er von Microservices abrät:
- Unklare Domäne: Wer die fachlichen Grenzen noch nicht kennt, zieht sie falsch, und falsche Grenzen sind in verteilten Systemen teuer zu korrigieren.
- Startups: Das Produkt ändert sich schnell und grundlegend; Flexibilität im Code ist wichtiger als Unabhängigkeit von Teams.
- Software, die Kunden selbst betreiben: Die Betriebskomplexität landet beim Kunden.
- Fehlende Gründe: „Alle machen es“ ist kein Grund.
Einordnung
Newmans Definition deckt sich mit dem Architekturquant von Richards und Ford: Ein Microservice ist ein eigenes Quant. Die Warnung vor dem verteilten Monolithen ist dieselbe wie Fowlers erstes Gesetz der Verteilung und Martins „Services sind keine Architektur“.
Microservices modellieren
Wo zieht man die Grenzen? Newman beginnt mit drei Grundbegriffen, die in dieser Reihe vertraut sind.
- Information Hiding nach Parnas: Ein Dienst verbirgt so viel wie möglich hinter einer stabilen Schnittstelle. Was verborgen ist, kann sich ändern, ohne andere zu berühren. Ousterhouts tiefe Module auf Dienstebene.
- Kohäsion: Was sich gemeinsam ändert, gehört zusammen.
- Kopplung: Was sich gemeinsam ändern muss, obwohl es getrennt ist, ist gekoppelt.
Das Ziel ist, Kopplung zwischen Diensten zu minimieren und Kohäsion innerhalb zu maximieren, damit fachliche Änderungen in einem Dienst bleiben.
Arten der Kopplung
Newman ordnet Kopplung von locker nach eng:
| Art | Beschreibung | Beispiel |
|---|---|---|
| Fachliche Kopplung | ein Dienst nutzt Funktionen eines anderen | Bestellung ruft Lager auf, um Bestand zu reservieren; unvermeidlich und in Ordnung |
| Durchreich-Kopplung | ein Dienst reicht Daten an einen anderen weiter, nur weil ein dritter sie braucht | Bestellung übergibt Versanddaten an Lager, damit Lager sie an Versand weitergibt |
| Gemeinsame Kopplung | mehrere Dienste nutzen gemeinsame Daten, etwa eine gemeinsame Tabelle | mehrere Dienste lesen und schreiben dieselbe Bestelltabelle |
| Inhaltskopplung | ein Dienst greift direkt in den internen Zustand eines anderen | ein Dienst ändert Statuswerte direkt in der Datenbank eines anderen, an dessen Logik vorbei |
Durchreich-Kopplung ist ein subtiles Problem: Der mittlere Dienst muss sich ändern, wenn sich das Format zwischen den äußeren ändert, obwohl er die Daten gar nicht nutzt. Newmans Lösungen: Der erste Dienst spricht direkt mit dem dritten, oder der mittlere Dienst behandelt die Daten als undurchsichtigen Block. Das ist Ousterhouts Pass-Through-Variable auf Dienstebene.
Domain-Driven Design als Werkzeug
Newmans wichtigstes Werkzeug für Grenzen ist DDD, wie Evans es beschreibt:
- Ubiquitous Language: Dienste und Schnittstellen verwenden die Sprache der Fachleute.
- Aggregate sind gute Kandidaten für die Einheiten, die ein Dienst besitzt. Ein Aggregat gehört genau einem Dienst.
- Bounded Contexts sind gute Kandidaten für Dienstgrenzen. Ein Kontext kann anfangs ein Dienst sein und später in mehrere zerfallen.
- Event Storming hilft, Kontexte und Aggregate gemeinsam mit Fachleuten zu entdecken.
Newman empfiehlt, grob anzufangen: lieber wenige, größere Dienste entlang von Bounded Contexts, die man später teilt, als viele kleine, die man später zusammenlegen muss. Zusammenlegen ist in verteilten Systemen schwerer als Teilen.
Andere Kriterien
Fachliche Grenzen sind der Ausgangspunkt, aber nicht die einzigen Kriterien:
| Kriterium | Beispiel |
|---|---|
| Änderungshäufigkeit | was sich oft ändert, wird abgetrennt, damit der Rest stabil bleibt |
| Daten | personenbezogene oder Zahlungsdaten werden in einem eigenen Dienst isoliert, um den Bereich mit strengen Auflagen klein zu halten |
| Technologie | ein Teil braucht eine andere Laufzeit oder Datenbank |
| Organisation | Grenzen folgen Teams, etwa bei verteilten Standorten |
Einordnung
Die Kopplungsarten sind eine Vergröberung dessen, was Richards und Ford als Konnaszenz beschreiben, auf Dienstebene. Newmans Rat, grob zu beginnen, ist Richards‘ und Fords Empfehlung der service-basierten Architektur als Mittelweg.
Den Monolithen aufteilen
Die meisten Teams beginnen nicht mit Microservices, sondern mit einem bestehenden Monolithen. Newman behandelt die Migration in einem eigenen Kapitel und ausführlich in seinem Buch Monolith to Microservices.
Grundsätze
- Ein klares Ziel haben: Was soll besser werden? Schnellere Auslieferung, Skalierung, Teamautonomie? Ohne Ziel lässt sich nicht messen, ob die Migration gelingt.
- Schrittweise vorgehen: Kein großer Neuschrieb. Einen Dienst herauslösen, in Produktion bringen, lernen, dann den nächsten.
- Der Monolith ist selten das Problem: Oft lassen sich Ziele auch durch einen besser strukturierten Monolithen erreichen.
- Mit dem Einfachsten beginnen: einem Teil, der wenig Abhängigkeiten hat und dessen Herauslösung schnell Nutzen bringt.
Strangler Fig
Das wichtigste Migrationsmuster, benannt von Martin Fowler nach der Würgefeige, die einen Baum langsam umwächst, bis sie ihn ersetzt:
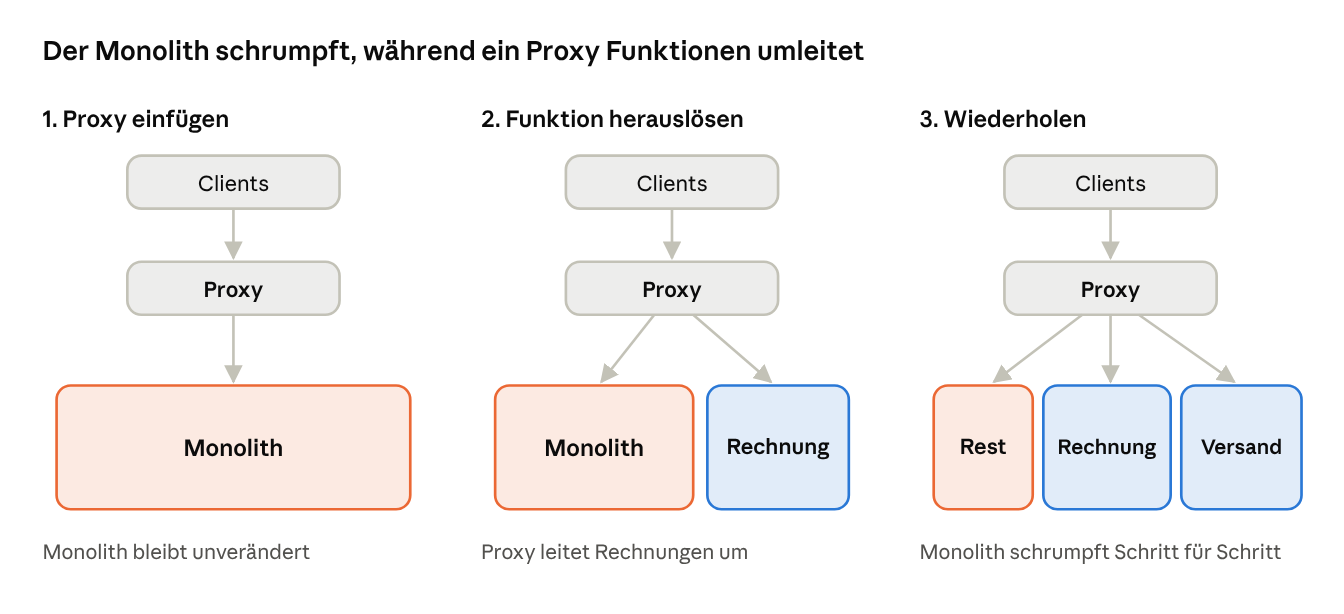
Strangler Fig · ein Proxy leitet Aufrufe schrittweise vom Monolithen zu neuen Diensten um
Ein Proxy vor dem Monolithen fängt Aufrufe ab. Zunächst leitet er alles weiter. Dann wird eine Funktion als neuer Dienst gebaut, und der Proxy leitet nur deren Aufrufe dorthin um. Schritt für Schritt wächst der Anteil der neuen Dienste, bis der Monolith verschwindet oder als kleiner Rest bleibt. Jeder Schritt ist klein und lässt sich zurücknehmen, indem man den Proxy zurückstellt.
Weitere Migrationsmuster
| Muster | Inhalt |
|---|---|
| Parallel Run | alte und neue Implementierung laufen gleichzeitig, die Ergebnisse werden verglichen; nur die alte ist maßgeblich |
| Feature Toggle | zwischen alter und neuer Implementierung umschalten |
| Branch by Abstraction | im Monolithen eine Abstraktion einziehen, dahinter auf den neuen Dienst umstellen, wie in Continuous Delivery beschrieben |
| Decorating Collaborator | ein Proxy ruft den Monolithen auf und löst zusätzlich einen neuen Dienst aus, ohne den Monolithen zu ändern |
| Change Data Capture | ein neuer Dienst reagiert auf Änderungen in der Datenbank des Monolithen |
Die Daten
Der schwierigste Teil ist fast immer die Datenbank. Newman beschreibt Wege, eine gemeinsame Datenbank schrittweise aufzuteilen:
- Erst den Code, dann die Daten, oder umgekehrt: Beides ist möglich, aber nicht beides gleichzeitig.
- Database View: Der Monolith sieht eine Sicht auf Daten, die einem neuen Dienst gehören.
- Database Wrapping Service: Ein Dienst kapselt einen Teil der Datenbank, und alle Zugriffe laufen über ihn.
- Tabellen aufteilen: Eine Tabelle, die mehrere fachliche Bereiche vermischt, wird nach Bereichen getrennt.
Mit dem Aufteilen der Daten gehen Transaktionen über mehrere Bereiche verloren. Das führt zu den Sagas im übernächsten Abschnitt.
Einordnung
Strangler Fig ist Feathers‘ Sprout und Wrap auf Systemebene, und Parallel Run ist Feathers‘ Characterization Test im Betrieb. Die Warnung vor dem großen Neuschrieb ist Brooks‘ Zweitsystemeffekt.
Kommunikation
Stile
Newman unterscheidet zwei Achsen: synchron blockierend oder asynchron nicht blockierend, und das Muster der Zusammenarbeit.
| Muster | Beschreibung | Eignung |
|---|---|---|
| Anfrage–Antwort, synchron | Aufrufer wartet auf die Antwort | einfach, vertraut; zeitliche Kopplung, Kaskadenausfälle |
| Anfrage–Antwort, asynchron | Antwort kommt später über einen anderen Kanal | entkoppelt, aber Korrelation nötig, wie EIP beschreibt |
| Ereignisgesteuert | ein Dienst veröffentlicht, was passiert ist; andere reagieren | sehr lose Kopplung, schwer nachzuvollziehen |
| Gemeinsame Daten | Dienste tauschen Daten über einen gemeinsamen Speicher aus, etwa Dateien oder einen Data Lake | für große Datenmengen und Batch-Verarbeitung |
Seine Faustregel: Ereignisgesteuerte Kommunikation koppelt am lockersten, aber Anfrage–Antwort ist oft klarer. Er rät, bewusst zu wählen statt eine Art zur Pflicht zu machen.
Technologie
REST über HTTP, gRPC, GraphQL und Message Broker werden kurz verglichen. Newmans wichtigere Botschaft ist, dass die Technologie weniger zählt als die Frage, wie man Schnittstellen ändert, ohne Aufrufer zu brechen.
Schnittstellen weiterentwickeln
| Regel | Inhalt |
|---|---|
| Nur erweitern | neue Felder und Endpunkte hinzufügen statt bestehende zu ändern oder zu entfernen |
| Tolerant Reader | Empfänger ignorieren unbekannte Felder und lesen nur, was sie brauchen; Postels Gesetz |
| Explizite Schemas | Schnittstellen werden in OpenAPI, Protobuf, Avro oder JSON Schema beschrieben |
| Brüche früh erkennen | Schema-Kompatibilität in der Pipeline prüfen; verbraucherorientierte Verträge, siehe Tests |
| Inkompatible Versionen nebeneinander | alte und neue Version eines Endpunkts parallel anbieten, bis alle Aufrufer umgestellt sind |
| Kein Gleichschritt | wer mehrere Dienste gemeinsam ausliefern muss, hat einen verteilten Monolithen |
// Tolerant Reader: unbekannte Felder ignorieren, nur Benötigtes lesen
@JsonIgnoreProperties(ignoreUnknown = true)
record CustomerView(String id, String name, String email) {}

// Erweiterung statt Änderung: neues Feld optional, altes bleibt
record CustomerResponse(
    String id,
    String name,
    String email,
    @JsonInclude(NON_NULL) String preferredLanguage   // neu, Aufrufer ohne Kenntnis bleiben intakt
) {}
Gemeinsamer Code
Newman warnt vor gemeinsamen Bibliotheken mit fachlicher Logik zwischen Diensten: Sie koppeln die Dienste, weil jede Änderung an der Bibliothek alle betrifft und Versionen auseinanderlaufen. Gemeinsame Bibliotheken für technische Belange, etwa Logging oder Metriken, sind in Ordnung. Das ist die Abwägung zwischen Duplikation und Kopplung, die Richards und Ford im Kapitel über Wiederverwendung beschreiben.
Infrastruktur
- Service Discovery: Dienste finden einander über ein Verzeichnis oder DNS, heute meist durch Kubernetes.
- API Gateway: ein Einstiegspunkt für externe Aufrufer, mit Authentifizierung, Ratenbegrenzung und Routing. Newman warnt davor, Fachlogik dort abzulegen.
- Service Mesh: ein Netzwerk aus Proxys neben jedem Dienst, das Verschlüsselung, Wiederholungen, Timeouts und Tracing übernimmt, ohne dass der Code das kennt. EIPs Smart Proxy und Nygards Stabilitätsmuster als Infrastruktur.
Abläufe über mehrere Dienste
In einem Monolithen mit einer Datenbank erledigt eine Transaktion, was über mehrere Tabellen konsistent sein muss. Mit Microservices und getrennten Datenbanken geht das nicht mehr.
Keine verteilten Transaktionen
Newman rät deutlich von Zwei-Phasen-Commit über Dienste hinweg ab: Es sperrt Ressourcen über Netzwerkaufrufe hinweg, ein ausfallender Koordinator blockiert alle Beteiligten, und es koppelt die Dienste zeitlich. Seine Empfehlung: Wenn etwas wirklich atomar sein muss, gehört es in einen Dienst. Wenn nicht, nutzt man Sagas.
Sagas
Eine Saga ist eine Folge lokaler Transaktionen, jede in einem Dienst. Schlägt ein Schritt fehl, werden die bereits ausgeführten Schritte durch Ausgleichsaktionen zurückgenommen. Der Begriff stammt aus einem Datenbankartikel von Garcia-Molina und Salem von 1987; Hohpes Starbucks-Text beschreibt dieselbe Idee anschaulich.
Wichtige Eigenschaften:
- Ausgleich ist keine Rücknahme: Eine verschickte E-Mail lässt sich nicht zurückholen; man schickt eine zweite mit einer Korrektur. Ausgleichsaktionen sind fachliche Vorgänge.
- Rückwärts oder vorwärts: Manche Fehler werden durch Ausgleich behoben, andere durch erneutes Versuchen, bis es klappt.
- Reihenfolge klug wählen: Schritte, die am ehesten scheitern, kommen zuerst, damit möglichst wenig ausgeglichen werden muss.
- Zwischenzustände sind sichtbar: Andere sehen eine Bestellung, deren Zahlung noch aussteht. Das muss fachlich modelliert werden.
Orchestriert oder choreografiert
| Orchestriert | Choreografiert | |
|---|---|---|
| Steuerung | ein Koordinator ruft die Schritte nacheinander auf | jeder Dienst reagiert auf Ereignisse und veröffentlicht eigene |
| Sichtbarkeit | Ablauf an einer Stelle lesbar | Ablauf verteilt, braucht Korrelations-IDs und Tracing |
| Kopplung | Koordinator kennt alle Beteiligten | Dienste kennen nur Ereignisse |
| Risiko | Logik sammelt sich im Koordinator, die anderen Dienste werden anämisch | niemand überblickt den Gesamtablauf |
Newman neigt zur Choreografie, vor allem wenn verschiedene Teams die Dienste besitzen, räumt aber ein, dass Orchestrierung für komplexe Abläufe oft verständlicher ist. Workflow-Engines wie Temporal oder Camunda haben die orchestrierte Variante seit der zweiten Auflage deutlich einfacher gemacht.
// Orchestrierte Saga, vereinfacht
class PlaceOrderSaga {
    OrderResult run(PlaceOrder cmd) {
        var reservation = inventory.reserve(cmd.items());             // Schritt 1
        try {
            var payment = payments.charge(cmd.customerId(), cmd.total()); // Schritt 2
            try {
                shipping.schedule(cmd.orderId(), cmd.address());         // Schritt 3
                return OrderResult.confirmed(cmd.orderId());
            } catch (ShippingFailed e) {
                payments.refund(payment.id());                            // Ausgleich 2
                throw e;
            }
        } catch (PaymentDeclined | ShippingFailed e) {
            inventory.release(reservation.id());                          // Ausgleich 1
            return OrderResult.rejected(cmd.orderId(), e.getMessage());
        }
    }
}
In der Praxis müssen solche Abläufe Abstürze überstehen: Der Zustand der Saga wird gespeichert, und jeder Schritt ist idempotent, wie EIPs Idempotent Receiver.
Einordnung
Evans‘ Aggregate als Konsistenzgrenzen, Fowlers Unit of Work und Kleppmanns Transaktionskapitel beschreiben, was innerhalb eines Dienstes gilt. Sagas sind die Antwort für alles darüber hinaus. Richards und Ford behandeln dieselbe Abwägung als Orchestrierung gegen Choreografie.
Build
Jeder Dienst hat eine eigene Pipeline, die ihn unabhängig baut, testet und ausliefert. Das ist die technische Voraussetzung für unabhängige Auslieferbarkeit und setzt Continuous Delivery voraus.
Zur Frage ein Repository pro Dienst oder ein Monorepo gibt Newman keine eindeutige Antwort:
| Ein Repository pro Dienst | Monorepo | |
|---|---|---|
| Stärke | klare Besitzverhältnisse, unabhängige Pipelines | Änderungen über Dienste hinweg in einem Commit, gemeinsame Werkzeuge |
| Risiko | Änderungen über mehrere Dienste sind umständlich | Dienste koppeln sich leichter, Builds werden groß, Besitz verschwimmt |
Deployment
Grundsätze
- Isolierte Ausführung: Jeder Dienst läuft in einer eigenen Umgebung, damit er andere nicht beeinflusst.
- Automatisierung: Bei vielen Diensten ist manuelle Arbeit nicht mehr möglich.
- Infrastructure as Code.
- Auslieferung ohne Ausfallzeit.
- Gewünschten Zustand beschreiben: Man beschreibt, was laufen soll, und eine Plattform sorgt dafür, wie bei Kubernetes.
Optionen
Newman vergleicht physische Maschinen, virtuelle Maschinen, Container, Platform as a Service und Functions as a Service. Seine Empfehlungen in etwa: Wenn etwas funktioniert, nicht ohne Grund ändern; wenn möglich eine verwaltete Plattform nutzen, die einem den Betrieb abnimmt; Kubernetes erst, wenn man viele Dienste hat und die Kompetenz, es zu betreiben, oder einen verwalteten Kubernetes-Dienst nutzt. Er warnt davor, Kubernetes als Selbstzweck einzuführen.
Progressive Delivery
Auslieferung und Freigabe werden getrennt, wie in Continuous Delivery: Canary Releases, Feature Toggles, Parallel Runs. Neu ist der Fokus auf automatische Auswertung: Eine Canary-Version wird anhand von Metriken automatisch befördert oder zurückgenommen.
Tests
Das Problem mit End-to-End-Tests
In einem System mit vielen Diensten werden End-to-End-Tests über alle Dienste zum Problem:
- Sie sind langsam und flackern, weil viele bewegliche Teile beteiligt sind.
- Niemand fühlt sich zuständig, wenn sie fehlschlagen.
- Sie erzwingen eine gemeinsame Version aller Dienste, die getestet wurde, und damit faktisch Gleichschritt.
Newman empfiehlt, End-to-End-Tests auf wenige kritische Abläufe zu beschränken und stattdessen auf Verträge und Tests in Produktion zu setzen.
Verbraucherorientierte Verträge
Der wichtigste Testansatz für Microservices: Der Verbraucher einer Schnittstelle beschreibt in einem Vertrag, welche Anfragen er sendet und welche Antworten er erwartet. Der Anbieter prüft in seiner Pipeline, ob er alle Verträge seiner Verbraucher erfüllt. So erfährt ein Team vor der Auslieferung, ob es einen anderen Dienst bricht, ohne dass beide gemeinsam laufen müssen.
// Verbraucherseite mit Pact: beschreibt die Erwartung an den Kundendienst
@Pact(consumer = "order-service", provider = "customer-service")
V4Pact customerExists(PactDslWithProvider builder) {
    return builder
        .given("customer 42 exists")
        .uponReceiving("a request for customer 42")
            .path("/customers/42").method("GET")
        .willRespondWith()
            .status(200)
            .body(new PactDslJsonBody().stringType("id", "42").stringType("name"))
        .toPact(V4Pact.class);
}

// Anbieterseite: prüft den Vertrag gegen die echte Implementierung
@Provider("customer-service") @PactBroker
class CustomerProviderPactTest {
    @TestTemplate @ExtendWith(PactVerificationInvocationContextProvider.class)
    void verify(PactVerificationContext ctx) { ctx.verifyInteraction(); }

    @State("customer 42 exists") void customer42() { repository.save(new Customer("42", "Sven")); }
}
Das ist Khorikovs Regel, Kommunikation zwischen Systemen als beobachtbares Verhalten zu prüfen, mit einem Werkzeug, das beide Seiten verbindet.
Tests in Produktion
Newman nimmt das Testen in Produktion ernst: synthetische Transaktionen, die ständig echte Abläufe ausführen, Canary-Auswertungen, A/B-Tests und Chaos Engineering. Kein Testsystem bildet die Produktion vollständig nach; gute Beobachtbarkeit ist deshalb Teil der Teststrategie.
Von Monitoring zu Beobachtbarkeit
In einem Monolithen schaut man in eine Logdatei. Bei zwanzig Diensten auf hundert Containern geht das nicht mehr. Newman unterscheidet Monitoring, also das Überwachen bekannter Fehlerbilder, von Beobachtbarkeit, der Fähigkeit, auch unbekannte Probleme aus den Daten heraus zu verstehen.
| Baustein | Inhalt |
|---|---|
| Zentrale Logs | alle Logs an einem Ort, mit einheitlichem Format |
| Korrelations-IDs | jede Anfrage trägt eine ID durch alle Dienste; EIPs Message History |
| Metriken | Antwortzeiten, Fehlerraten, Auslastung pro Dienst |
| Verteiltes Tracing | der Weg einer Anfrage durch alle Dienste mit Zeiten pro Abschnitt; heute meist OpenTelemetry |
| Service Level Objectives | messbare Ziele für Verfügbarkeit und Antwortzeit, an denen sich Alarme orientieren |
| Alarme mit Bedacht | nur alarmieren, wenn ein Mensch handeln muss; Alarmmüdigkeit vermeiden |
SLOs und Fehlerbudgets führen direkt zum Site-Reliability-Engineering-Buch, das als Nächstes auf der Liste steht.
Sicherheit
Mehr Dienste bedeuten mehr Angriffsfläche und mehr Netzwerkverkehr. Newmans Grundsätze:
- Geringste Rechte: Jeder Dienst erhält nur die Zugriffe, die er braucht.
- Verteidigung in der Tiefe: mehrere Schutzschichten statt einer Grenze.
- Zero Trust statt impliziten Vertrauens: Auch Aufrufe innerhalb des eigenen Netzes werden authentifiziert und verschlüsselt, etwa mit gegenseitigem TLS.
- Geheimnisse verwalten: Schlüssel und Passwörter gehören in einen Tresor, werden regelmäßig getauscht und nie im Code abgelegt.
- Nutzeridentität weitergeben: etwa mit JSON Web Tokens, damit nachgelagerte Dienste wissen, in wessen Auftrag sie handeln.
- Automatisierte Prüfungen von Abhängigkeiten und Container-Images in der Pipeline.
Resilienz
Das Kapitel greift Nygards Stabilitätsmuster aus Release It! auf und überträgt sie auf Microservices: Timeouts für jeden Aufruf, Wiederholungen mit Bedacht und nur für idempotente Operationen, Bulkheads, Circuit Breaker, Isolation durch asynchrone Kommunikation und Idempotenz.
Newman betont, dass Resilienz nicht nur Technik ist, sondern auch die Fähigkeit einer Organisation, aus Ausfällen zu lernen. Er verweist auf David Woods‘ Unterscheidung von Robustheit, Erholung, angemessener Ausdehnung und anhaltender Anpassungsfähigkeit. Außerdem behandelt er das CAP-Theorem: Bei einer Netzwerkpartition muss man zwischen Konsistenz und Verfügbarkeit wählen, wie Kleppmann ausführlicher darstellt.
Skalierung
Newman nennt vier Achsen:
| Achse | Inhalt |
|---|---|
| Vertikal | größere Maschinen; einfach, aber begrenzt |
| Horizontal duplizieren | mehr Instanzen hinter einem Lastverteiler |
| Daten partitionieren | Daten nach einem Schlüssel aufteilen, wie Kleppmanns Sharding |
| Funktional zerlegen | Teile des Systems in eigene Dienste auslagern und getrennt skalieren |
Dazu kommen Caching auf verschiedenen Ebenen und automatische Skalierung. Seine Warnung: Funktionale Zerlegung ist die teuerste Achse. Wer nur skalieren will, sollte zuerst die einfacheren versuchen. Microservices sind selten die beste Antwort auf ein reines Leistungsproblem.
Benutzeroberflächen
Viele Microservices-Projekte zerlegen das Backend in fachliche Dienste und lassen eine monolithische Oberfläche übrig, an der alle Teams gemeinsam arbeiten. Damit verschiebt sich der Engpass nur. Newman beschreibt Alternativen:
| Muster | Inhalt |
|---|---|
| Seitenbasierte Zerlegung | verschiedene Seiten einer Anwendung gehören verschiedenen Teams |
| Widget-basierte Zerlegung | Teile einer Seite werden von verschiedenen Teams geliefert |
| Micro Frontends | eigenständig ausgelieferte Teile der Oberfläche, die im Browser zusammengesetzt werden |
| Backend for Frontend | ein eigenes, schmales Backend pro Oberflächentyp, etwa für Web und Mobil, das Daten mehrerer Dienste passend zusammenstellt |
| GraphQL | Oberflächen fragen genau die Daten ab, die sie brauchen, über eine Schnittstelle, die mehrere Dienste zusammenführt |
Sein Ziel: Ein Stream-aligned Team soll eine fachliche Funktion von der Oberfläche bis zur Datenbank liefern können, ohne auf andere Teams zu warten.
Organisationsstrukturen
Das Kapitel verbindet Microservices ausdrücklich mit Conways Gesetz und Team Topologies:
- Dienste sollen einem Team gehören. Starkes Eigentum ist der Normalfall; gemeinsames Eigentum funktioniert nur in kleinen, eng zusammenarbeitenden Teams.
- Stream-aligned Teams besitzen Dienste entlang fachlicher Ströme.
- Plattform-Teams bieten einen gepflasterten Weg, englisch Paved Road: Werkzeuge, Vorlagen und Infrastruktur, die den richtigen Weg zum einfachsten machen, ohne ihn zu erzwingen.
- Enabling Teams helfen anderen Teams, neue Fähigkeiten aufzubauen.
- Newman warnt vor Teams, die nur Dienste pflegen, ohne Verantwortung für fachliche Ergebnisse, und vor geteilten Diensten, die keinem Team gehören.
Der evolutionäre Architekt
Das letzte Kapitel beschreibt die Rolle des Architekten in einem System aus vielen Diensten. Newman vergleicht sie mit einem Stadtplaner: Er legt Zonen fest, sorgt für Infrastruktur und Regeln zwischen den Zonen, überlässt aber die Gestaltung innerhalb jeder Zone denen, die dort leben.
- Zwischen den Diensten wird gesteuert: Kommunikation, Schnittstellenstandards, Beobachtbarkeit, Sicherheit.
- Innerhalb der Dienste entscheiden die Teams.
- Prinzipien und Praktiken werden ausdrücklich formuliert und mit Beispielen und Vorlagen unterstützt.
- Ausnahmen werden bewusst zugelassen und dokumentiert; wenn sie häufig werden, ändert man die Regel.
- Technische Schulden werden sichtbar gemacht und gemeinsam mit den Teams abgebaut.
Einordnung
Das ist Richards‘ und Fords wirksamer Architekt, der Grenzen setzt statt alles zu bestimmen, und Brooks‘ Unterscheidung von Architektur und Implementierung auf Dienstebene. Das Bild der gepflasterten Straße ist Team Topologies‘ Thinnest Viable Platform.
Kritik und Einordnung
Stärken
- Ehrlich: Newman erklärt nicht nur, wie man Microservices baut, sondern auch, wann man es lassen sollte. Für ein Buch mit diesem Titel ist das ungewöhnlich.
- Unabhängige Auslieferbarkeit als Kern: Eine klare Definition, an der sich Entscheidungen messen lassen, statt Größe oder Technologie.
- Breiter Überblick: Modellierung, Migration, Kommunikation, Daten, Tests, Betrieb, Sicherheit und Organisation in einem Buch.
- Migration ernst genommen: Strangler Fig, Parallel Run und Datenaufteilung sind für die meisten Teams relevanter als Neubauten.
- Menschen und Organisation: Die Verbindung zu Conway und Team Topologies ist durchgehend.
Kritikpunkte
1. Breite statt Tiefe. Viele Kapitel, etwa zu Sicherheit, Deployment oder Beobachtbarkeit, sind Überblicke über Themen mit eigenen Büchern. Wer tiefer will, braucht Nygard, Kleppmann oder das SRE-Buch.
2. Wenig Code. Das Buch zeigt Architektur und Abwägungen, kaum Implementierung. Für Java-Entwickler bleibt die Übertragung auf Spring Boot, Kafka oder Kubernetes eigene Arbeit.
3. Großorganisationen als Maßstab. Viele Beispiele setzen mehrere Teams und eine gewisse Größe voraus. Für ein einzelnes Team gilt fast immer: modularer Monolith.
4. Werkzeuge altern schnell. Die Kapitel über Deployment und Infrastruktur sind bereits wenige Jahre nach Erscheinen in Teilen überholt.
5. Der Pendelschlag. Seit etwa 2022 kehren viele Unternehmen von Microservices zu größeren Diensten oder Monolithen zurück, prominent etwa ein Team bei Amazon Prime Video, das 2023 öffentlich über eine Rückkehr zu einem Monolithen berichtete. Newmans Buch hat das in gewisser Weise vorweggenommen; es wird aber oft als Rechtfertigung für Microservices gelesen statt als Abwägung.
Gesamturteil
Das beste Buch über Microservices ist zugleich eines der besten Argumente, sie nur bewusst einzusetzen. Wer verteilte Systeme baut, findet hier die Landkarte; für die Details braucht man Kleppmann für Daten, EIP für Messaging, Nygard für Stabilität und Software Architecture: The Hard Parts für die schwierigen Abwägungen bei Daten und Verträgen.
Bezüge zur Reihe
Kein Buch der Reihe greift so viele andere auf wie Newmans. Es ist in gewisser Weise eine Synthese.
| Thema bei Newman | Bezug in der Reihe |
|---|---|
| Unabhängige Auslieferbarkeit | Accelerate: lose gekoppelte Architektur; Richards und Ford: Architekturquant |
| Fachliche Grenzen, Aggregate, Bounded Contexts | Evans; Martin: schreiende Architektur |
| Information Hiding | Ousterhout: tiefe Module; Parnas |
| Kopplungsarten | Richards und Ford: Konnaszenz; Beck: Kopplung relativ zur Änderung |
| Verteilter Monolith | Martin: Katzenproblem; Fowler: erstes Gesetz der Verteilung |
| Modularer Monolith als Standard | Richards und Ford: neuer Stil; Martin: Services sind keine Architektur |
| Strangler Fig, Parallel Run | Feathers: Sprout und Wrap, Characterization Tests |
| Gemeinsame Datenbank vermeiden | Hohpe und Woolf: Integrationsstile; Kleppmann |
| Sagas | Richards und Ford: Orchestrierung und Choreografie; Hohpe: Starbucks |
| Tolerant Reader, Schemas | Hohpe und Woolf: Format Indicator; Kleppmann: Schema-Evolution |
| Verbraucherorientierte Verträge | Khorikov: Kommunikation zwischen Systemen prüfen |
| Pipeline pro Dienst | Humble und Farley |
| Stabilitätsmuster | Nygard |
| Teams, Plattform, Paved Road | Team Topologies; Conway; Brooks |
| Architekt als Stadtplaner | Richards und Ford: wirksamer Architekt |
Diskussionsfragen
- Bewusste Entscheidung: Wenn ihr Microservices habt, welches Problem sollten sie lösen? Haben sie es gelöst?
- Verteilter Monolith: Gibt es bei euch Dienste, die immer gemeinsam ausgeliefert werden müssen? Was koppelt sie?
- Größe: Wie groß sind eure Dienste, gemessen an Teams statt an Codezeilen?
- Daten: Teilen sich Dienste bei euch eine Datenbank oder Tabellen? Was hindert euch, das zu ändern?
- Sagas: Wie behandelt ihr Abläufe über mehrere Dienste? Gibt es Ausgleichsaktionen, und sind sie getestet?
- End-to-End-Tests: Habt ihr eine gemeinsame End-to-End-Suite über alle Dienste? Wie stabil ist sie?
- Monolith zurück: Würdest du heute in deinem Umfeld eher Dienste zusammenlegen als weiter aufteilen?
- Weiter: Als Nächstes Software Architecture: The Hard Parts, das genau die schwierigen Fragen zu Daten und Verträgen vertieft.