Building Applications with AI Agents – Zusammenfassung und Einordnung
Michael Albada, Building Applications with AI Agents: Designing and Implementing Multiagent Systems (2025)
Einleitung
Agenten kommen in der KI-Reihe bisher als Kapitel vor: bei Russell und Norvig als theoretischer Rahmen, bei Huyen als Muster mit Risiken, bei Walls als Ausblick. Michael Albada widmet ihnen ein ganzes Buch und behandelt sie als das, was sie in der Praxis sind: verteilte Softwaresysteme mit einem unberechenbaren Bauteil in der Mitte.
Autor und Kontext
Michael Albada ist Machine-Learning-Ingenieur mit Stationen bei Uber, ServiceNow und Microsoft, wo er an Agenten für Cybersicherheit gearbeitet hat, etwa für die Untersuchung von Vorfällen und die Suche nach Schwachstellen. Das Buch erschien im Herbst 2025 bei O’Reilly. Im Vorwort schreibt er, dass er das Buch geschrieben hat, das er seinen Kollegen geben wollte und nicht fand; in einem Interview nennt er Huyens Designing Machine Learning Systems als Vorbild.
Die Kernthese
Agenten verbinden Sprachmodelle mit Werkzeugen, Wissen, Gedächtnis und Orchestrierung, um mehrdeutige, mehrschrittige Aufgaben zu lösen. Das eröffnet neue Möglichkeiten, bringt aber neue Schwierigkeiten: Die Modelle sind wahrscheinlichkeitsbasiert, Fehler pflanzen sich über Schritte fort, und Messung, Überwachung und Absicherung sind schwerer als bei gewöhnlicher Software. Albada plädiert deshalb für einen nüchternen, iterativen Ansatz: so wenig Autonomie wie nötig, so viel Messung wie möglich.
Aufbau
| Kapitel | Thema |
|---|---|
| 1–2 | Einführung in Agenten; Agentensysteme entwerfen |
| 3 | Nutzererfahrung für Agenten |
| 4–5 | Werkzeuge; Orchestrierung |
| 6–7 | Wissen und Gedächtnis; Lernen |
| 8 | Von einem Agenten zu vielen |
| 9–11 | Validierung und Messung; Überwachung im Betrieb; Verbesserungsschleifen |
| 12–13 | Schutz von Agentensystemen; Zusammenarbeit von Mensch und Agent |
Rund 350 Seiten. Die Beispiele nutzen Python, vor allem LangChain und LangGraph; die Konzepte sind aber werkzeugunabhängig. Die Java-Beispiele in dieser Zusammenfassung übertragen sie auf Spring AI.
Agenten verstehen und entwerfen
Was ein Agent ist
Albada unterscheidet echte Agenten, die selbstständig entscheiden, Kontext deuten und ihr Vorgehen anpassen, von Systemen, die nur so heißen, aber feste Skripte abarbeiten. Er betont, dass viele Teams aus gutem Grund mit einfacheren Ansätzen beginnen:
| Ansatz | Wer bestimmt den Ablauf? | Wann sinnvoll |
|---|---|---|
| Workflow | der Entwickler; das Modell übernimmt einzelne Schritte | Abläufe sind bekannt und stabil |
| Agent | das Modell, innerhalb gesetzter Grenzen | Aufgaben sind mehrdeutig, Wege nicht vorhersehbar |
Bausteine
| Baustein | Aufgabe |
|---|---|
| Modell | Schlussfolgern, Planen, Sprache; groß und teuer oder klein und schnell |
| Werkzeuge | Informationen holen, Aktionen ausführen |
| Gedächtnis | kurzfristig für das laufende Gespräch, langfristig über Sitzungen hinweg |
| Orchestrierung | Ablauf steuern: welcher Schritt, welches Werkzeug, wann ist die Aufgabe erledigt |
Abwägungen
Wie bei jedem System stehen Ziele gegeneinander: Geschwindigkeit gegen Genauigkeit, Skalierbarkeit, Zuverlässigkeit, Kosten. Ein Agent, der für eine Antwort zehn Modellaufrufe braucht, ist gründlicher, aber langsamer und teurer als einer mit zwei. Albada rät, diese Abwägungen ausdrücklich zu treffen und mit Messungen zu begründen.
Vorgehen
Seine Empfehlungen für das Vorgehen sind vertraut: iterativ entwerfen, von Anfang an eine Bewertungsstrategie haben und früh unter realen Bedingungen testen. Er beschreibt außerdem, wie Teams sich organisieren sollten: Fachleute, Entwickler und Verantwortliche für Bewertung arbeiten eng zusammen, statt Agenten als reines Technikprojekt zu behandeln.
Einordnung
Die Bausteine entsprechen dem Agentenmodell von Russell und Norvig: Sensoren und Aktoren sind die Werkzeuge, das Agentenprogramm ist Modell plus Orchestrierung. Die Abwägungen sind Richards‘ und Fords Architekturmerkmale für Agenten. Und der Rat, mit Workflows zu beginnen, ist Gérons und Huyens „erst das Einfache“ in neuer Form.
Nutzererfahrung und Autonomie
Ein eigenes Kapitel zur Nutzererfahrung ist in technischen Büchern selten. Albada begründet es damit, dass Agenten nur so wertvoll sind, wie Menschen ihnen vertrauen und mit ihnen zusammenarbeiten können.
Der Autonomie-Regler
Das zentrale Bild des Kapitels ist ein Regler, mit dem man festlegt, wie viel ein Agent allein entscheiden darf. Er kann für verschiedene Aktionen unterschiedlich stehen.
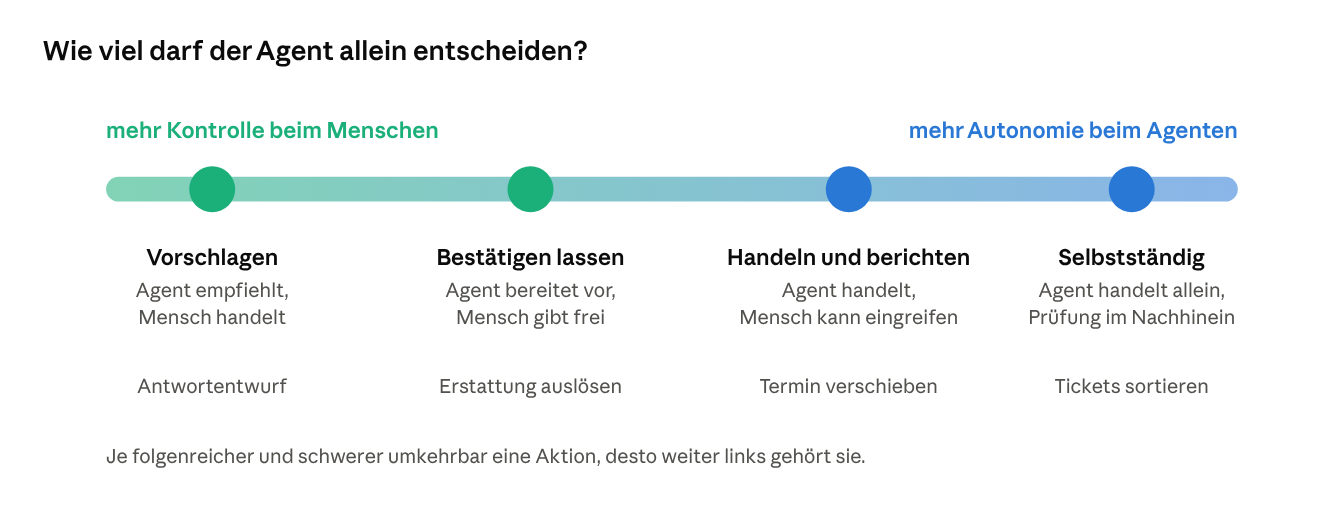
schematische Stufen des Autonomie-Reglers mit Beispielen aus dem Kundenservice
Synchron oder asynchron
| Art | Beispiel | Gestaltungsregeln |
|---|---|---|
| Synchron | Chat, bei dem der Nutzer wartet | schnelle erste Reaktion, Zwischenstände zeigen, Abbruch ermöglichen |
| Asynchron | Agent recherchiert im Hintergrund und meldet sich | klare Benachrichtigung, Ergebnis nachvollziehbar, nicht zu oft stören |
Ein Agent, der proaktiv Hinweise gibt, wird schnell aufdringlich; Albada empfiehlt, Proaktivität vorsichtig einzusetzen und abschaltbar zu machen.
Vertrauen gestalten
| Prinzip | Bedeutung |
|---|---|
| Fähigkeiten erklären | Was kann der Agent, was nicht? |
| Unsicherheit zeigen | Wie sicher ist er sich bei einer Antwort? |
| Nachfragen | bei Mehrdeutigkeit lieber fragen als raten |
| Würdig scheitern | Fehler offen benennen, einen Ausweg anbieten |
| Kontext behalten | sich an Vorlieben und frühere Gespräche erinnern, wo das erwünscht ist |
Einordnung
Der Autonomie-Regler ist Russells Prinzip der nützlichen Maschine in Gestaltungsform: Ein Agent, der unsicher ist, fragt nach. Nachfragen und Unsicherheit zeigen entspricht Christians Kapitel über Unsicherheit; würdig scheitern ist Nygards Fallback und Huyens Rat aus dem Kapitel über die menschliche Seite des Machine Learning. Für Architekten wichtig: Die Stellung des Reglers ist eine fachliche Entscheidung pro Aktion, keine globale technische Einstellung.
Werkzeuge
Albada vergleicht Werkzeuge mit den Kompetenzen eines Menschen: Sie bestimmen, was ein Agent tatsächlich bewirken kann.
Arten von Werkzeugen
| Art | Beispiel | Besonderheit |
|---|---|---|
| Lokal | eine Berechnung, eine Formatierung | schnell, ohne Seiteneffekte |
| API-basiert | Wetterdienst, CRM-Abfrage | Netzwerk, Fehler, Latenz, Zugangsdaten |
| Plug-in | fertige Integrationen eines Anbieters | bequem, aber weniger Kontrolle |
| MCP | Werkzeuge eines MCP-Servers | standardisiert und zwischen Anwendungen teilbar |
| Zustandsbehaftet | Datenbank schreiben, Ticket anlegen | verändern die Welt; höchstes Risiko |
| Vom Modell erzeugt | das Modell schreibt Code und führt ihn aus | sehr flexibel, aber nur in einer abgeschotteten Umgebung vertretbar |
Gute Werkzeuge entwerfen
- Klare Namen und Beschreibungen: Das Modell kennt nur, was beschrieben ist.
- Enge Aufgaben: lieber mehrere kleine, eindeutige Werkzeuge als eines mit vielen Modi.
- Strukturierte, knappe Ergebnisse: Was das Werkzeug zurückgibt, landet im Kontext und kostet Tokens.
- Fehler als verständliche Rückmeldung: damit das Modell reagieren kann, statt abzubrechen.
- Zustandsbehaftete Werkzeuge besonders absichern: Bestätigung, Rechte, Rücknahme.
// Schreibende Aktion als Vorschlag: der Agent bereitet vor, ein Mensch gibt frei
@Component
class RefundTools {
    private final RefundService refunds;
    private final ApprovalQueue approvals;

    RefundTools(RefundService refunds, ApprovalQueue approvals) {
        this.refunds = refunds;
        this.approvals = approvals;
    }

    @Tool(description = "Prüft, ob für eine Bestellung eine Erstattung möglich ist, und liefert Betrag und Begründung. Ändert nichts.")
    RefundCheck checkRefund(@ToolParam(description = "Bestellnummer") String orderId) {
        return refunds.check(new OrderId(orderId));
    }

    @Tool(description = "Beantragt eine Erstattung. Die Erstattung wird erst nach menschlicher Freigabe ausgeführt; "
                      + "das Ergebnis ist eine Vorgangsnummer, keine Bestätigung der Zahlung.")
    ApprovalTicket requestRefund(@ToolParam(description = "Bestellnummer") String orderId,
                                 @ToolParam(description = "kurze Begründung für den Prüfer") String reason) {
        RefundCheck check = refunds.check(new OrderId(orderId));
        if (!check.eligible()) throw new IllegalStateException("Nicht erstattungsfähig: " + check.reason());
        return approvals.submit(new RefundRequest(check.orderId(), check.amount(), reason));   // keine Zahlung hier
    }
}
Einordnung
Die Trennung von prüfendem und beantragendem Werkzeug setzt den Autonomie-Regler im Code um. Die Prüfung erneut im schreibenden Werkzeug vorzunehmen, statt der Aussage des Modells zu vertrauen, folgt Secure by Design: Jede Grenze prüft selbst. Werkzeuge, die das Modell selbst erzeugt, sind aus Sicht von Christian und Russell die riskanteste Form von Autonomie; Albada empfiehlt sie nur mit strenger Abschottung.
Orchestrierung
Arten von Agenten
| Art | Arbeitsweise | Geeignet für |
|---|---|---|
| Reflex | reagiert direkt auf die Eingabe, ohne zu planen | einfache, klare Aufgaben |
| ReAct | wechselt zwischen Überlegen und Handeln, Schritt für Schritt | offene Aufgaben mit Werkzeugen |
| Planen und Ausführen | erstellt erst einen Plan, arbeitet ihn dann ab | Aufgaben mit absehbaren Teilschritten |
| Zerlegung von Anfragen | teilt eine komplexe Frage in Teilfragen | Recherche, Vergleiche |
| Reflexion | prüft und verbessert die eigene Antwort | Qualität vor Geschwindigkeit |
| Tiefenrecherche | viele Such- und Leseschritte, am Ende ein Bericht | ausführliche Recherchen |
Werkzeuge auswählen
Bei wenigen Werkzeugen gibt man dem Modell alle. Bei vielen wird das teuer und fehleranfällig. Albada beschreibt deshalb eine semantische Auswahl, bei der nur die zur Anfrage passenden Werkzeuge per Embedding-Suche angeboten werden, und eine hierarchische Auswahl, bei der erst eine Gruppe, dann das Werkzeug gewählt wird.
Topologien
Werkzeuge können einzeln, parallel, in Ketten oder als Graph mit Verzweigungen und Schleifen ausgeführt werden. Graphen, wie sie LangGraph bietet, machen Abläufe ausdrücklich, prüfbar und wiederaufnehmbar.
// Planen und Ausführen: der Plan ist strukturiert und kann vor der Ausführung geprüft werden
record Step(String tool, String input, String purpose) {}
record Plan(String goal, List<Step> steps) {}

@Service
class PlanAndExecute {
    private static final Set<String> ALLOWED = Set.of("findPolicy", "checkRefund", "searchKnowledgeBase");
    private final ChatClient chat;
    private final ToolRegistry tools;

    PlanAndExecute(ChatClient.Builder builder, ToolRegistry tools) { this.chat = builder.build(); this.tools = tools; }

    String run(String task) {
        Plan plan = chat.prompt()
            .system("Erstelle einen Plan aus höchstens 5 Schritten. Erlaubte Werkzeuge: " + ALLOWED)
            .user(task)
            .call()
            .entity(Plan.class);

        if (plan.steps().size() > 5 || plan.steps().stream().anyMatch(s -> !ALLOWED.contains(s.tool())))
            throw new IllegalStateException("Plan verletzt die Vorgaben");       // Plan vor Ausführung prüfen

        var results = new ArrayList<String>();
        for (Step step : plan.steps()) results.add(tools.invoke(step.tool(), step.input()));

        return chat.prompt()
            .user(u -> u.text("Aufgabe: {task}\nErgebnisse: {results}\nFormuliere die Antwort.")
                        .param("task", task).param("results", String.join("\n", results)))
            .call()
            .content();
    }
}
Kontext-Engineering
Albada greift den Begriff Kontext-Engineering auf, der sich 2025 in der Fachdiskussion durchgesetzt hat: das bewusste Auswählen, Ordnen und Zusammenstellen aller Informationen, die in das Kontextfenster des Modells gelangen, also Anweisungen, Werkzeugbeschreibungen, Gedächtnis, abgerufenes Wissen und Zwischenergebnisse. Bei Agenten, die viele Schritte durchlaufen, wächst der Kontext schnell; was nicht mehr hilft, muss gekürzt, zusammengefasst oder ausgelagert werden.
Einordnung
Planen und Ausführen hat einen großen Vorteil für die Architektur: Der Plan ist ein prüfbares Artefakt, an dem man Regeln durchsetzen kann, bevor etwas geschieht. Das ist Russells und Norvigs klassische Planung mit einem Sprachmodell als Planer. Graphen als Topologie sind Hohpes und Woolfs Process Manager und Vernons lang laufende Prozesse. Kontext-Engineering ist das, was Prompt Engineering wird, wenn der Prompt nicht mehr von Hand geschrieben, sondern zur Laufzeit zusammengesetzt wird.
Wissen und Gedächtnis
Albada unterscheidet zwei Arten, den Kontext eines Agenten anzureichern: Wissen sind Fakten von außen, etwa Richtlinien, Produktkataloge oder Protokolle. Gedächtnis ist die eigene Geschichte des Agenten: frühere Gespräche, Werkzeugergebnisse, Zustände.
| Ansatz | Idee |
|---|---|
| Kontextfenster verwalten | kürzen, zusammenfassen, Wichtiges priorisieren |
| Volltextsuche | klassische Stichwortsuche, oft unterschätzt |
| Semantisches Gedächtnis | Inhalte als Vektoren speichern und nach Bedeutung suchen |
| RAG | passende Abschnitte vor der Antwort abrufen |
| Erfahrungsgedächtnis | frühere, erfolgreiche Lösungswege speichern und bei ähnlichen Aufgaben wiederverwenden |
| GraphRAG und Wissensgraphen | Beziehungen zwischen Dingen explizit speichern; gut für Fragen über Zusammenhänge |
| Notizen | der Agent schreibt sich selbst Notizen, die er später wieder liest |
Bei dynamischen Wissensgraphen, die der Agent selbst erweitert, warnt Albada vor schleichenden Fehlern: Falsche Einträge werden später als Wissen behandelt.
Lernen
Das siebte Kapitel behandelt, wie Agenten mit der Zeit besser werden. Albada betont, dass Lernen nützlich, aber nicht nötig ist und zusätzlichen Aufwand für Entwurf, Bewertung und Überwachung bedeutet.
| Art | Verfahren |
|---|---|
| Ohne Änderung des Modells | gute Beispiele aus früheren Durchläufen als Vorlagen nutzen; Selbstreflexion nach Fehlern, deren Ergebnis im Gedächtnis landet; Erfahrungen sammeln und abrufen |
| Mit Änderung des Modells | überwachtes Finetuning, Präferenz-Finetuning, Reinforcement Learning mit überprüfbaren Belohnungen; oft mit kleinen, spezialisierten Modellen |
Einordnung
Das Erfahrungsgedächtnis ist Huyens Few-Shot-Prompting, automatisiert: Statt Beispiele von Hand auszuwählen, sammelt der Agent sie selbst. Die Warnung vor dynamischen Wissensgraphen entspricht Huyens entarteten Rückkopplungsschleifen: Ein System, das aus seinen eigenen Ausgaben lernt, kann seine Fehler verstärken. Die Verfahren zum Lernen mit Modelländerung sind die, die Raschka und Prince beschreiben; Reinforcement Learning mit überprüfbaren Belohnungen ist die Technik hinter den Reasoning-Modellen aus Raschkas Folgeband.
Von einem Agenten zu vielen
Wie viele Agenten braucht man?
Albada beginnt mit einer nüchternen Frage. Mehrere Agenten lohnen sich, wenn Aufgaben klar trennbare Fachgebiete haben, parallel bearbeitet werden können oder verschiedene Werkzeuge und Rechte brauchen. Sonst ist ein Agent meist besser: weniger Koordination, weniger Kosten, leichter zu verstehen. Neue Agenten sollte man nur hinzufügen, wenn ein Engpass das verlangt.
Koordination
| Form | Idee |
|---|---|
| Demokratisch | gleichberechtigte Agenten stimmen ab oder einigen sich |
| Manager | ein koordinierender Agent verteilt Aufgaben und führt Ergebnisse zusammen |
| Hierarchisch | mehrere Ebenen von Managern und Spezialisten |
| Akteur und Kritiker | ein Agent erzeugt, ein anderer bewertet und verlangt Verbesserungen |
| Schwarm | viele einfache Agenten ohne zentrale Steuerung |
Kommunikation und Zustand
| Mittel | Einsatz |
|---|---|
| Lokal im Prozess | einfache Systeme, ein Programm |
| Agent-zu-Agent-Protokoll | ein offener Standard, damit Agenten verschiedener Anbieter miteinander sprechen |
| Message Broker und Event Bus | lose Kopplung, Pufferung, Skalierung |
| Aktor-Frameworks wie Ray, Orleans oder Akka | viele Agenten als nebenläufige, isolierte Einheiten mit eigenem Zustand |
| Workflow-Engines | lang laufende Abläufe mit Wiederaufnahme nach Fehlern |
Der Zustand eines Agentensystems, also Gedächtnis, Zwischenergebnisse und Fortschritt, muss dauerhaft gespeichert werden, damit ein Absturz nicht die ganze Arbeit verliert.
Einordnung
Dieses Kapitel ist für Java-Architekten das vertrauteste: Es ist verteilte Systemarchitektur mit Agenten als Diensten. Die Frage „wie viele Agenten?“ ist Newmans Frage „wie viele Microservices?“, und die Antwort ist dieselbe: so wenige wie möglich, so viele wie nötig. Message Broker sind Hohpe und Woolf, Akka ist ein Aktor-Framework aus der JVM-Welt, und Workflow-Engines wie Temporal haben Java-SDKs. Die Koordination durch einen Manager ist der Koordinator aus The Hard Parts; die Schwarm-Variante entspricht der Choreografie, mit denselben Abwägungen.
Messen, überwachen, verbessern
Drei Kapitel bilden den Kern des Buchs aus Sicht des Betriebs. Albada nennt Messung den Schlussstein: Ohne sie lässt sich nicht entscheiden, welche Änderung man ausliefern sollte.
Validierung und Messung
Das Kapitel begleitet ein durchgehendes Beispiel: einen Kundenservice-Agenten, bei dem ein Kunde eine gesprungene Kaffeetasse meldet und eine Erstattung möchte.
| Ebene | Was geprüft wird |
|---|---|
| Bewertungsdatensätze | eine wachsende Sammlung realistischer Fälle mit erwarteten Ergebnissen, auch Randfälle |
| Komponenten | wählt der Agent das richtige Werkzeug mit den richtigen Parametern? Ist der Plan sinnvoll? Findet das Gedächtnis das Richtige? |
| Gesamtverhalten | wird die Aufgabe von Anfang bis Ende gelöst? Sind die Antworten konsistent, zusammenhängend, ohne Erfindungen? Wie reagiert der Agent auf unerwartete Eingaben? |
Bewertung gehört in den Entwicklungszyklus, nicht erst vor die Auslieferung.
Überwachung im Betrieb
| Thema | Inhalt |
|---|---|
| Werkzeuge | Stacks aus OpenTelemetry mit Grafana, ELK oder spezialisierte Werkzeuge für Sprachmodell-Anwendungen |
| Instrumentierung | jeder Modellaufruf, jeder Werkzeugaufruf und jeder Schritt als Abschnitt in einem Trace |
| Muster | Schattenbetrieb, Canary-Auslieferung, Sammeln problematischer Traces als Regressionstests |
| Signale | Nutzerfeedback, Verteilungsverschiebungen, Kosten, Fehlerraten |
| Verantwortung | jede Kennzahl braucht einen Verantwortlichen |
Verbesserungsschleifen
Das elfte Kapitel schließt den Kreis: Rückmeldungen werden gesammelt, Probleme automatisch erkannt und ihre Ursachen analysiert, Menschen prüfen ausgewählte Fälle, Prompts und Werkzeuge werden verbessert, und Änderungen werden über Schattenbetrieb, A/B-Tests oder Banditen verglichen, bevor sie für alle gelten.
Einordnung
Diese drei Kapitel sind Huyens Designing Machine Learning Systems für Agenten: Bewertung, Monitoring, Verteilungsverschiebungen, Testen in Produktion. Für Java-Architekten ist die Botschaft beruhigend: Die Werkzeuge sind bekannt. OpenTelemetry-Traces entstehen in Spring über Micrometer, wie Walls zeigt; Canary und Schattenbetrieb kennt man aus Continuous Delivery und Newman. Das Sammeln problematischer Traces als Regressionstests ist Feathers‘ Charakterisierungstest für Agenten.
Agentensysteme schützen
Albada bringt seine Erfahrung aus der Cybersicherheit ein. Agenten haben eigene Risiken, weil sie Eingaben aus vielen Quellen lesen, Werkzeuge mit echten Rechten nutzen und oft ohne Aufsicht arbeiten.
| Bereich | Maßnahmen |
|---|---|
| Bedrohungen verstehen | Bedrohungsmodellierung speziell für Agentensysteme, etwa mit dem MAESTRO-Rahmen; Red Teaming, also gezielte Angriffe auf das eigene System |
| Modelle absichern | Eingaben und abgerufene Inhalte als Daten behandeln, nicht als Anweisungen; Schutzschichten vor und nach dem Modell |
| Daten schützen | Verschlüsselung, Herkunft und Integrität der Daten, Umgang mit sensiblen Informationen |
| Agenten absichern | minimale Rechte, Begrenzung von Kosten und Schritten, Schutz gegen äußere Angriffe und innere Fehlfunktionen |
Zusammenarbeit von Mensch und Agent
Das letzte Kapitel betrachtet Agenten als Teil einer Organisation.
| Thema | Inhalt |
|---|---|
| Rollen | Menschen wechseln vom Ausführen zum Beaufsichtigen, Anleiten und Entscheiden in Ausnahmefällen |
| Akzeptanz | Beteiligte früh einbinden, Nutzen zeigen, Ängste ernst nehmen |
| Zuständigkeiten | welcher Agent darf was, welche Informationen teilen Agenten, wo liegen Grenzen |
| Vertrauen | wächst mit nachgewiesener Zuverlässigkeit; Autonomie wird schrittweise erweitert |
| Verantwortung | wer haftet für die Entscheidungen eines Agenten? |
| Eskalation | klare Wege, auf denen ein Agent an Menschen übergibt |
| Recht | Datenschutz und Regulierung |
Einordnung
Das Schutzkapitel ergänzt Secure by Design um die Angriffsflächen, die erst durch Sprachmodelle entstehen, und Walls‘ Kapitel über Absicherung um die strategische Ebene. Die Grundsätze sind vertraut: minimale Rechte, Verteidigung in mehreren Schichten, Annahme, dass jede Grenze angegriffen wird. Das Kapitel über Zusammenarbeit führt zurück zu den Soft-Skill-Büchern der Reihe: Vertrauen, das schrittweise wächst, beschreiben Fitzpatrick und Collins-Sussman für Teams, und die Frage der Verantwortung ist Martins Clean Coder für Systeme, die selbst handeln.
Kritik und Einordnung
Stärken
- Vollständig: von Entwurf und Nutzererfahrung über Werkzeuge, Gedächtnis und mehrere Agenten bis zu Messung, Betrieb, Sicherheit und Organisation.
- Nüchtern: Albada rät durchgehend zu so wenig Autonomie und so wenigen Agenten wie möglich.
- Betrieb im Mittelpunkt: drei Kapitel zu Messung, Überwachung und Verbesserung; das unterscheidet das Buch von vielen Einführungen.
- Seltene Themen: Nutzererfahrung, Sicherheit aus Sicht eines Praktikers, Zusammenarbeit mit Menschen.
- Aktuell: MCP, das Agent-zu-Agent-Protokoll und Kontext-Engineering sind berücksichtigt.
Kritikpunkte
1. Python-Werkzeuge. Die Beispiele nutzen LangChain und LangGraph; Java-Entwickler müssen übertragen. Die Konzepte sind aber unabhängig davon.
2. Breite statt Tiefe. Viele Themen bekommen ein Kapitel, in dem Grundlagen und Werkzeugvergleiche stehen; für Tiefe braucht man andere Bücher, etwa Huyen für Evaluation.
3. Schnelle Alterung. Frameworks, Protokolle und Werkzeuge für Agenten ändern sich in Monaten. Die Werkzeugübersichten werden schneller veralten als die Prinzipien.
4. Wenig Empirie. Wie gut Agenten in welchen Aufgaben tatsächlich funktionieren, belegt das Buch eher mit Erfahrung als mit Messungen; Mitchells Skepsis ist ein gutes Gegengewicht.
Gesamturteil
Das beste Buch der Reihe zum Bau von Agentensystemen. Es übersetzt Huyens Denken über ML-Systeme in die Welt der Agenten und ergänzt Walls‘ Spring-Code um die Architektur, die darüber liegt. Für Architekten besonders wertvoll sind die Kapitel 2, 3, 8 und 9 bis 12: Entwurf, Autonomie, mehrere Agenten, Messung, Betrieb und Sicherheit.
Bezüge zur Reihe
| Thema bei Albada | Bezug in der Reihe |
|---|---|
| Bausteine eines Agenten | Russell und Norvig: Agentenmodell; Huyen: Agentenkapitel |
| Workflows vor Agenten | Walls: Workflow-Muster; Géron, Huyen: erst das Einfache |
| Abwägungen beim Entwurf | Richards und Ford: Architekturmerkmale |
| Autonomie-Regler | Russell und Norvig: nützliche Maschinen; Christian: Unsicherheit, Korrigierbarkeit |
| Unsicherheit zeigen, nachfragen | Mitchell: Überschätzung vermeiden; Huyen: Kalibrierung |
| Würdig scheitern | Nygard: Fallback; Huyen: menschliche Seite des ML |
| Werkzeuge mit klaren Beschreibungen | Walls: @Tool; Ousterhout: einfache Schnittstellen |
| Prüfung auch im schreibenden Werkzeug | Secure by Design: jede Grenze prüft selbst |
| Planen und Ausführen | Russell und Norvig: klassische Planung |
| Graph-Orchestrierung | Hohpe und Woolf: Process Manager; Vernon: lang laufende Prozesse |
| Kontext-Engineering | Huyen: Kontextkonstruktion; Raschka: Kosten langer Kontexte |
| Wissen, Gedächtnis, GraphRAG | Alammar und Grootendorst: semantische Suche; Russell und Norvig: Wissensrepräsentation |
| Lernen mit und ohne Modelländerung | Raschka, Prince: Finetuning; Huyen: Rückkopplungsschleifen |
| Wie viele Agenten? | Newman: wie viele Dienste?; Conway: Struktur folgt Kommunikation |
| Manager und Schwarm | Ford u.a., The Hard Parts: Orchestrierung und Choreografie |
| Message Broker, Aktoren, Workflow-Engines | Hohpe und Woolf; Goetz u.a.: Nebenläufigkeit; Kleppmann: dauerhafter Zustand |
| Messung als Schlussstein | Huyen: Evaluation; Accelerate: messen statt glauben |
| Schattenbetrieb, Canary, Regressionstraces | Huyen, Designing ML Systems; Humble und Farley; Feathers: Charakterisierungstests |
| Schutz von Agentensystemen | Secure by Design; Walls: Absichern; Goodfellow u.a.: adversarielle Beispiele |
| Vertrauen, Verantwortung, Eskalation | Fitzpatrick und Collins-Sussman: Vertrauen; Martin: Clean Coder; Prince: Ethik |
Diskussionsfragen
- Workflow oder Agent: Welche eurer geplanten KI-Anwendungen braucht wirklich einen Agenten, welche wäre als Workflow besser?
- Autonomie: Wo würdet ihr den Regler für eure wichtigsten Aktionen einstellen? Wer entscheidet das?
- Werkzeuge: Welche schreibenden Werkzeuge würdet ihr einem Agenten überhaupt geben, und mit welcher Freigabe?
- Pläne prüfen: Könntet ihr Regeln formulieren, gegen die ein Agentenplan vor der Ausführung geprüft wird?
- Mehrere Agenten: Gibt es bei euch Aufgaben, die mehrere Agenten wirklich rechtfertigen? Welche Koordinationsform würde passen?
- Messung: Wie sähe ein erster Bewertungsdatensatz für euren Anwendungsfall aus, und wer pflegt ihn?
- Betrieb: Passt die Überwachung von Agenten in eure bestehende Beobachtungslandschaft, oder braucht ihr neue Werkzeuge?
- Verantwortung: Wer ist bei euch verantwortlich, wenn ein Agent eine falsche Entscheidung trifft?