Build a Large Language Model (From Scratch) – Zusammenfassung und Einordnung
Sebastian Raschka, Build a Large Language Model (From Scratch) (2024)
Einleitung
Huyens AI Engineering behandelt Sprachmodelle als fertige Bausteine. Raschkas Buch öffnet die Kiste: Es zeigt Schritt für Schritt, wie man ein kleines Sprachmodell im Stil von GPT selbst baut, trainiert und anpasst. Das Motto stammt, wie Raschka anführt, sinngemäß von Richard Feynman: Was ich nicht bauen kann, verstehe ich nicht.
Autor und Kontext
Sebastian Raschka ist Forscher und Entwickler im Bereich Machine Learning, früher Professor an der University of Wisconsin-Madison und danach bei Lightning AI. Bekannt wurde er durch Python Machine Learning und seinen Newsletter Ahead of AI, in dem er neue Forschung verständlich einordnet. Build a Large Language Model (From Scratch) erschien 2024 bei Manning und ist weiterhin in der ersten Auflage aktuell. Der vollständige Code steht auf GitHub und gehört zu den meistbeachteten Lernprojekten zu diesem Thema.
Die Kernthese
Sprachmodelle wirken wie Magie, sind aber im Kern verständlich: eine Abfolge überschaubarer Bausteine, die man mit wenigen hundert Zeilen Code nachbauen kann. Das Modell, das man im Buch baut, entspricht in seiner Architektur dem kleinsten GPT-2-Modell mit rund 124 Millionen Parametern. Es läuft auf einem normalen Laptop und folgt denselben Schritten wie die großen Modelle: Vortraining, Feinabstimmung, Anweisungsbefolgung.
Aufbau
| Kapitel | Inhalt |
|---|---|
| 1 | Sprachmodelle verstehen |
| 2 | Mit Text arbeiten: Tokenisierung, Embeddings |
| 3 | Aufmerksamkeitsmechanismen programmieren |
| 4 | Ein GPT-Modell implementieren |
| 5 | Vortraining auf unbeschrifteten Daten |
| 6 | Feinabstimmung für Klassifikation |
| 7 | Feinabstimmung zur Anweisungsbefolgung |
| Anhänge | Einführung in PyTorch, Erweiterungen der Trainingsschleife, LoRA |
Mit rund 350 Seiten ist das Buch kompakt. Es verwendet Python und PyTorch, aber keine fertigen Sprachmodell-Bibliotheken: Jeder Baustein wird selbst geschrieben. Die Java-Beispiele in dieser Zusammenfassung übertragen einige Kernideen in reines Java, ohne Bibliotheken, um zu zeigen, wie wenig Magie darin steckt.
Sprachmodelle verstehen
Was ein Sprachmodell tut
Im Kern löst ein Sprachmodell eine einfache Aufgabe: das nächste Token vorhersagen. Aus „Der Vertrag beginnt am“ berechnet es, wie wahrscheinlich jedes mögliche nächste Wort ist. Wiederholt man das, entsteht Text. Dass aus dieser einfachen Aufgabe Fähigkeiten wie Übersetzen, Zusammenfassen oder Programmieren entstehen, ist eine der überraschendsten Erkenntnisse der letzten Jahre.
Die Transformer-Architektur
Raschka erklärt kurz die Herkunft: Der ursprüngliche Transformer von 2017 bestand aus einem Encoder, der einen Eingabetext versteht, und einem Decoder, der einen Ausgabetext erzeugt, gedacht für Übersetzung. Daraus entwickelten sich zwei Familien:
| Familie | Aufbau | Beispiel | Stärke |
|---|---|---|---|
| Nur Encoder | liest den ganzen Text auf einmal, in beide Richtungen | BERT | Verstehen: Klassifikation, Suche |
| Nur Decoder | liest von links nach rechts, sagt das nächste Token voraus | GPT | Erzeugen von Text |
Die heutigen großen Sprachmodelle sind fast alle reine Decoder, und genau so eines baut man im Buch.
Die Phasen
| Phase | Inhalt | Ergebnis |
|---|---|---|
| Vortraining | auf großen Mengen unbeschrifteten Texts das nächste Token vorhersagen | ein Basismodell, das Text fortsetzen kann |
| Feinabstimmung für Klassifikation | mit beschrifteten Beispielen auf eine Aufgabe trainieren, etwa Spam erkennen | ein spezialisiertes Modell |
| Feinabstimmung für Anweisungen | mit Beispielen aus Anweisung und Antwort trainieren | ein Assistent, der Anweisungen befolgt |
Das Vortraining ist der teuerste Teil; für große Modelle kostet es Millionen. Raschka zeigt es im Kleinen und lädt dann die öffentlich verfügbaren Gewichte von GPT-2, damit man mit einem bereits vortrainierten Modell weiterarbeiten kann.
Einordnung
Das Kapitel ist die technische Fassung dessen, was Huyen in AI Engineering als Training, Nachtraining und Sampling beschreibt. Wer beide liest, versteht, warum die Ratschläge in AI Engineering sinnvoll sind: etwa warum Modelle halluzinieren, nämlich weil sie Wahrscheinlichkeiten fortsetzen und keine Fakten nachschlagen.
Mit Text arbeiten
Ein neuronales Netz rechnet mit Zahlen, nicht mit Buchstaben. Das zweite Kapitel beschreibt, wie Text zu Zahlen wird.
Tokenisierung
Text wird in Tokens zerlegt, kleine Einheiten, die jeweils eine Nummer erhalten. Raschka beginnt mit einem einfachen Tokenizer, der an Leerzeichen und Satzzeichen trennt, und zeigt dessen Problem: Wörter, die im Vokabular fehlen, kann er nicht darstellen.
GPT-Modelle verwenden deshalb Byte Pair Encoding: Häufige Zeichenfolgen werden zu einem Token zusammengefasst, seltene Wörter in Teile zerlegt. „Versicherungsvertrag“ wird vielleicht zu „Vers“, „icherungs“, „vertrag“. So lässt sich jedes Wort darstellen, und häufige Wörter bleiben kurz. Das Vokabular von GPT-2 umfasst rund 50.000 Tokens; im Buch wird dafür die Bibliothek tiktoken verwendet.
Zwei Folgen für die Praxis, die Huyen in AI Engineering aufgreift:
- Kosten und Grenzen werden in Tokens gemessen, nicht in Wörtern.
- Deutsche Texte brauchen oft mehr Tokens als englische mit gleichem Inhalt, weil die Tokenizer überwiegend mit englischen Texten erstellt wurden und lange zusammengesetzte Wörter in viele Teile zerfallen.
Trainingsbeispiele erzeugen
Für das Vortraining braucht man Paare aus Eingabe und Ziel. Das Ziel ist einfach die Eingabe, um ein Token verschoben: Aus jeder Position soll das Modell das nächste Token vorhersagen. Ein gleitendes Fenster schneidet aus einem langen Text viele solcher Paare.
// Eingabe- und Zielfolgen per gleitendem Fenster
record Sample(int[] input, int[] target) {}

static List<Sample> slidingWindow(int[] tokens, int contextLength, int stride) {
    var samples = new ArrayList<Sample>();
    for (int i = 0; i + contextLength < tokens.length; i += stride) {
        int[] input  = Arrays.copyOfRange(tokens, i, i + contextLength);
        int[] target = Arrays.copyOfRange(tokens, i + 1, i + contextLength + 1);   // um eins verschoben
        samples.add(new Sample(input, target));
    }
    return samples;
}
Embeddings
Jede Token-Nummer wird in einen Vektor übersetzt, beim kleinen GPT-2 mit 768 Zahlen. Die Embedding-Schicht ist nichts weiter als eine Nachschlagetabelle: Zeile i enthält den Vektor für Token i. Die Werte werden beim Training gelernt, sodass ähnliche Tokens ähnliche Vektoren erhalten.
Weil die Aufmerksamkeit, die im nächsten Kapitel folgt, die Reihenfolge der Tokens nicht von selbst kennt, kommt eine zweite Tabelle hinzu: Positions-Embeddings, ein gelernter Vektor pro Position. Beide Vektoren werden addiert und bilden die Eingabe des Modells.
Einordnung
Embeddings sind derselbe Gedanke, der in Huyens RAG-Kapitel bei der semantischen Suche auftaucht: Bedeutung als Position in einem Vektorraum. Hier lernt man, woher diese Vektoren kommen.
Aufmerksamkeit
Das dritte Kapitel ist das Herz des Buchs. Aufmerksamkeit ist der Mechanismus, mit dem jedes Token Informationen von anderen Tokens im Text sammelt. Raschka baut ihn in vier Schritten auf, jeweils etwas vollständiger.
Schritt 1: Einfache Selbstaufmerksamkeit
Für jedes Token berechnet man, wie ähnlich es jedem anderen Token ist, als Skalarprodukt ihrer Vektoren. Diese Werte werden mit Softmax in Gewichte umgewandelt, die sich zu eins addieren. Das neue Ergebnis für das Token ist die gewichtete Summe aller Vektoren. So fließt in „Bank“ Information aus „Geld“ oder „Ufer“ ein, je nachdem, was im Satz steht.
Schritt 2: Mit lernbaren Gewichten
Statt die Vektoren direkt zu vergleichen, werden sie mit drei lernbaren Matrizen in drei Rollen übersetzt:
| Rolle | Frage |
|---|---|
| Query | Wonach sucht dieses Token? |
| Key | Was bietet dieses Token an? |
| Value | Welche Information gibt es weiter, wenn es ausgewählt wird? |
Die Ähnlichkeit ist das Skalarprodukt aus Query und Key, geteilt durch die Wurzel der Dimension, damit die Werte bei großen Vektoren nicht zu groß werden. Das Ergebnis ist die gewichtete Summe der Values. Man nennt das skalierte Skalarprodukt-Aufmerksamkeit.
Schritt 3: Kausale Maske
Ein Sprachmodell, das das nächste Token vorhersagen soll, darf beim Training nicht in die Zukunft sehen. Eine Maske setzt deshalb alle Gewichte auf zukünftige Tokens auf null. Zusätzlich wird beim Training Dropout eingesetzt: Zufällig ausgewählte Gewichte werden auf null gesetzt, um Überanpassung zu vermeiden.
// Kausale, skalierte Skalarprodukt-Aufmerksamkeit, ein Kopf, in reinem Java
// x: [T][d]  Eingabevektoren für T Tokens;  wq, wk, wv: [d][dk]  gelernte Gewichte
static double[][] causalAttention(double[][] x, double[][] wq, double[][] wk, double[][] wv) {
    double[][] q = matmul(x, wq), k = matmul(x, wk), v = matmul(x, wv);
    int t = x.length, dk = wq[0].length;
    double scale = Math.sqrt(dk);
    double[][] out = new double[t][v[0].length];

    for (int i = 0; i < t; i++) {
        double[] scores = new double[i + 1];               // nur Positionen 0..i: kausale Maske
        for (int j = 0; j <= i; j++) scores[j] = dot(q[i], k[j]) / scale;
        double[] w = softmax(scores);
        for (int j = 0; j <= i; j++)
            for (int c = 0; c < v[j].length; c++) out[i][c] += w[j] * v[j][c];
    }
    return out;
}

static double[] softmax(double[] z) {
    double max = Arrays.stream(z).max().orElse(0), sum = 0;
    double[] e = new double[z.length];
    for (int i = 0; i < z.length; i++) { e[i] = Math.exp(z[i] - max); sum += e[i]; }   // numerisch stabil
    for (int i = 0; i < z.length; i++) e[i] /= sum;
    return e;
}
Schritt 4: Mehrere Köpfe
Multi-Head-Attention führt mehrere solcher Berechnungen parallel aus, jede mit eigenen Gewichten. Jeder Kopf kann auf andere Beziehungen achten, etwa Grammatik, Bezüge zwischen Wörtern oder Themen. Die Ergebnisse werden aneinandergehängt und durch eine weitere Matrix zusammengeführt. GPT-2 klein verwendet zwölf Köpfe.
Einordnung
Der Code zeigt, dass Aufmerksamkeit im Kern Matrizenrechnung und eine Schleife ist. Er zeigt auch, warum lange Kontexte teuer sind: Für T Tokens werden etwa T² Skalarprodukte berechnet, eine quadratische Wachstumsordnung, wie Sedgewick sie beschreibt. Der KV-Cache aus Huyens Inferenzkapitel speichert k und v früherer Tokens, damit sie bei jedem neuen Token nicht neu berechnet werden müssen.
Das GPT-Modell
Im vierten Kapitel werden die Bausteine zu einem vollständigen Modell zusammengesetzt. Das Ergebnis ist überraschend übersichtlich: Embeddings am Anfang, ein Ausgabekopf am Ende und dazwischen ein Transformer-Block, der zwölfmal hintereinander wiederholt wird.
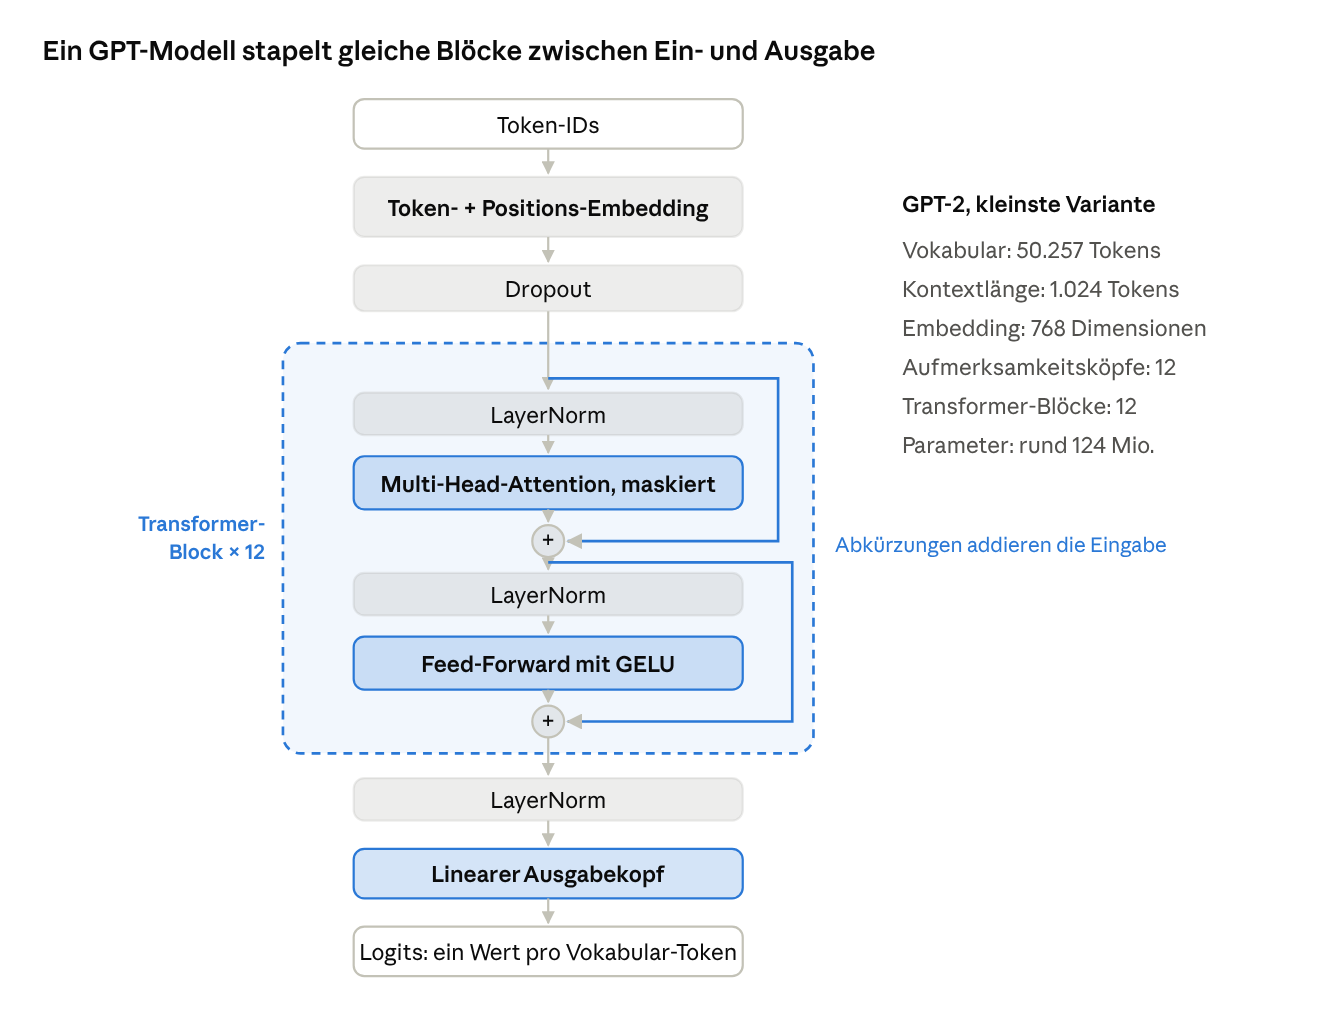
der Aufbau des GPT-Modells aus Raschkas Buch, mit der Konfiguration des kleinsten GPT-2
Die Bausteine eines Transformer-Blocks
| Baustein | Aufgabe |
|---|---|
| Layer Normalization | bringt die Werte jedes Vektors auf eine einheitliche Größenordnung; stabilisiert das Training |
| Multi-Head-Attention | sammelt Information aus anderen Tokens, wie im vorigen Abschnitt |
| Feed-Forward-Netz | verarbeitet jeden Token-Vektor einzeln weiter, mit einer Zwischenschicht, die viermal so breit ist, und der Aktivierungsfunktion GELU |
| Abkürzungen | die Eingabe eines Teilschritts wird zu seiner Ausgabe addiert, sogenannte Residualverbindungen; dadurch können Signale beim Training durch viele Schichten fließen, ohne zu verschwinden |
| Dropout | zufälliges Abschalten einzelner Werte beim Training gegen Überanpassung |
Vom Modell zum Text
Am Ende erzeugt der Ausgabekopf für jede Position einen Vektor mit einem Wert pro Token im Vokabular, die sogenannten Logits. Für die Textgenerierung nimmt man die Logits der letzten Position, wählt daraus ein Token, hängt es an die Eingabe an und wiederholt den Vorgang. Ohne Training liefert das Modell nur zufällige Tokens; das ändert das nächste Kapitel.
Größenordnungen
Die meisten Parameter stecken in den Feed-Forward-Netzen und den Embedding-Tabellen. Bei größeren Modellen wachsen vor allem die Breite der Vektoren und die Zahl der Blöcke; der Aufbau bleibt im Grundsatz gleich. Raschka zeigt am Ende des Kapitels, wie sich die Konfiguration für die größeren GPT-2-Varianten bis 1,5 Milliarden Parameter ändert.
Einordnung
Das Modell ist ein Paradebeispiel für Ousterhouts tiefe Module in umgekehrter Richtung: wenige, einfache Bausteine, deren Wiederholung erstaunliche Fähigkeiten erzeugt. Für Architekten interessant ist, wie regelmäßig der Aufbau ist; genau das macht es möglich, solche Modelle auf viele Grafikkarten zu verteilen, wie Huyen im Inferenzkapitel beschreibt.
Vortraining und Textgenerierung
Wie man misst, ob ein Modell lernt
Für jede Position kennt man das richtige nächste Token, nämlich das Ziel aus dem gleitenden Fenster. Das Modell liefert Wahrscheinlichkeiten für alle Tokens. Der Kreuzentropie-Verlust misst, wie viel Wahrscheinlichkeit das Modell dem richtigen Token gegeben hat: je höher die Wahrscheinlichkeit, desto kleiner der Verlust. Daraus abgeleitet ist die Perplexität, die man anschaulich als die Zahl der Tokens verstehen kann, zwischen denen das Modell im Mittel noch schwankt. Dieselben Maße nennt Huyen im Evaluationskapitel.
Die Trainingsschleife
Das Training folgt einem einfachen Muster, das für fast alle neuronalen Netze gilt:
- Einen Stapel von Eingaben durch das Modell schicken.
- Den Verlust gegenüber den Zielen berechnen.
- Per Rückpropagation berechnen, wie jeder Parameter den Verlust beeinflusst.
- Die Parameter mit einem Optimierer, im Buch AdamW, ein kleines Stück in die günstigere Richtung verschieben.
- Regelmäßig den Verlust auf zurückgehaltenen Validierungsdaten prüfen.
Raschka trainiert auf einer kurzen Erzählung, damit es auf einem Laptop in Minuten läuft. Man sieht dabei typische Effekte: Der Verlust auf den Trainingsdaten sinkt weiter, auf den Validierungsdaten nicht mehr; das Modell lernt den Text auswendig statt Sprache zu lernen. Für echtes Vortraining braucht man Milliarden von Tokens.
Dekodierung
Wie aus den Wahrscheinlichkeiten Text wird, bestimmt die Dekodierstrategie:
- Greedy: immer das wahrscheinlichste Token; liefert oft Wiederholungen.
- Temperatur: Logits werden vor dem Softmax durch einen Wert geteilt; kleiner als eins macht die Verteilung schärfer, größer als eins flacher.
- Top-k: nur unter den k wahrscheinlichsten Tokens wählen.
// Nächstes Token aus Logits wählen: Top-k und Temperatur
static int sampleNextToken(double[] logits, int topK, double temperature, RandomGenerator rnd) {
    Integer[] idx = IntStream.range(0, logits.length).boxed().toArray(Integer[]::new);
    Arrays.sort(idx, (a, b) -> Double.compare(logits[b], logits[a]));       // absteigend
    int k = Math.min(topK, logits.length);

    if (temperature <= 0) return idx[0];                                      // greedy

    double[] scaled = new double[k];
    for (int i = 0; i < k; i++) scaled[i] = logits[idx[i]] / temperature;
    double[] p = softmax(scaled);

    double r = rnd.nextDouble(), acc = 0;
    for (int i = 0; i < k; i++) { acc += p[i]; if (r < acc) return idx[i]; }
    return idx[k - 1];
}
Vortrainierte Gewichte laden
Weil echtes Vortraining unbezahlbar ist, lädt Raschka die öffentlich verfügbaren Gewichte von GPT-2 in das selbst gebaute Modell. Das funktioniert, weil die Architektur genau übereinstimmt: Jede Matrix im eigenen Code hat ihr Gegenstück in den veröffentlichten Gewichten. Danach erzeugt das eigene Modell sinnvollen englischen Text. Das ist einer der eindrucksvollsten Momente des Buchs, und ein Beleg dafür, dass man das Modell wirklich verstanden hat.
Einordnung
Die Trainingsschleife ist die Grundlage aller weiteren KI-Bücher der Reihe. Die Unterscheidung von Trainings- und Validierungsfehler, also Auswendiglernen gegen Verallgemeinern, ist dieselbe, die Géron und Prince ausführlich behandeln.
Finetuning für Klassifikation
Das sechste Kapitel passt das vortrainierte Modell an eine einfache, klar messbare Aufgabe an: SMS-Nachrichten als Spam oder nicht Spam erkennen.
Vorgehen
- Daten vorbereiten: einen beschrifteten Datensatz laden, Klassen ausbalancieren, in Training, Validierung und Test aufteilen, Nachrichten auf gleiche Länge auffüllen.
- Den Ausgabekopf ersetzen: Statt eines Werts pro Vokabular-Token, also rund 50.000 Ausgaben, braucht das Modell nur noch zwei: Spam oder nicht.
- Die meisten Schichten einfrieren: Nur der neue Ausgabekopf, der letzte Transformer-Block und die letzte Normalisierung werden trainiert. Das spart Rechenzeit und verhindert, dass das Modell sein Sprachwissen vergisst.
- Die Ausgabe des letzten Tokens verwenden: Wegen der kausalen Maske hat nur das letzte Token alle anderen „gesehen“; seine Ausgabe trägt die Information über die ganze Nachricht.
- Mit Genauigkeit messen: Anteil richtig klassifizierter Nachrichten auf den Testdaten.
Das Ergebnis ist ein Klassifikator mit hoher Genauigkeit, nach wenigen Minuten Training auf einem Laptop. Raschka zeigt damit, wie viel Wissen schon im vortrainierten Modell steckt.
Finetuning für Anweisungen
Das siebte Kapitel macht aus dem Basismodell einen Assistenten, der Anweisungen befolgt.
Daten
Das Training nutzt rund tausend Beispiele aus Anweisung, optionaler Eingabe und gewünschter Antwort, formatiert nach einer festen Vorlage. Eine bekannte Vorlage ist die von Stanford Alpaca.
Besonderheiten beim Training
- Auffüllen und Maskieren: Beispiele unterschiedlicher Länge werden pro Stapel auf gleiche Länge aufgefüllt. Aufgefüllte Positionen werden beim Berechnen des Verlusts ausgeblendet, damit das Modell nicht lernt, Füllzeichen vorherzusagen.
- Größeres Modell: Für brauchbare Ergebnisse verwendet Raschka hier die mittlere GPT-2-Variante mit rund 355 Millionen Parametern.
Bewertung mit einem anderen Modell
Besonders interessant für die Praxis: Um die Antworten zu bewerten, nutzt Raschka ein größeres Modell als Richter, im Buch Llama 3 über Ollama, das jeder Antwort eine Punktzahl gibt. Das ist genau die Methode „KI als Richter“, die Huyen ausführlich beschreibt, hier im Kleinen selbst gebaut.
Einordnung
Die beiden Kapitel zeigen den Unterschied, den Huyen als „Finetuning für die Form“ beschreibt: Das Modell lernt kein neues Wissen, sondern ein neues Verhalten, nämlich zu klassifizieren oder Anweisungen in einem bestimmten Format zu beantworten. Das Präferenz-Finetuning, mit dem große Assistenten zusätzlich auf menschliche Vorlieben ausgerichtet werden, behandelt das Buch nur am Rande; Raschka hat dazu ergänzendes Material veröffentlicht.
Die Anhänge
Die Anhänge sind mehr als Beiwerk; zwei davon sind für das Verständnis wichtig.
Einführung in PyTorch
Anhang A erklärt PyTorch kompakt: Tensoren, also mehrdimensionale Arrays, automatische Ableitung, mit der PyTorch Gradienten selbst berechnet, Modelle als Klassen mit einer forward-Methode, Datenlader und Training auf Grafikkarten. Für Leser ohne PyTorch-Erfahrung ist das der beste Einstieg vor Kapitel 2.
Für Java-Entwickler ist der Vergleich hilfreich: Ein PyTorch-Modell ist eine Klasse mit Feldern für Parameter und einer Methode, die die Berechnung beschreibt. Die automatische Ableitung entspricht einem Framework, das zu jedem Methodenaufruf im Hintergrund aufzeichnet, wie das Ergebnis von den Eingaben abhängt, und daraus rückwärts die Ableitungen berechnet.
Die Trainingsschleife verfeinern
Anhang D ergänzt Techniken, die das Training großer Modelle stabil machen:
| Technik | Zweck |
|---|---|
| Aufwärmphase der Lernrate | am Anfang mit kleinen Schritten beginnen, damit das Modell nicht gleich aus der Bahn gerät |
| Kosinus-Abfall | die Lernrate gegen Ende schrittweise verringern |
| Gradient Clipping | zu große Gradienten begrenzen, die das Training sonst destabilisieren |
LoRA
Anhang E zeigt parametereffizientes Finetuning mit LoRA, das Huyen im Finetuning-Kapitel beschreibt, hier selbst implementiert. Statt eine große Gewichtsmatrix W direkt zu ändern, lernt man zwei kleine Matrizen A und B, deren Produkt die Änderung darstellt. Die ursprüngliche Matrix bleibt eingefroren. Weil A und B nur einen Bruchteil der Parameter haben, braucht man viel weniger Speicher, und man kann mehrere Anpassungen für dieselbe Basis getrennt speichern und austauschen.
Ein Architekt würde sagen: LoRA ist ein Decorator im Sinne der Gang of Four, der das Verhalten einer Schicht erweitert, ohne sie zu ändern.
Was Java-Entwickler mitnehmen
Die wenigsten Java-Entwickler werden eigene Sprachmodelle trainieren. Trotzdem lohnt das Buch, aus drei Gründen.
Verständnis für Verhalten
Viele Eigenschaften von Sprachmodellen, die in AI Engineering als Erfahrungsregeln auftauchen, werden nach Raschka erklärbar:
| Beobachtung im Betrieb | Erklärung aus dem Buch |
|---|---|
| Antworten schwanken bei gleicher Frage | Sampling mit Temperatur und Top-k |
| Lange Prompts sind teuer und langsam | Aufmerksamkeit wächst quadratisch mit der Länge; Tokens werden einzeln erzeugt |
| Deutsche Texte kosten mehr | Tokenizer zerlegen deutsche Wörter in mehr Teile |
| Modelle erfinden Fakten | sie setzen Wahrscheinlichkeiten fort, statt nachzuschlagen |
| Finetuning ändert Verhalten, kaum Wissen | wenige Beispiele passen vor allem die oberen Schichten und das Ausgabeformat an |
Bessere Entscheidungen
Wer den Aufbau kennt, kann Anbieterversprechen und Architekturfragen besser einschätzen: Wann reicht ein kleines Modell? Was bedeutet eine größere Kontextlänge für Kosten? Was passiert bei Quantisierung? Das ist Hohpes Architekt im Aufzug: Er muss nicht jedes Detail selbst bauen, aber verstehen, was im Maschinenraum passiert.
Selbst nachbauen in Java
Wer das Buch durcharbeiten möchte, kann den Python-Code mitlesen und ausgewählte Teile in Java nachbauen. Eine lohnende Übung ist der Vorwärtsdurchlauf: das GPT-2-Modell ohne Training in Java implementieren, die veröffentlichten Gewichte laden und Text erzeugen. Dass das in reinem Java mit vertretbarer Geschwindigkeit möglich ist, zeigen Open-Source-Projekte, die Modelle wie Llama vollständig in Java ausführen und dabei die Vector API des JDK für schnelle Matrizenrechnung nutzen.
Für produktive Anwendungen gibt es im Java-Ökosystem verschiedene Wege, Modelle lokal auszuführen oder anzubinden: über Ollama mit Spring AI oder LangChain4j, über ONNX Runtime oder über die Deep Java Library. Training großer Modelle bleibt dagegen weitgehend in der Python-Welt.
Die Fortsetzung
2026 erscheint Raschkas Folgeband Build a Reasoning Model (From Scratch), als E-Book bereits seit dem Sommer verfügbar, gedruckt ab November. Nach der Verlagsbeschreibung geht es darum, ein vortrainiertes Modell so anzupassen, dass es schrittweise nachdenkt, bevor es antwortet, also um die Technik hinter den sogenannten Reasoning-Modellen, die in der AI-Engineering-Zusammenfassung unter den Entwicklungen seit 2025 auftauchen. Wer das erste Buch durchgearbeitet hat, hat dafür die Grundlagen.
Kritik und Einordnung
Stärken
- Verstehen durch Bauen: Kein anderes Buch der Reihe macht Sprachmodelle so greifbar. Nach dem Durcharbeiten gibt es keine „Magie“ mehr, nur noch Bausteine.
- Schrittweiser Aufbau: Jedes Kapitel baut auf dem vorigen auf, mit vielen Abbildungen und Zwischenergebnissen, die man prüfen kann.
- Auf einem Laptop machbar: Keine teure Hardware nötig.
- Exzellenter Begleitcode: Das GitHub-Repository ist sorgfältig gepflegt und um Bonusmaterial erweitert, etwa zu neueren Architekturen und Präferenz-Finetuning.
- Brücke zur Forschung: Wer das Buch kennt, kann wissenschaftliche Artikel über neue Modelle deutlich besser lesen.
Kritikpunkte
1. GPT-2 als Grundlage. Das Modell im Buch entspricht dem Stand von 2019. Neuere Modelle nutzen Verbesserungen wie andere Positionskodierungen, andere Normalisierungen und effizientere Aufmerksamkeitsvarianten. Raschka hat dazu Bonusmaterial veröffentlicht, aber das Buch selbst bleibt bei GPT-2.
2. Kein echtes Vortraining. Aus Kostengründen wird nur im Kleinen trainiert und dann auf fertige Gewichte zurückgegriffen. Die Herausforderungen großer Trainingsläufe, Datenaufbereitung, Verteilung auf viele Grafikkarten, Stabilität, bleiben außen vor.
3. Wenig über Nachtraining für Assistenten. Präferenz-Finetuning, das moderne Assistenten wesentlich prägt, wird nur gestreift.
4. Python und PyTorch vorausgesetzt. Für Java-Entwickler ist der Einstieg mit Anhang A machbar, aber die eigentliche Arbeit findet in Python statt.
5. Wenig Mathematik. Das ist bewusst so und macht das Buch zugänglich. Wer verstehen will, warum etwa Normalisierung oder Residualverbindungen funktionieren, braucht Prince oder Goodfellow.
Gesamturteil
Das beste Buch, um zu verstehen, was in einem Sprachmodell passiert. Für Java-Entwickler, die KI-Anwendungen bauen, ist es nicht unbedingt nötig, aber es macht die Ratschläge aus AI Engineering nachvollziehbar und schützt vor überzogenen Erwartungen. Wer Freude an Fowlers Refactoring-Schritten oder Becks kleinen TDD-Schritten hat, wird Raschkas schrittweisen Aufbau mögen.
Bezüge zur Reihe
Zwei Blickwinkel auf Sprachmodelle
| Huyen, AI Engineering | Raschka, Build an LLM (From Scratch) | |
|---|---|---|
| Blick | von außen: Modelle als Bausteine | von innen: wie ein Modell funktioniert |
| Frage | Wie baue ich eine zuverlässige Anwendung? | Was passiert im Modell? |
| Code | kaum | durchgehend, Python und PyTorch |
| Wichtigstes Thema | Evaluation | Aufmerksamkeit und Training |
Weitere Bezüge
| Thema bei Raschka | Bezug in der Reihe |
|---|---|
| Verstehen durch Bauen | Thomas und Hunt: Prototypen, Tracer Bullets; Feynman |
| Schrittweiser Aufbau mit Zwischenergebnissen | Beck: kleine Schritte; Fowler: Refactoring in kleinen Schritten |
| Quadratische Kosten der Aufmerksamkeit | Sedgewick: Wachstumsordnungen |
| Tokens, Kontextlänge, Kosten | Huyen: Inferenzkosten, Prompt-Caching |
| Sampling mit Temperatur und Top-k | Huyen: Sampling, Inkonsistenz |
| Trainings- und Validierungsfehler | Géron, Prince: Überanpassung |
| KI als Richter für Antworten | Huyen: Evaluation |
| LoRA als Zusatzschicht | Gang of Four: Decorator; Huyen: parametereffizientes Finetuning |
| Eingefrorene Schichten, neuer Ausgabekopf | Martin: Open-Closed-Prinzip; Feathers: Seams |
| Regelmäßiger Aufbau aus gleichen Blöcken | Ousterhout: einfache Schnittstellen; Huyen: Parallelisierung |
| Vector API für Matrizenrechnung | Goetz u.a.: Leistung auf der JVM |
Diskussionsfragen
- Magie oder Mechanik: Hat sich dein Bild von Sprachmodellen durch das Verständnis ihres Aufbaus verändert?
- Erklärbarkeit: Welche Verhaltensweisen von KI-Werkzeugen, die du nutzt, kannst du nach diesem Buch besser erklären?
- Selbst bauen: Würde es sich für dich lohnen, das Buch durchzuarbeiten, oder reicht das Verständnis aus der Zusammenfassung?
- Java: Wäre ein Java-Nachbau des Vorwärtsdurchlaufs mit der Vector API eine interessante Übung für dich oder dein Team?
- Kleine Modelle: Gibt es bei euch Aufgaben, für die ein kleines, selbst feinabgestimmtes Modell sinnvoller wäre als ein großes über eine API?
- Kontextlänge: Wie verändert das Wissen um quadratische Kosten deinen Umgang mit langen Prompts?
- Klassifikation: Welche eurer Klassifikationsaufgaben, etwa Tickets, E-Mails oder Schadensmeldungen, könnte ein feinabgestimmtes Modell übernehmen?
- Weiter: Als Nächstes Alammar und Grootendorst, Hands-On Large Language Models, das den praktischen Einsatz mit vielen Visualisierungen zeigt.