Artificial Intelligence: A Guide for Thinking Humans – Zusammenfassung und Einordnung
Melanie Mitchell, Artificial Intelligence: A Guide for Thinking Humans (2019, Taschenbuch mit neuem Vorwort 2025)
Einleitung
Die KI-Reihe endet mit einem Buch, das bewusst einen Schritt zurücktritt. Melanie Mitchell fragt nicht, wie man KI baut, sondern wie gut sie wirklich ist: Was können heutige Systeme, wo scheitern sie, und warum unterschätzen wir regelmäßig, wie schwer menschliche Intelligenz nachzubauen ist?
Die Autorin
Melanie Mitchell ist Professorin am Santa Fe Institute, einem Forschungszentrum für komplexe Systeme, und war zuvor Professorin an der Portland State University. Sie promovierte bei Douglas Hofstadter, dem Autor von Gödel, Escher, Bach, und entwickelte mit ihm das Programm Copycat, das Analogien zwischen Buchstabenfolgen findet. Ihr Buch Complexity: A Guided Tour wurde mehrfach ausgezeichnet. Sie kommentiert die KI-Entwicklung bis heute in einem viel gelesenen Newsletter.
Der Ausgangspunkt
Das Buch beginnt mit einer Szene von 2014: Hofstadter spricht bei einem Treffen mit KI-Forschern bei Google und bekennt, dass er erschrocken ist. Nicht, weil KI gefährlich würde, sondern weil er befürchtet, dass das, was er an menschlichem Denken am meisten bewundert, sich als billiger Trick herausstellen könnte, den Maschinen leicht nachahmen. Die Google-Forscher verstehen seine Sorge kaum; für sie ist schnelle KI-Entwicklung selbstverständlich gut. Mitchell will herausfinden, wer recht hat.
Ausgaben
Das Buch erschien im Herbst 2019. Im September 2025 kam eine Taschenbuchausgabe mit neuem Vorwort heraus, das auf die Entwicklung seit den großen Sprachmodellen eingeht; der Haupttext blieb unverändert.
Die Kernthese
Wir überschätzen regelmäßig, wie weit KI ist, und unterschätzen, wie komplex menschliche Intelligenz ist. Heutige Systeme sind in eng begrenzten Aufgaben beeindruckend, aber ihnen fehlt, was Mitchell nach dem Mathematiker Gian-Carlo Rota die Barriere der Bedeutung nennt: echtes Verständnis von Situationen, Allgemeinwissen, Abstraktion und Analogie. Bis diese Barriere überwunden ist, bleiben sie brüchig, also unerwartet fehleranfällig, sobald die Lage etwas anders ist als im Training.
Aufbau
| Teil | Thema |
|---|---|
| I | Hintergrund: Geschichte der KI |
| II | Sehen und Lernen: Bilderkennung |
| III | Spielen lernen: Reinforcement Learning |
| IV | KI trifft natürliche Sprache |
| V | Die Barriere der Bedeutung |
Rund 340 Seiten, für ein breites Publikum geschrieben, ohne Formeln.
Geschichte: Frühlinge und Winter
Der erste Teil erzählt die Geschichte der KI als eine Folge von Hoffnungen und Enttäuschungen.
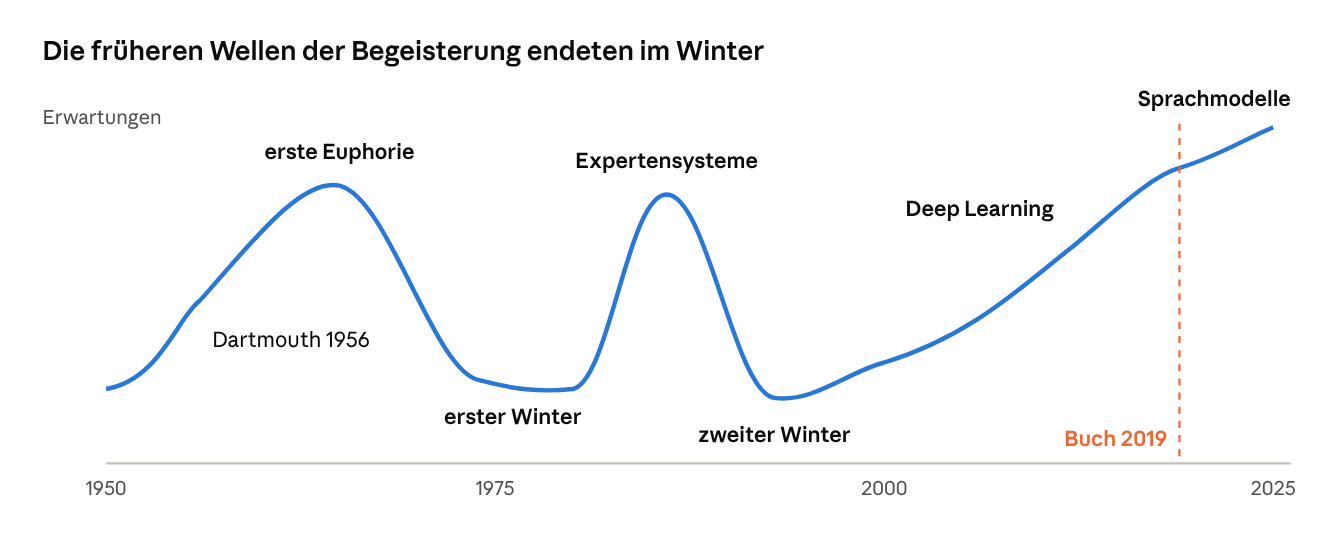
schematisch: Wellen der Erwartungen an KI, keine Messwerte
Symbolisch und subsymbolisch
Mitchell unterscheidet zwei Traditionen, die sich durch die ganze Geschichte ziehen:
| Tradition | Idee | Beispiele |
|---|---|---|
| Symbolische KI | Wissen in Regeln und Symbolen darstellen, durch Schließen Probleme lösen | Logik, Expertensysteme, Russell und Norvigs dritter Teil |
| Subsymbolische KI | Wissen in Gewichten von Netzen, aus Daten gelernt | Perzeptron, neuronale Netze, Deep Learning |
Die symbolische KI dominierte lange und scheiterte an der Fülle des Alltagswissens; die subsymbolische ist heute erfolgreich, hat aber Schwächen dort, wo die symbolische stark war: Abstraktion, Erklärbarkeit, Schließen.
Optimistische Prognosen
Die Gründer der KI erwarteten auf der Dartmouth-Konferenz 1956, in einem Sommer wesentliche Fortschritte zu erzielen. In den folgenden Jahrzehnten sagten führende Forscher immer wieder menschenähnliche KI für die nächsten zehn bis zwanzig Jahre voraus. Jede Welle endete in einem KI-Winter, als die Versprechen nicht eingelöst wurden und Fördergelder versiegten.
Leichte Dinge sind schwer
Ein wiederkehrendes Muster, das man nach dem Robotiker Hans Moravec benennt: Was Menschen schwer fällt, wie Schach oder Rechnen, ist für Computer oft leicht; was Kinder mühelos können, wie Gesichter erkennen, Gegenstände greifen, Sprache verstehen, ist für Computer äußerst schwer.
Einordnung
Für Architekten mit langer Berufserfahrung ist das Muster vertraut: Brooks‘ No Silver Bullet beschreibt dieselbe Dynamik für Softwaretechnik. Jede neue Technik verspricht einen Durchbruch, und am Ende bleibt ein nützliches Werkzeug, das die wesentliche Komplexität nicht beseitigt. Mitchell schrieb ihr Buch auf dem Höhepunkt der Deep-Learning-Welle; die nächste, die der Sprachmodelle, war da noch nicht absehbar.
Sehen und Lernen
Der zweite Teil behandelt die Bilderkennung, die ab 2012 den Durchbruch des Deep Learning brachte.
Der Erfolg
Mitchell erklärt Faltungsnetze anschaulich und erzählt die Geschichte des ImageNet-Wettbewerbs: Millionen von Bildern, beschriftet von bezahlten Klickarbeitern, und 2012 ein Faltungsnetz, das alle anderen Verfahren deutlich schlug. Bald darauf hieß es, Maschinen erkennten Bilder besser als Menschen.
Was hinter der Schlagzeile steckt
Mitchell prüft diese Behauptung genau und findet Einschränkungen: Gemessen wurde, ob die richtige Antwort unter den fünf Vorschlägen des Systems war, und der menschliche Vergleichswert stammte im Wesentlichen von einem einzigen Forscher, der sich selbst getestet hatte. Das ist kein Betrug, aber es zeigt, wie aus einer engen Messung eine weitreichende Behauptung wird.
Abkürzungen und Brüchigkeit
| Problem | Beispiel |
|---|---|
| Abkürzungen | Ein Netz, das Tierfotos erkennen sollte, achtete in einem Experiment aus Mitchells Umfeld auf unscharfe Hintergründe: Tierfotos waren meist mit geringer Schärfentiefe aufgenommen, Landschaften nicht |
| Der lange Schwanz | Ein selbstfahrendes Auto sieht im Training viele normale Situationen, aber nie alle seltenen, und die seltenen sind zusammen erstaunlich häufig |
| Täuschung | winzige, unsichtbare Änderungen an einem Bild führen zu völlig falschen Antworten; die adversariellen Beispiele aus Goodfellows Forschung |
| Datenhunger | Kinder lernen ein neues Konzept aus wenigen Beispielen, Netze brauchen Tausende |
Vertrauenswürdige KI
Ein kurzes Kapitel behandelt Fairness, Erklärbarkeit und Missbrauch, ähnlich wie Christian, aber knapper. Mitchells Hauptpunkt: Solange Systeme brüchig sind und man nicht versteht, warum sie entscheiden, ist Vorsicht bei folgenreichen Anwendungen geboten.
Einordnung
Die unscharfen Hintergründe sind das Bildgegenstück zu Huyens Datenlecks und Christians Asthma-Beispiel: Ein Modell lernt, was in den Daten zum Ergebnis passt, nicht was der Entwickler gemeint hat. Der lange Schwanz ist ein vertrautes Problem aus dem Betrieb, wie Nygard es beschreibt: Seltene Fälle sind einzeln selten, in Summe aber häufig, und gerade dort versagen Systeme.
Spielen lernen
Der dritte Teil behandelt Reinforcement Learning an den spektakulärsten Erfolgen der 2010er-Jahre.
Die Erfolge
| System | Leistung |
|---|---|
| Atari-Agent von DeepMind, 2015 | lernte Dutzende alter Videospiele allein aus den Bildschirmpixeln und dem Punktestand, viele auf oder über menschlichem Niveau |
| AlphaGo, 2016 | besiegte einen der weltbesten Go-Spieler; Go galt wegen der riesigen Zahl möglicher Stellungen als besonders schwer |
| AlphaGo Zero und Nachfolger | lernten ohne menschliche Partien, nur durch Spiele gegen sich selbst |
Mitchell erklärt die Technik verständlich: Q-Learning mit neuronalen Netzen für die Atari-Spiele, Monte-Carlo-Baumsuche kombiniert mit Netzen für Go; dieselbe Baumsuche, die Russell und Norvig beschreiben.
Was die Agenten nicht verstanden
Mitchells wichtigster Punkt: Die Agenten hatten die Spiele nicht in dem Sinn verstanden, wie Menschen sie verstehen.
- Bei einem Ballspiel, in dem man mit einem Schläger Steine abräumt, reichte es in Untersuchungen, den Schläger ein paar Pixel zu verschieben oder Kleinigkeiten am Bild zu ändern, damit ein trainierter Agent deutlich schlechter spielte. Ein Mensch merkt so etwas kaum.
- Gelerntes ließ sich kaum übertragen: Ein Agent, der ein Spiel beherrschte, musste ein ähnliches Spiel von vorne lernen.
- Die Agenten brauchten Millionen von Spielen, Menschen lernen ein neues Spiel in Minuten.
Jenseits der Spiele
Spiele haben klare Regeln, eindeutige Belohnungen und lassen sich beliebig oft simulieren. Die echte Welt hat nichts davon. Mitchell bezweifelt deshalb, dass der Erfolg in Spielen schnell auf Alltagsaufgaben übertragbar ist.
Einordnung
Das ist Christians Thema der Formung aus anderer Sicht: Agenten optimieren genau das, was gemessen wird, und das ist nicht dasselbe wie die Aufgabe verstehen. Für Architekten, die Agenten einsetzen, ist die Brüchigkeit gegenüber kleinen Änderungen eine Warnung: Ein Agent, der in der Testumgebung zuverlässig ist, kann in einer leicht veränderten Produktionsumgebung versagen; Huyens Verteilungsverschiebung in Reinform.
Sprache
Der vierte Teil wurde 2019 geschrieben, kurz nach BERT und GPT-2, aber vor dem Durchbruch großer Sprachmodelle. Er ist deshalb der am stärksten gealterte Teil, und zugleich der interessanteste, um Mitchells Thesen zu prüfen.
Wörter als Vektoren
Mitchell erklärt Wort-Embeddings mit der Idee, dass man ein Wort an seiner Umgebung erkennt: Wörter, die in ähnlichen Zusammenhängen vorkommen, bekommen ähnliche Vektoren. Sie zeigt Erfolge, etwa bei der Stimmungsanalyse, und die Verzerrungen, die Christian ausführlich behandelt.
Übersetzung
Mitchell testete 2019 maschinelle Übersetzung mit einer kurzen Geschichte über einen Restaurantbesuch. Die Ergebnisse waren meist flüssig, verfehlten aber an entscheidenden Stellen die Bedeutung: Doppeldeutigkeiten, Redewendungen, Zusammenhänge zwischen Sätzen. Ihr Schluss: Die Systeme übersetzen Wörter in Kontexten, verstehen aber nicht die Situation, die beschrieben wird.
Fragen beantworten
| System oder Test | Mitchells Befund |
|---|---|
| Watson gewinnt 2011 die Quizshow Jeopardy | beeindruckend, aber die Übertragung auf Medizin und andere Bereiche blieb weit hinter den Versprechen zurück |
| Leseverständnis-Tests, bei denen Systeme menschliche Werte erreichen | die Antworten stehen wörtlich im Text; Systeme finden sie durch Muster, ohne den Text zu verstehen |
| Winograd-Schemata | Sätze, in denen nur Weltwissen klärt, worauf sich ein Fürwort bezieht; 2019 für Maschinen noch schwer |
Ein Winograd-Schema lautet etwa: „Der Pokal passt nicht in den Koffer, weil er zu groß ist.“ Ist der Pokal oder der Koffer gemeint? Ersetzt man „zu groß“ durch „zu klein“, wechselt die Antwort. Menschen lösen das mühelos, weil sie wissen, wie Gegenstände und Behälter funktionieren.
Einordnung
Heutige Sprachmodelle lösen Winograd-Schemata, übersetzen deutlich besser und beantworten Fragen weit über das hinaus, was 2019 möglich war. Ob sie dabei verstehen, ist genau die Frage, die Mitchell gestellt hat, und sie ist weiter umstritten, wie der Abschnitt über die Zeit nach 2019 zeigt. Ihr Hinweis, dass Erfolge in Tests oft auf Mustern in den Testdaten beruhen, ist aktueller denn je: Huyen warnt vor Benchmarks, deren Daten ins Training gelangt sind.
Die Barriere der Bedeutung
Der letzte Teil ist das Herz des Buchs und Mitchells eigenes Forschungsgebiet. Er fragt: Was fehlt Maschinen, um wirklich zu verstehen?
Was Verstehen ausmacht
| Fähigkeit | Beschreibung |
|---|---|
| Grundwissen | schon Kleinkinder haben intuitive Vorstellungen davon, wie Gegenstände sich bewegen, was Lebewesen ausmacht und dass andere Menschen Absichten haben |
| Gedankliche Simulation | Menschen spielen Situationen im Kopf durch: Was passiert, wenn ich das Glas schräg halte? |
| Metaphern | wir verstehen Abstraktes über Konkretes, etwa Zeit als Raum („die Zukunft liegt vor uns“) |
| Abstraktion | das Wesentliche einer Situation erfassen und auf neue übertragen |
| Analogie | erkennen, dass zwei verschiedene Situationen im Kern gleich sind |
Allgemeinwissen von Hand
Mitchell beschreibt das Projekt Cyc, das seit den 1980er-Jahren versucht, menschliches Allgemeinwissen von Hand in Millionen von Regeln zu erfassen. Es zeigt, wie riesig und unscharf dieses Wissen ist, und dass es sich auf diese Weise kaum vollständig erfassen lässt.
Analogie als Kern
Mit Hofstadter vertritt Mitchell die These, dass Analogie der Kern menschlicher Intelligenz ist. Zwei Beispiele, die sie ausführlich bespricht:
- Bongard-Probleme: zwei Gruppen von je sechs einfachen Bildern; man soll die Regel finden, die sie unterscheidet, etwa „links ist die Figur innen, rechts außen“. Menschen lösen viele davon; Maschinen haben große Mühe, weil jedes Problem einen anderen Begriff verlangt.
- Copycat: Wenn „abc“ zu „abd“ wird, was wird dann aus „ijk“? Einfach: „ijl“. Und aus „xyz“? Hier gibt es kein Folgezeichen nach z; Menschen finden kreative Antworten wie „wyz“, indem sie die Situation neu deuten. Copycat sollte zeigen, wie solche flexiblen Deutungen entstehen können.
Die These
Ohne diese Fähigkeiten bleiben Systeme brüchig: Sie funktionieren in den Situationen, für die sie trainiert wurden, und versagen unerwartet, wenn sich etwas ändert. Für Mitchell ist das kein Detailproblem, das mehr Daten lösen, sondern eine grundsätzliche Lücke.
Einordnung
Die Analogie ist auch für Architekten zentral: Muster wie die der Gang of Four, Fowlers Enterprise-Muster oder Hohpes Integrationsmuster sind nichts anderes als dokumentierte Analogien: Lösungen, die man in neuen Situationen wiedererkennt. Gute Architekten sind gut im Erkennen solcher Ähnlichkeiten; genau die Fähigkeit, die Mitchell für den Kern von Intelligenz hält.
Sechs Fragen
Im letzten Kapitel beantwortet Mitchell sechs Fragen, die ihr häufig gestellt werden. Ihre Antworten von 2019, sinngemäß, und wie sie sich aus heutiger Sicht lesen:
| Frage | Mitchells Antwort 2019 | Aus heutiger Sicht |
|---|---|---|
| Wann fahren Autos selbst? | teilweise Autonomie ja; vollständig autonome Autos überall noch lange nicht, wegen des langen Schwanzes seltener Situationen | fahrerlose Taxis fahren inzwischen kommerziell in einigen Städten, aber in begrenzten Gebieten und mit Fernüberwachung; ihre Einschätzung hat sich weitgehend bestätigt |
| Führt KI zu Massenarbeitslosigkeit? | ungewiss; bisher haben Technologien neue Arbeit geschaffen, aber Vorhersagen sind schwierig | die Frage ist durch Sprachmodelle dringlicher geworden und weiter offen |
| Kann ein Computer kreativ sein? | grundsätzlich vielleicht, aber Kreativität braucht Urteil darüber, was gut ist; das fehlt heutigen Systemen | Bild- und Textgeneratoren erzeugen Erstaunliches; ob das Kreativität im vollen Sinn ist, bleibt umstritten |
| Wie weit ist allgemeine KI entfernt? | sehr weit; frühere Prognosen waren immer zu optimistisch | die Schätzungen vieler Fachleute sind deutlich kürzer geworden; Mitchell selbst bleibt skeptischer als viele |
| Wie viel Angst sollten wir haben? | weniger vor Superintelligenz als davor, brüchigen Systemen zu viel zuzutrauen, und vor Missbrauch | beide Sorgen sind heute verbreitet; dazu kam eine stärkere Debatte über Risiken sehr fähiger Systeme |
| Welche spannenden Probleme sind ungelöst? | fast alle grundlegenden: Verstehen, Allgemeinwissen, Abstraktion, Analogie | weiterhin aktive Forschungsfelder |
Die Gefahr der Überschätzung
Mitchells zentrale Warnung bleibt aktuell: Die größere Gefahr liegt nicht darin, dass Maschinen zu klug werden, sondern dass Menschen sie für klüger halten, als sie sind, und ihnen Entscheidungen anvertrauen, denen sie nicht gewachsen sind.
Einordnung
Die Tabelle ist ein gutes Beispiel für das, was Accelerate und McConnell für Softwareprojekte fordern: Prognosen später mit der Wirklichkeit vergleichen. Mitchell lag bei selbstfahrenden Autos weitgehend richtig. Bei Sprache wurde sie von der Geschwindigkeit des Fortschritts überrascht, wie fast alle; ob sie in der Grundsatzfrage des Verstehens recht behält, ist offen.
Nach 2019: Sprachmodelle aus Mitchells Sicht
Drei Jahre nach dem Buch kam ChatGPT, und mit ihm die Frage, ob die Barriere der Bedeutung gefallen ist. Mitchell hat sich dazu seitdem in Aufsätzen, Forschung und ihrem Newsletter geäußert.
Vier Denkfehler
2021 veröffentlichte sie einen vielbeachteten Aufsatz darüber, warum KI schwieriger ist, als wir denken. Sie nennt vier verbreitete Denkfehler:
| Denkfehler | Erklärung |
|---|---|
| Enge Intelligenz liegt auf dem Weg zur allgemeinen | jeder Erfolg bei einer Einzelaufgabe wird als Schritt zur allgemeinen KI gedeutet, obwohl das nicht folgt |
| Leichte Dinge sind leicht, schwere schwer | was für Menschen mühelos ist, ist für Maschinen oft am schwersten |
| Wunschdenken in Begriffen | wenn man Programme mit Wörtern wie „verstehen“ oder „lernen“ beschreibt, unterstellt man ihnen leicht menschliche Fähigkeiten |
| Intelligenz steckt allein im Kopf | menschliche Intelligenz ist an Körper, Gefühle und Kultur gebunden |
Ihre Forschung seitdem
Mitchell und ihre Mitarbeiter untersuchen, ob Sprachmodelle abstrahieren oder vor allem vertraute Muster wiedererkennen. Ein Ansatz: Aufgaben, die Modelle gut lösen, leicht abwandeln, etwa Buchstabenanalogien wie bei Copycat mit einem veränderten Alphabet. Menschen kommen mit solchen Varianten meist gut zurecht; Modelle wurden in solchen Untersuchungen deutlich schlechter. Mitchell deutet das als Hinweis, dass ein Teil der Leistung auf Ähnlichkeit zu Trainingsdaten beruht.
Die Gegenposition
Andere Forscher halten dagegen: Sprachmodelle, besonders die neueren Reasoning-Modelle, haben bei Abstraktionstests große Fortschritte gemacht, die sich mit bloßem Musterabgleich schwer erklären lassen, und auch Menschen sind bei ungewohnten Varianten schlechter. Ob man das „Verstehen“ nennt, ist zum Teil eine Frage der Definition. Die Debatte ist offen und wird intensiv geführt.
Was Praktiker daraus mitnehmen
Unabhängig davon, wer recht hat: Mitchells Methode ist für jeden nützlich, der KI einsetzt. Prüfe, ob das System bei kleinen, unerheblichen Änderungen gleich antwortet. Das ist der Invarianztest aus Huyens Designing Machine Learning Systems, angewandt auf Sprachmodelle.
// Brüchigkeitstest: Bleibt die Antwort stabil, wenn sich Unerhebliches ändert?
@Component
class RobustnessProbe {
    private final ChatClient chat;
    RobustnessProbe(ChatClient.Builder builder) { this.chat = builder.build(); }

    record Variant(String label, String prompt) {}
    record Result(String label, String answer) {}

    List<Result> probe(List<Variant> variants) {
        return variants.stream()
            .map(v -> new Result(v.label(), chat.prompt()
                .system("Antworte nur mit DECKUNG oder KEINE_DECKUNG.")
                .user(v.prompt())
                .call().content().strip()))
            .toList();
    }
}

// Varianten derselben Frage, die alle dieselbe Antwort haben sollten:
//   Original:        "Ein Rohr platzt im Keller, die Hausratversicherung umfasst Leitungswasser. ..."
//   Umformuliert:    gleiche Lage, andere Satzstellung
//   Irrelevantes:    zusätzlich erwähnt, dass der Kunde ein rotes Auto fährt
//   Namen getauscht: andere Personennamen, andere Stadt
// Weichen die Antworten voneinander ab, ist das System an dieser Stelle brüchig.
Einordnung
Mitchells Skepsis ist für Architekten wertvoll, gerade weil sie unbequem ist. Sie verlangt nicht, auf KI zu verzichten, sondern Systeme so zu bauen, dass man ihre Grenzen misst statt annimmt; genau das, was Huyen mit Evaluation und Monitoring fordert.
Kritik und Einordnung
Stärken
- Nüchternheit: Mitchell trennt sorgfältig, was Systeme können, von dem, was über sie behauptet wird.
- Verständlichkeit: Technische Grundlagen werden ohne Formeln, aber ohne Verfälschung erklärt.
- Eigene Prüfung: Sie testet Systeme selbst und prüft Schlagzeilen an den Originalquellen.
- Fragen statt Antworten: Das Buch lehrt, die richtigen Fragen zu stellen: Was genau wurde gemessen? Was passiert, wenn sich die Lage ändert?
- Kognitionswissenschaft: Der Teil über Verstehen, Abstraktion und Analogie gibt eine Perspektive, die in technischen Büchern fehlt.
Kritikpunkte
1. Vor den Sprachmodellen. Der Sprachteil wurde von der Entwicklung überholt; Leser müssen ihn mit Blick auf heutige Fähigkeiten lesen. Das neue Vorwort von 2025 geht auf die Entwicklung seitdem ein, ersetzt aber keine Überarbeitung des Haupttextes.
2. Skepsis als Grundhaltung. Kritiker werfen Mitchell vor, Fortschritte zu unterschätzen und die Messlatte für „Verstehen“ immer wieder höher zu legen. Befürworter halten dagegen, dass genau diese Vorsicht in einem Feld voller Übertreibung nötig ist.
3. Wenig Praxis. Wie man die Erkenntnisse beim Bau von Systemen umsetzt, bleibt dem Leser überlassen.
4. Unbestimmter Begriff. Was „Verstehen“ genau bedeutet und wie man es prüfen könnte, bleibt trotz guter Annäherungen unscharf.
Gesamturteil
Ein ideales Schlussbuch für die KI-Reihe. Nach neun Büchern, die zeigen, wie KI funktioniert und wie man sie baut, fragt Mitchell, wie viel man ihr zutrauen sollte. Ihre Antwort von 2019 ist in Teilen überholt, ihre Methode nicht: genau messen, Behauptungen prüfen, Brüchigkeit suchen. Für Architekten, die über den Einsatz von KI entscheiden, ist das die wichtigste Fähigkeit von allen.
Bezüge zur Reihe
| Thema bei Mitchell | Bezug in der Reihe |
|---|---|
| Frühlinge und Winter | Brooks: No Silver Bullet; Goodfellow u.a.: Zeitleiste seit 2016 |
| Symbolische und subsymbolische KI | Russell und Norvig: Logik und Lernen |
| Leichte Dinge sind schwer | Russell und Norvig: Robotik, Wahrnehmung |
| Schlagzeile gegen Messung | Accelerate, McConnell: was genau gemessen wurde |
| Abkürzungen, unscharfe Hintergründe | Huyen: Datenlecks; Christian: Asthma-Beispiel |
| Der lange Schwanz | Nygard: seltene Fehler im Betrieb; Huyen: Randfälle |
| Adversarielle Beispiele | Goodfellow u.a.: adversarielles Training |
| Agenten, die das Spiel nicht verstehen | Christian: Formung und ausgenutzte Belohnungen |
| Erfolge in Tests durch Muster in Testdaten | Huyen: Kontamination von Benchmarks |
| Analogie als Kern der Intelligenz | Gang of Four, Fowler, Hohpe: Muster als dokumentierte Analogien |
| Brüchigkeitstest | Huyen: Invarianztests; Thomas und Hunt: eigenschaftsbasierte Tests |
| Überschätzung als größte Gefahr | Russell und Norvig: Grenzen der KI; Christian: Unsicherheit erkennen |
Rückblick auf die KI-Reihe
Mit Mitchell ist die KI-Reihe abgeschlossen. Die zehn Bücher ergänzen sich zu einem Gesamtbild:
| # | Buch | Rolle in der Reihe |
|---|---|---|
| 1 | Huyen, AI Engineering | Anwendungen mit Foundation Models bauen und betreiben |
| 2 | Raschka, Build a Large Language Model | ein Sprachmodell von innen verstehen |
| 3 | Alammar und Grootendorst, Hands-On Large Language Models | was man mit Sprachmodellen praktisch tun kann |
| 4 | Huyen, Designing Machine Learning Systems | ML-Systeme mit eigenen Daten entwerfen und betreiben |
| 5 | Géron, Hands-On Machine Learning | die praktischen Grundlagen des Machine Learning |
| 6 | Prince, Understanding Deep Learning | warum Deep Learning funktioniert und wo wir es nicht verstehen |
| 7 | Goodfellow, Bengio, Courville, Deep Learning | das Fundament von 2016 und was davon trägt |
| 8 | Russell und Norvig, Artificial Intelligence: A Modern Approach | das ganze Feld der KI und der Rahmen des rationalen Agenten |
| 9 | Christian, The Alignment Problem | warum es schwer ist, dass Systeme tun, was wir meinen |
| 10 | Mitchell, A Guide for Thinking Humans | wie viel man KI zutrauen sollte |
Drei Linien durch die Reihe
- Daten bestimmen das Verhalten. Von Huyens Datenlecks über Christians Verzerrungen bis zu Mitchells Abkürzungen: Modelle lernen, was in den Daten steht, nicht was gemeint ist.
- Messen statt glauben. Huyens Evaluation, Gérons Testdaten, Prince‘ offene Fragen, Mitchells Prüfung der Schlagzeilen: Jede Fähigkeit muss für den eigenen Einsatz gemessen werden.
- Grundlagen überleben Werkzeuge. Goodfellows Mathematik, Russells und Norvigs Agentenmodell und Brooks‘ Einsichten aus der klassischen Reihe tragen über jeden Technologiewechsel hinweg.
Diskussionsfragen
- Überschätzung: Wo hast du erlebt, dass einem KI-System mehr zugetraut wurde, als es konnte?
- Schlagzeilen: Welche aktuelle KI-Behauptung würdest du gern an der Originalquelle prüfen?
- Brüchigkeit: Für welche eurer KI-Anwendungen würde sich ein Test mit unerheblichen Abwandlungen lohnen?
- Verstehen: Glaubst du, dass heutige Sprachmodelle verstehen? Spielt die Antwort für deine Arbeit eine Rolle?
- Analogie: Wie erkennst du in deiner Arbeit, dass ein neues Problem im Kern einem bekannten gleicht?
- Prognose: Welche der sechs Fragen würdest du heute anders beantworten als Mitchell 2019?
- Die Reihe: Welches der zehn KI-Bücher hat dein Bild am meisten verändert, und welches würdest du einem Kollegen zuerst empfehlen?
- Weiter: Welche offenen Diskussionsfäden aus den klassischen und den KI-Büchern möchtest du als Nächstes vertiefen?