Artificial Intelligence: A Modern Approach – Zusammenfassung und Einordnung
Stuart Russell, Peter Norvig, Artificial Intelligence: A Modern Approach, 4. Auflage (2020)
Einleitung
Die bisherigen KI-Bücher der Reihe behandeln vor allem Lernen aus Daten, und darin vor allem neuronale Netze. Russell und Norvig zeigen das ganze Feld: Suche, Logik, Planung, Wahrscheinlichkeit, Entscheidungen, Lernen, Sprache, Sehen, Robotik und die Frage, was KI für die Menschheit bedeutet. Seit fast dreißig Jahren ist es das Standardlehrbuch für Künstliche Intelligenz.
Die Autoren
| Autor | Hintergrund |
|---|---|
| Stuart Russell | Professor an der University of California, Berkeley; einer der bekanntesten Fürsprecher für KI-Sicherheit, Autor von Human Compatible (2019) |
| Peter Norvig | lange Forschungsdirektor bei Google, zuvor bei der NASA; heute am Stanford Institute for Human-Centered AI; Autor klassischer Lisp- und Python-Lehrmaterialien |
Auflagen
Die erste Auflage erschien 1995, die vierte und aktuelle 2020; sie wird an über 1.500 Universitäten in über 100 Ländern verwendet. Für die vierte Auflage wurden die Kapitel über Deep Learning, Sprachverarbeitung und Robotik weitgehend neu geschrieben, und es kamen Beiträge von Fachleuten wie Ian Goodfellow und Jacob Devlin, dem Hauptautor von BERT, hinzu. Begleitcode in Python und Java liegt auf GitHub.
Die Kernthese
KI ist die Wissenschaft vom Bau rationaler Agenten: Systeme, die ihre Umgebung wahrnehmen und so handeln, dass sie ein Ziel möglichst gut erreichen. Alle Teilgebiete sind verschiedene Werkzeuge für diese eine Aufgabe.
Die vierte Auflage enthält eine bemerkenswerte Selbstkorrektur: Das Standardmodell, ein Agent optimiert ein fest vorgegebenes Ziel, ist auf Dauer gefährlich, weil wir Ziele nie vollständig und richtig angeben können. Künftige KI sollte deshalb unsicher über die Ziele der Menschen sein und von ihnen lernen.
Aufbau
| Teil | Kapitel | Thema |
|---|---|---|
| I | 1–2 | Künstliche Intelligenz, intelligente Agenten |
| II | 3–6 | Problemlösen: Suche, Spiele, Bedingungserfüllung |
| III | 7–11 | Wissen, Schließen, Planen |
| IV | 12–18 | Unsicheres Wissen und Entscheidungen |
| V | 19–22 | Maschinelles Lernen |
| VI | 23–26 | Kommunizieren, Wahrnehmen, Handeln: Sprache, Sehen, Robotik |
| VII | 27–28 | Philosophie, Ethik und Sicherheit; die Zukunft der KI |
Intelligente Agenten
Was ist KI?
Russell und Norvig ordnen Definitionen von KI nach zwei Fragen: Geht es um Denken oder Handeln, und ist der Maßstab der Mensch oder Rationalität?
| wie ein Mensch | rational | |
|---|---|---|
| Denken | Kognitionswissenschaft | Logik, korrektes Schließen |
| Handeln | Turing-Test | rationale Agenten |
Das Buch wählt das rationale Handeln: Es ist allgemeiner als korrektes Schließen, denn manchmal muss man handeln, ohne beweisen zu können, was richtig ist, und es ist wissenschaftlich präziser als menschliches Verhalten.
Das Agentenmodell
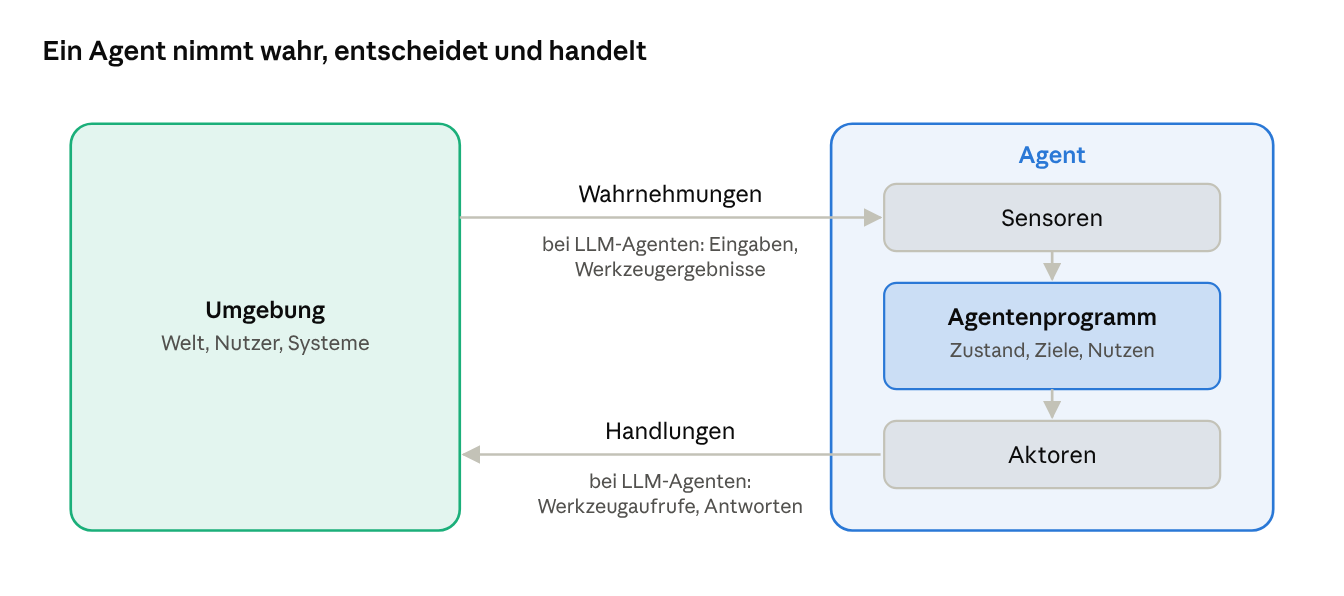
das Agentenmodell aus Russell und Norvig, mit der Entsprechung bei heutigen LLM-Agenten
Ein Agent ist rational, wenn er für jede Folge von Wahrnehmungen die Handlung wählt, die den erwarteten Erfolg nach einem Leistungsmaß maximiert, gegeben sein Wissen. Um eine Aufgabe zu beschreiben, nennen die Autoren vier Punkte: Leistungsmaß, Umgebung, Aktoren, Sensoren.
Eigenschaften von Umgebungen
| Eigenschaft | Gegensatz |
|---|---|
| vollständig beobachtbar | teilweise beobachtbar |
| ein Agent | mehrere Agenten, kooperativ oder im Wettbewerb |
| deterministisch | zufällig |
| episodisch: Entscheidungen unabhängig | sequenziell: jede Entscheidung beeinflusst die nächsten |
| statisch | dynamisch |
| diskret | kontinuierlich |
| bekannt | unbekannt |
Die schwierigste Umgebung ist teilweise beobachtbar, mit mehreren Agenten, zufällig, sequenziell, dynamisch, kontinuierlich und unbekannt; also die echte Welt.
Arten von Agenten
| Art | Arbeitsweise |
|---|---|
| Einfacher Reflexagent | reagiert direkt auf die aktuelle Wahrnehmung mit festen Regeln |
| Modellbasierter Reflexagent | führt einen inneren Zustand über Teile der Welt, die er gerade nicht sieht |
| Zielbasierter Agent | überlegt, welche Handlungen zu einem Ziel führen |
| Nutzenbasierter Agent | wägt ab, welches Ergebnis wie wünschenswert ist |
| Lernender Agent | verbessert seine Leistung durch Erfahrung |
Einordnung
Das Agentenmodell von 1995 beschreibt erstaunlich genau, was heute KI-Agent heißt: Ein Sprachmodell nimmt Eingaben und Werkzeugergebnisse wahr und handelt durch Werkzeugaufrufe. Huyens Agentenkapitel lässt sich als Anwendung dieses Rahmens lesen; die Umgebungseigenschaften helfen einzuschätzen, wie schwierig eine Agentenaufgabe ist. Ein Agent, der eine Wissensdatenbank durchsucht, arbeitet in einer weitgehend statischen, beobachtbaren Umgebung; einer, der im Namen eines Kunden mit anderen Systemen verhandelt, in einer der schwierigsten.
Problemlösen durch Suche
Viele Aufgaben lassen sich als Suche formulieren: Es gibt einen Anfangszustand, Handlungen, die von Zustand zu Zustand führen, Kosten und ein Ziel. Gesucht ist ein Weg zum Ziel, oft der günstigste. Routenplanung, Logistik, Puzzle, Konfiguration.
Uninformierte und informierte Suche
| Verfahren | Idee | Eigenschaft |
|---|---|---|
| Breitensuche | Ebene für Ebene | findet den kürzesten Weg bei gleichen Kosten; viel Speicher |
| Kostengesteuerte Suche | immer den bisher günstigsten Pfad erweitern | entspricht Dijkstra |
| Tiefensuche | einen Weg bis zum Ende verfolgen | wenig Speicher; nicht unbedingt optimal |
| Iterative Vertiefung | Tiefensuche mit wachsender Grenze | wenig Speicher und vollständig |
| A* | Pfadkosten plus Schätzung der Restkosten | optimal, wenn die Schätzung nie überschätzt |
Das Herz der informierten Suche ist die Heuristik: eine Schätzung, wie weit es noch zum Ziel ist, etwa die Luftlinie bei der Routenplanung. Russell und Norvig zeigen, wie man gute Heuristiken findet: indem man das Problem lockert, also Einschränkungen weglässt, und die Lösung des einfacheren Problems als Schätzung nutzt.
// A*-Suche auf einem allgemeinen Graphen
record Edge<S>(S to, double cost) {}

static <S> Optional<List<S>> aStar(S start, Predicate<S> isGoal,
                                   Function<S, List<Edge<S>>> neighbors,
                                   ToDoubleFunction<S> heuristic) {
    record Node<S>(S state, double g, double f) {}
    var open = new PriorityQueue<Node<S>>(Comparator.comparingDouble(Node::f));
    var bestG = new HashMap<S, Double>();
    var cameFrom = new HashMap<S, S>();
    open.add(new Node<>(start, 0, heuristic.applyAsDouble(start)));
    bestG.put(start, 0.0);

    while (!open.isEmpty()) {
        var current = open.poll();
        if (current.g() > bestG.get(current.state())) continue;          // veralteter Eintrag
        if (isGoal.test(current.state())) return Optional.of(path(cameFrom, current.state()));
        for (var e : neighbors.apply(current.state())) {
            double g = current.g() + e.cost();
            if (g < bestG.getOrDefault(e.to(), Double.POSITIVE_INFINITY)) {
                bestG.put(e.to(), g);
                cameFrom.put(e.to(), current.state());
                open.add(new Node<>(e.to(), g, g + heuristic.applyAsDouble(e.to())));   // f = g + h
            }
        }
    }
    return Optional.empty();
}

static <S> List<S> path(Map<S, S> cameFrom, S goal) {
    var p = new ArrayDeque<S>();
    for (S s = goal; s != null; s = cameFrom.get(s)) p.addFirst(s);
    return List.copyOf(p);
}
Weitere Suchverfahren
- Lokale Suche: Bergsteigen, simuliertes Abkühlen, genetische Algorithmen; wenn nur das Ergebnis zählt, nicht der Weg, etwa bei Stundenplänen.
- Spiele: Minimax mit Alpha-Beta-Schnitt für Gegner, die abwechselnd ziehen; Monte-Carlo-Baumsuche, die durch zufällige Spielverläufe bewertet und mit neuronalen Netzen kombiniert die Grundlage von AlphaGo war.
- Bedingungserfüllung: Variablen, Wertebereiche, Bedingungen; mit Rücksetzen und Konsistenzprüfung lösen sich viele Planungs- und Konfigurationsprobleme effizient.
Einordnung
A* ist Sedgewicks Dijkstra mit einer Heuristik; die Prioritätswarteschlange ist dieselbe. Bedingungserfüllung steckt in vielen Geschäftssystemen, von Schichtplänen bis Produktkonfiguration; in Java etwa mit Bibliotheken wie Timefold, früher OptaPlanner. Und die Suche kehrt bei Reasoning-Modellen zurück: Mehrere Lösungswege zu erkunden und zu bewerten, wie beim Gedankenbaum, den Alammar und Grootendorst beschreiben, ist Suche mit einem Sprachmodell als Heuristik.
Wissen, Logik und Planung
Der dritte Teil behandelt die symbolische KI: Wissen wird explizit in einer formalen Sprache dargestellt, und Schlussfolgerungen werden durch logisches Schließen gewonnen. Diese Tradition dominierte die KI von den 1950er- bis in die 1980er-Jahre.
Logik
| Ebene | Inhalt | Werkzeuge |
|---|---|---|
| Aussagenlogik | Aussagen, die wahr oder falsch sind, verknüpft mit und, oder, nicht | SAT-Solver, die heute riesige Probleme lösen, etwa in der Hardware-Verifikation |
| Prädikatenlogik | Objekte, Eigenschaften, Beziehungen, „für alle“ und „es gibt“ | Unifikation, Vorwärts- und Rückwärtsverkettung, Prolog |
Am Beispiel einer kleinen Höhlenwelt, in der ein Agent aus Gerüchen und Luftzügen auf Gefahren schließen muss, zeigen die Autoren, wie ein logischer Agent aus unvollständigen Wahrnehmungen sicheres Wissen ableitet.
Wissensrepräsentation
Wie stellt man Alltagswissen dar? Kategorien und Vererbung, Ereignisse und Zeit, Wissen über Wissen, Standardannahmen, die widerrufen werden können. Daraus sind Ontologien und Wissensgraphen hervorgegangen, wie sie Suchmaschinen und Unternehmen bis heute nutzen.
Planung
Planung sucht eine Folge von Handlungen, die einen gewünschten Zustand herbeiführt. Handlungen werden mit Vorbedingungen und Wirkungen beschrieben, und spezielle Heuristiken machen die Suche effizient. Dazu kommen hierarchische Planung, die große Aufgaben in Teilaufgaben zerlegt, Planung unter Unsicherheit und Zeitplanung mit Ressourcen.
Was davon heute zählt
| Gebiet | Heutige Bedeutung |
|---|---|
| SAT- und Bedingungslöser | weit verbreitet in Verifikation, Konfiguration, Planung |
| Regelsysteme | in Geschäftsanwendungen, in Java etwa mit Drools |
| Wissensgraphen | in Suche, Empfehlungen und als Ergänzung zu RAG |
| Klassische Planung | in Logistik und Robotik; Ideen kehren in Agenten zurück |
| Logik als Weg zu allgemeiner KI | weitgehend von lernenden Verfahren abgelöst |
Einordnung
Für Architekten liegt der Wert dieses Teils in einer Erinnerung: Nicht jedes Problem braucht Lernen. Wo Regeln bekannt, prüfbar und rechtlich relevant sind, etwa bei Tarifregeln oder Zulassungsbedingungen, ist ein Regelsystem nachvollziehbarer als ein Sprachmodell. Die hierarchische Planung entspricht dem, was Agenten mit Planungsschritten tun; dort fehlt oft die Strenge, mit der klassische Planer Vorbedingungen prüfen. Viele Forscher sehen in der Verbindung beider Welten, neurosymbolischer KI, einen Weg zu verlässlicheren Systemen.
Unsicherheit und Entscheidungen
Der vierte Teil ist mit sieben Kapiteln der größte und für viele Leser der wertvollste. Er zeigt, wie man mit unvollständigem und unsicherem Wissen rational handelt.
Wahrscheinlichkeit und der Satz von Bayes
Der Satz von Bayes verbindet, was man beobachtet, mit dem, was man wissen will. Ein klassisches Beispiel zeigt, wie trügerisch Intuition ist: Ein Betrugsdetektor erkennt 99 Prozent aller Betrugsfälle und schlägt nur bei 1 Prozent der ehrlichen Transaktionen fälschlich an. Wenn eine von tausend Transaktionen betrügerisch ist, wie wahrscheinlich ist dann Betrug bei einem Alarm?
// Satz von Bayes: Wie wahrscheinlich ist Betrug, wenn der Detektor anschlägt?
static double posterior(double prior, double sensitivity, double falsePositiveRate) {
    double alarmIfFraud  = sensitivity * prior;                 // P(Alarm und Betrug)
    double alarmIfHonest = falsePositiveRate * (1 - prior);     // P(Alarm und ehrlich)
    return alarmIfFraud / (alarmIfFraud + alarmIfHonest);       // P(Betrug | Alarm)
}

// posterior(0.001, 0.99, 0.01)  ≈ 0.09  — nur etwa jeder elfte Alarm ist echter Betrug
Das ist der Grund, warum Huyen und Géron bei seltenen Klassen auf Präzision achten: Bei kleinen Grundraten sind die meisten Alarme Fehlalarme, auch bei einem guten Detektor.
Bayessche Netze
Statt einer riesigen Tabelle aller Kombinationen beschreibt ein Bayessches Netz nur die direkten Abhängigkeiten zwischen Variablen als Graph. Das spart enorm Platz und macht das Modell verständlich. Die Autoren behandeln exakte und näherungsweise Inferenz und kausale Netze, mit denen man nicht nur Zusammenhänge, sondern die Wirkung von Eingriffen beschreiben kann.
Zeit und Programme
- Modelle über die Zeit: Hidden-Markov-Modelle, Kalman-Filter für die Verfolgung von Positionen, dynamische Bayessche Netze.
- Probabilistische Programmierung: Modelle als Programme schreiben, die Inferenz übernimmt ein allgemeines Werkzeug.
Entscheidungen
| Thema | Inhalt |
|---|---|
| Nutzentheorie | rationale Entscheidungen maximieren den erwarteten Nutzen |
| Wert von Information | wie viel es sich lohnt, vor einer Entscheidung mehr herauszufinden |
| Markov-Entscheidungsprozesse | Folgen von Entscheidungen unter Unsicherheit; Lösung durch Wert- und Strategieiteration |
| Teilweise beobachtbare Prozesse | wenn der Agent den Zustand nicht sicher kennt |
| Mehrere Agenten | Spieltheorie, Verhandlung, Auktionen, Abstimmungen |
Einordnung
Der Wert von Information ist ein Werkzeug, das Architekten intuitiv nutzen: Lohnt sich ein Prototyp, eine Messung, ein Spike, bevor man entscheidet? Russell und Norvig machen es rechenbar. Markov-Entscheidungsprozesse sind die Grundlage des Reinforcement Learning, das Géron und Prince behandeln. Und die Spieltheorie erklärt, warum Systeme mit mehreren Agenten, etwa konkurrierende KI-Agenten, ganz eigene Probleme haben.
Maschinelles Lernen
Der fünfte Teil behandelt auf rund 200 Seiten, was andere Bücher der Reihe ausführlicher darstellen. Er ist dennoch lesenswert, weil er Lernen in den größeren Rahmen des Buchs stellt: als eine Möglichkeit, einem Agenten Wissen zu verschaffen, statt es von Hand einzugeben.
| Kapitel | Inhalt | Ausführlicher bei |
|---|---|---|
| Lernen aus Beispielen | Entscheidungsbäume, Modellauswahl, Lerntheorie, lineare Modelle, nächste Nachbarn, Ensembles, ein Abschnitt zur Entwicklung von ML-Systemen in der Praxis | Géron; Huyen |
| Probabilistische Modelle lernen | maximale Likelihood, bayessches Lernen, EM-Algorithmus für verborgene Variablen | Prince; Goodfellow u.a. |
| Deep Learning | Netze, Rechengraphen, Faltungsnetze, rekurrente Netze, unüberwachtes Lernen und Transfer; von Goodfellow mitverfasst | Prince; Géron |
| Reinforcement Learning | passives und aktives Lernen, Q-Learning, Strategiesuche, inverses Reinforcement Learning | Prince; Géron |
Lerntheorie
Ein Thema, das in den anwendungsnahen Büchern fehlt: die Theorie des wahrscheinlich ungefähr korrekten Lernens. Sie beantwortet, wie viele Beispiele man braucht, damit ein gelerntes Modell mit hoher Wahrscheinlichkeit fast richtig ist. Die Antwort hängt von der Komplexität der Modellfamilie ab, und sie erklärt, warum klassische Statistik vor großen Modellen warnte; eine Warnung, die der doppelte Abstieg bei Prince relativiert.
Inverses Reinforcement Learning
Statt aus Belohnungen eine Strategie zu lernen, lernt man aus beobachtetem Verhalten, welche Belohnung dahintersteckt. Für Russell ist das ein Schlüssel zur Sicherheit: Maschinen sollen menschliche Ziele aus menschlichem Verhalten ableiten, statt ein fest einprogrammiertes Ziel zu verfolgen. Das führt direkt zum letzten Teil des Buchs.
Einordnung
Wer Géron, Prince und Goodfellow gelesen hat, findet hier wenig Neues zu den Verfahren, aber einen klareren Rahmen: Lernen ist kein Selbstzweck, sondern ein Weg, rationale Agenten zu bauen. Präferenz-Finetuning bei Sprachmodellen lässt sich als Verwandter des inversen Reinforcement Learning verstehen: Aus menschlichen Bewertungen wird erschlossen, was Menschen wollen.
Sprache, Sehen, Robotik
Der sechste Teil beschreibt, wie Agenten kommunizieren, wahrnehmen und physisch handeln.
Sprachverarbeitung
Zwei Kapitel zeigen den Übergang zwischen zwei Epochen:
| Kapitel | Inhalt |
|---|---|
| Sprachverarbeitung | Sprachmodelle aus Wortfolgen, Grammatiken, Syntaxanalyse, Bedeutung; die klassische, linguistisch geprägte Sicht |
| Deep Learning für Sprache | Wort-Embeddings, rekurrente Netze, Sequenz-zu-Sequenz-Modelle, Transformer, Vortraining und Transfer; mitverfasst von Jacob Devlin und Ming-Wei Chang, den Autoren von BERT |
Das zweite Kapitel war 2020 auf dem neuesten Stand: Es beschreibt Transformer, BERT und GPT-2 und weist darauf hin, dass vortrainierte Modelle die Sprachverarbeitung grundlegend verändern. Was zwei Jahre später mit ChatGPT folgte, konnte es noch nicht vorwegnehmen.
Bildverarbeitung
Von der Bildentstehung über Kanten, Texturen und optischen Fluss bis zu Klassifikation, Objekterkennung und dreidimensionaler Rekonstruktion mit Faltungsnetzen. Das Kapitel stammt von Jitendra Malik und David Forsyth, zwei führenden Forschern des Gebiets.
Robotik
Wahrnehmung, Lokalisierung, Kartierung, Bewegungsplanung, Regelung und Roboter, die mit Menschen zusammenarbeiten: Wie soll ein Roboter handeln, wenn er die Absichten eines Menschen nur erschließen kann? Das Kapitel wurde gemeinsam mit Anca Dragan geschrieben, die zu diesem Thema forscht.
Einordnung
Die Sprachkapitel sind ein Lehrstück für Leser der Reihe: Das klassische Kapitel zeigt, wie Sprache jahrzehntelang mit expliziten Regeln behandelt wurde; das zweite, wie das Lernen aus Daten diese Ansätze überholt hat. Brooks‘ Unterscheidung von wesentlicher und zufälliger Komplexität passt: Viel von der Komplexität der Grammatiken erwies sich als zufällig, also als Artefakt des Ansatzes, nicht der Sprache.
Philosophie, Ethik und Sicherheit
Können Maschinen denken?
Das vorletzte Kapitel stellt die klassischen Debatten dar: Einwände gegen die Möglichkeit von KI, Turings Test, Searles chinesisches Zimmer, das zeigen soll, dass Symbolverarbeitung kein Verstehen ist, und die Frage nach Bewusstsein. Die Autoren nehmen keine endgültige Position ein, sondern unterscheiden: Für den Bau nützlicher Systeme ist es unerheblich, ob eine Maschine „wirklich“ denkt; für ethische Fragen, etwa ob Maschinen Rechte haben können, ist es das nicht.
Ethische Fragen
| Thema | Fragen |
|---|---|
| Autonome Waffen | Dürfen Maschinen über Leben und Tod entscheiden? Russell engagiert sich seit Jahren für ein Verbot. |
| Überwachung und Privatsphäre | Gesichtserkennung, Datenauswertung, Anonymisierung |
| Fairness | verschiedene, teils unvereinbare Definitionen von Fairness |
| Vertrauen und Transparenz | Nachvollziehbarkeit von Entscheidungen, Zertifizierung |
| Arbeit | Automatisierung, Verteilung von Wohlstand |
| Sicherheit | Systeme, die tun, was wir sagen, aber nicht, was wir meinen |
Das Problem mit dem Standardmodell
Das wichtigste Argument des Buchs steht in der Einleitung und im letzten Kapitel. Das Standardmodell der KI lautet: Der Mensch gibt ein Ziel vor, die Maschine optimiert es. Russell und Norvig nennen das Problem nach König Midas, dessen Wunsch, alles in Gold zu verwandeln, wörtlich erfüllt wurde, mit verheerenden Folgen. Je fähiger eine Maschine ist, desto gefährlicher wird ein unvollständig oder falsch angegebenes Ziel, und Menschen können ihre Ziele nie vollständig angeben.
Nützliche Maschinen
Die vorgeschlagene Alternative:
- Das einzige Ziel der Maschine ist, die Präferenzen der Menschen zu erfüllen.
- Die Maschine ist sich anfangs unsicher, was diese Präferenzen sind.
- Die wichtigste Informationsquelle über menschliche Präferenzen ist menschliches Verhalten.
Eine solche Maschine hat einen Grund, nachzufragen, Menschen zu beobachten und sich abschalten zu lassen: Wenn ein Mensch sie stoppen will, ist das ein Hinweis, dass sie etwas falsch verstanden hat. Russell formalisiert das als Assistenzspiel zwischen Mensch und Maschine.
Die Zukunft
Das letzte Kapitel fragt, welche Bausteine für allgemeinere KI noch fehlen, und betrachtet mögliche Architekturen. Es bleibt bewusst offen, ob und wann allgemeine KI erreicht wird, betont aber, dass man über Sicherheit nachdenken muss, bevor sie da ist.
Einordnung
Dieser Teil ist für die Reihe besonders wichtig. Er ist die Brücke zu Christians The Alignment Problem, dem nächsten Buch, und zur Praxis: Die Unsicherheit über Ziele zeigt sich bei Agenten ganz konkret. Ein Agent, der bei unklaren oder folgenreichen Schritten nachfragt, statt sie eigenmächtig auszuführen, setzt Russells Prinzip im Kleinen um; ebenso die menschliche Freigabe für irreversible Aktionen, die Huyen empfiehlt.
Kritik und Einordnung
Stärken
- Das ganze Feld: Kein anderes Buch zeigt KI so vollständig. Wer nur Deep Learning kennt, sieht hier, was es sonst noch gibt und wofür es gut ist.
- Ein durchgehender Rahmen: Der rationale Agent verbindet Suche, Logik, Wahrscheinlichkeit und Lernen zu einem Ganzen.
- Klarheit: Trotz des Umfangs gut lesbar, mit Pseudocode, Beispielen und historischen Anmerkungen.
- Fachbeiträge: Kapitel von führenden Forschern der jeweiligen Gebiete.
- Sicherheit als Kernthema: Die Kritik am Standardmodell ist mutig für ein Lehrbuch, das das Feld seit Jahrzehnten prägt.
- Begleitcode in mehreren Sprachen, darunter Java.
Kritikpunkte
1. Umfang. Über 1.100 Seiten. Niemand liest es von vorne bis hinten; es ist ein Lehr- und Nachschlagewerk.
2. Vor ChatGPT. Das Buch erschien 2020. Große Sprachmodelle, Prompting, In-Context-Learning, Agenten auf Basis von Sprachmodellen fehlen. Die Teile über Sprache und Deep Learning sind daher am stärksten gealtert.
3. Gewichtung. Kritiker bemängeln, dass symbolische KI und klassische Planung mehr Raum bekommen, als ihrer heutigen Bedeutung entspricht. Befürworter halten dagegen, dass genau das Wissen wertvoll ist, das in anderen Büchern fehlt.
4. Akademisch. Für Praktiker ist der Weg von den Konzepten zur Anwendung oft weit.
5. Kein Wort zur Produktion. Wie man KI-Systeme betreibt, kommt nicht vor; das ist auch nicht der Anspruch.
Gesamturteil
Das Buch, das den Rahmen für alle anderen der Reihe liefert. Für Architekten ist es kein Arbeitsbuch, sondern eine Landkarte: Es zeigt, dass Sprachmodelle eine Technik unter vielen sind, und erinnert daran, dass Suche, Regeln, Wahrscheinlichkeit und Optimierung oft die besseren Werkzeuge sind. Lesenswert sind vor allem die Kapitel 1, 2, 12, 16 und 27 bis 28; der Rest nach Interesse.
Bezüge zur Reihe
| Thema bei Russell und Norvig | Bezug in der Reihe |
|---|---|
| Rationaler Agent, Wahrnehmen und Handeln | Huyen: Agenten mit Werkzeugen und Planung |
| Eigenschaften von Umgebungen | Huyen: Schwierigkeit von Agentenaufgaben; Nygard: Fehler in verteilten Systemen |
| A* und Heuristiken | Sedgewick: Dijkstra, Prioritätswarteschlangen |
| Probleme lockern, um Heuristiken zu finden | Thomas und Hunt: Probleme vereinfachen; Beck: das Einfachste, das funktionieren könnte |
| Monte-Carlo-Baumsuche | Alammar und Grootendorst: Gedankenbaum; Raschka: Reasoning-Modelle |
| Bedingungserfüllung | Planungs- und Konfigurationssysteme in Unternehmen |
| Regelsysteme, Wissensgraphen | Evans: Domänenwissen explizit machen; Huyen: RAG mit strukturierten Daten |
| Satz von Bayes, Grundraten | Géron, Huyen: Präzision bei seltenen Klassen |
| Wert von Information | Hohpe: Optionen; Ford u.a.: Entscheidungen hinauszögern |
| Markov-Entscheidungsprozesse | Géron, Prince: Reinforcement Learning |
| Inverses Reinforcement Learning | Huyen, Raschka: Präferenz-Finetuning |
| Klassische und neuronale Sprachverarbeitung | Brooks: wesentliche und zufällige Komplexität |
| Kritik am Standardmodell, König Midas | Prince: Ethik; Christian: The Alignment Problem |
| Maschinen, die nachfragen und sich abschalten lassen | Huyen: menschliche Freigabe für folgenreiche Aktionen; Martin: Nein sagen |
Diskussionsfragen
- Werkzeugwahl: Welche eurer Probleme werden mit Sprachmodellen angegangen, obwohl Suche, Regeln oder Optimierung besser passen würden?
- Umgebung: Wie würdest du die Umgebung eurer KI-Agenten nach Russell und Norvig beschreiben? Was macht sie schwierig?
- Grundraten: Gibt es bei euch Alarme oder Prüfungen, bei denen die meisten Treffer Fehlalarme sind? Wie geht ihr damit um?
- Regeln: Wo würdet ihr bewusst ein Regelsystem statt eines lernenden Modells einsetzen, etwa aus Gründen der Nachvollziehbarkeit?
- Wert von Information: Wie entscheidest du, ob sich ein Prototyp oder eine Messung vor einer Architekturentscheidung lohnt?
- Ziele: Gibt es in euren Systemen Kennzahlen, die optimiert werden und dabei etwas Wichtigeres beschädigen könnten?
- Nachfragen: Sollten eure KI-Agenten öfter nachfragen? Wo wäre das lästig, wo notwendig?
- Weiter: Als Nächstes Christian, The Alignment Problem, das die Frage der Wertausrichtung an Geschichten aus Forschung und Praxis erzählt.