Algorithms – Zusammenfassung und Einordnung
Robert Sedgewick, Kevin Wayne, Algorithms (4. Auflage 2011)
Einleitung
Nach 30 Büchern über Entwurf, Architektur, Betrieb und Organisation geht es zurück zum Fundament: Algorithmen und Datenstrukturen. Sedgewicks und Waynes Algorithms ist eines der verbreitetsten Lehrbücher dazu und für Java-Entwickler besonders zugänglich, weil jede Datenstruktur und jeder Algorithmus als vollständiger, lauffähiger Java-Code im Buch steht.
Autoren und Geschichte
Robert Sedgewick ist Professor in Princeton, wo er die Informatik-Fakultät gegründet hat. Er promovierte bei Donald Knuth mit einer Arbeit über Quicksort und ist Mitentwickler der Rot-Schwarz-Bäume (mit Leonidas Guibas, 1978). Kevin Wayne ist ebenfalls Professor in Princeton, mit Schwerpunkt auf Graphen und Optimierung.
Das Buch hat eine lange Geschichte:
| Jahr | Ausgabe |
|---|---|
| 1983 | erste Auflage, Pascal |
| 1988 und später | zweite Auflage; Ausgaben in C, C++ und Modula-3 |
| 1990er bis 2000er | dritte Auflage in mehreren Bänden, für C, C++ und Java |
| 2011 | vierte Auflage mit Kevin Wayne, ein Band, vollständig neu in Java |
Begleitmaterial
Das Buch ist Teil eines größeren Lehrangebots:
- Die Website algs4.cs.princeton.edu enthält Zusammenfassungen, den vollständigen Code, Testdaten und Übungen.
- Die Bibliothek algs4.jar mit allen Datenstrukturen und Hilfsklassen wie
StdInundStdOut. - Zwei Online-Kurse auf Coursera, Algorithms, Part I und Part II, mit Videovorlesungen, die über die Jahre sehr viele Teilnehmer hatten.
Die Haltung
Die Autoren verbinden zwei Dinge, die in Algorithmenbüchern oft getrennt sind: wissenschaftliche Analyse und praktische Implementierung. Sie messen Laufzeiten mit Experimenten, bilden Hypothesen über Wachstumsordnungen und prüfen sie mathematisch. Algorithmen werden nicht als Pseudocode beschrieben, sondern als echter Code, der mit großen Datenmengen getestet wird. Das Buch versteht sich als Gegenstück zu theorielastigen Werken wie Cormen u.a., Introduction to Algorithms.
Aufbau
| Kapitel | Inhalt |
|---|---|
| 1. Grundlagen | Programmiermodell, Datenabstraktion, Bag, Queue, Stack, Analyse von Algorithmen, Union-Find |
| 2. Sortieren | elementare Verfahren, Mergesort, Quicksort, Prioritätswarteschlangen, Anwendungen |
| 3. Suchen | Symboltabellen, binäre Suchbäume, balancierte Bäume, Hashtabellen |
| 4. Graphen | ungerichtete und gerichtete Graphen, minimale Spannbäume, kürzeste Wege |
| 5. Strings | String-Sortierung, Tries, Teilstringsuche, reguläre Ausdrücke, Kompression |
| 6. Kontext | Simulation, B-Bäume, Suffix-Arrays, Netzwerkflüsse, Reduktion, Unlösbarkeit |
Mit fast 1000 Seiten ist es das umfangreichste Buch der Reihe. Die Autoren sprechen von etwa fünfzig Algorithmen, die jeder Programmierer kennen sollte.
Grundlagen
Programmiermodell und Datenabstraktion
Das Buch verwendet bewusst eine kleine Teilmenge von Java: statische Methoden, Arrays, Klassen, Generics, Iteratoren. Keine Frameworks, kaum Vererbung. Jede Datenstruktur wird zuerst als API beschrieben, also als Liste ihrer Operationen, und erst dann implementiert. Clients verwenden nur die API. Das ist Datenabstraktion im Sinne von Parnas und Ousterhouts tiefen Modulen: eine kleine Schnittstelle, hinter der sich unterschiedlich effiziente Implementierungen verbergen können.
Bag, Queue und Stack
Drei grundlegende Sammlungen, die sich nur in der Reihenfolge der Entnahme unterscheiden:
| Typ | Entnahme | Einsatz |
|---|---|---|
| Bag | keine Entnahme, nur Durchlaufen | Werte sammeln, etwa Kanten eines Knotens |
| Queue | zuerst hinein, zuerst heraus | Warteschlangen, Breitensuche |
| Stack | zuletzt hinein, zuerst heraus | Rekursion, Ausdrucksauswertung, Tiefensuche |
Für jeden Typ zeigen die Autoren zwei Implementierungen:
- Größenveränderliches Array: Bei vollem Array wird die Größe verdoppelt, bei einem Viertel Füllstand halbiert. Jede Operation kostet im Mittel konstante Zeit, einzelne Operationen gelegentlich mehr.
- Verkettete Liste: Jede Operation kostet garantiert konstante Zeit, aber jedes Element braucht zusätzlichen Speicher für den Verweis.
public class ResizingArrayStack<Item> implements Iterable<Item> {
    private Item[] a = (Item[]) new Object[1];
    private int n;

    public void push(Item item) {
        if (n == a.length) resize(2 * a.length);              // verdoppeln
        a[n++] = item;
    }

    public Item pop() {
        Item item = a[--n];
        a[n] = null;                                           // kein Speicherleck
        if (n > 0 && n == a.length / 4) resize(a.length / 2);  // halbieren bei 1/4
        return item;
    }

    private void resize(int capacity) {
        a = Arrays.copyOf(a, capacity);
    }

    public Iterator<Item> iterator() {
        return new Iterator<>() {
            private int i = n;
            public boolean hasNext() { return i > 0; }
            public Item next() { return a[--i]; }
        };
    }
}
Die Halbierung bei einem Viertel statt bei der Hälfte ist ein schönes Detail: Sonst würde ein Stack, der abwechselnd an der Grenze wächst und schrumpft, bei jeder Operation das ganze Array kopieren.
Die Zeile a[n] = null verhindert, was Bloch in Effective Java Item 7 als veraltete Referenz beschreibt: Ohne sie hielte das Array Verweise auf entfernte Objekte, die der Garbage Collector nicht freigeben kann.
Dijkstras Zwei-Stack-Algorithmus
Ein klassisches Beispiel des Kapitels: Ausdrücke wie ( 1 + ( ( 2 + 3 ) * ( 4 * 5 ) ) ) lassen sich mit einem Stack für Operanden und einem für Operatoren auswerten. Bei jeder schließenden Klammer werden ein Operator und zwei Operanden entnommen, verrechnet und das Ergebnis zurückgelegt. Das zeigt, wie eine einfache Datenstruktur ein scheinbar schwieriges Problem löst.
Einordnung
In der Praxis nutzt man ArrayDeque aus dem JDK, das intern ebenfalls ein größenveränderliches Array verwendet, und nicht die veralteten Stack und Vector. Bloch empfiehlt dasselbe. Der Wert des Kapitels liegt im Verständnis, warum ArrayList.add im Mittel konstante Zeit kostet.
Analyse von Algorithmen
Das Kapitel 1.4 ist eines der wertvollsten des Buchs, weil es zeigt, wie man über Laufzeit wissenschaftlich nachdenkt statt nach Gefühl.
Die wissenschaftliche Methode
Die Autoren übertragen das Vorgehen der Naturwissenschaften: beobachten, eine Hypothese aufstellen, eine Vorhersage ableiten, sie durch Experimente prüfen. Ein typisches Werkzeug ist das Verdopplungsexperiment: Man misst die Laufzeit für N, 2N, 4N, 8N Elemente. Verdoppelt sich die Zeit jeweils, ist der Algorithmus linear; vervierfacht sie sich, quadratisch; verachtfacht sie sich, kubisch. Das Verhältnis der Laufzeiten verrät die Wachstumsordnung, ohne dass man den Code mathematisch analysieren muss.
Tilde-Notation und Kostenmodell
Statt der O-Notation, die nur eine obere Schranke angibt, verwenden die Autoren die Tilde-Notation: ~N²/2 bedeutet, dass der Aufwand für große N ungefähr N²/2 beträgt, einschließlich des konstanten Faktors. Das erlaubt genauere Vorhersagen. Gezählt wird nach einem Kostenmodell, etwa der Zahl der Array-Zugriffe oder Vergleiche.
Wachstumsordnungen
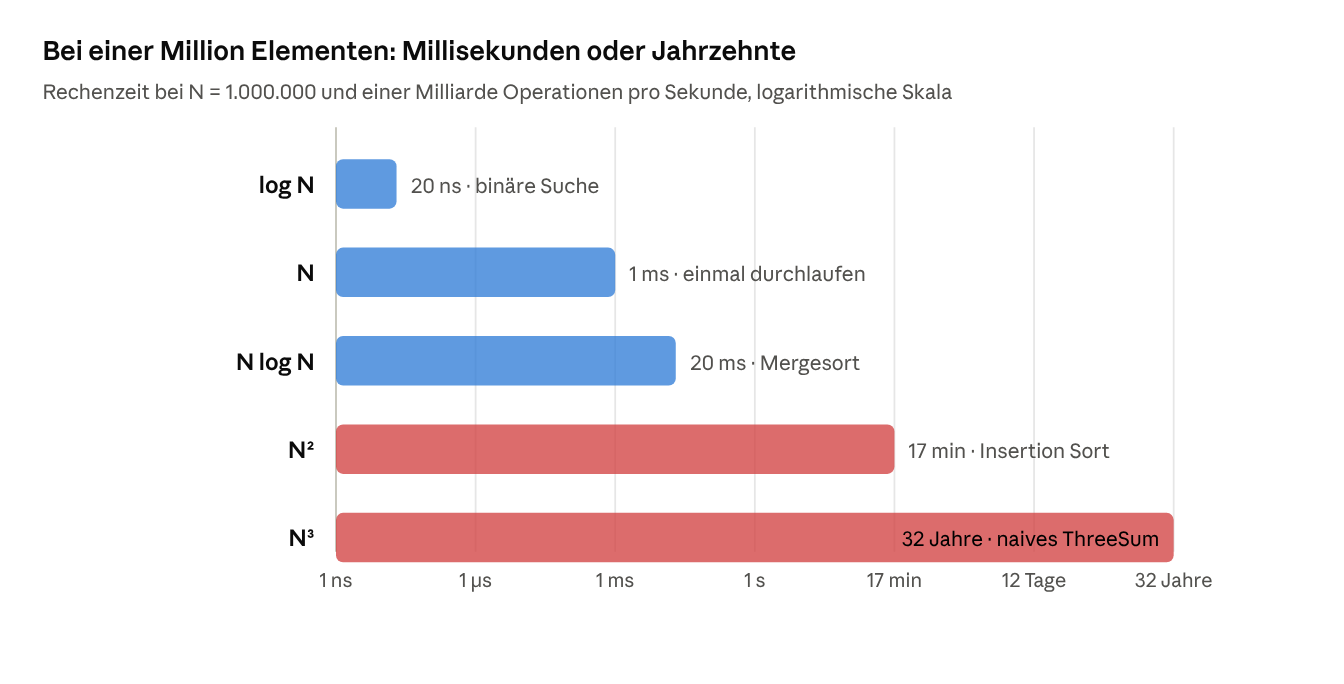
gerechnet für N = 10⁶ bei 10⁹ Operationen pro Sekunde; konstante Faktoren vernachlässigt
Der Unterschied zwischen N log N und N² ist bei einer Million Elementen der Unterschied zwischen einer Antwort, bevor man blinzelt, und einer Viertelstunde Warten. Bei N³ ist es ein Menschenleben. Kein schnellerer Rechner gleicht eine schlechtere Wachstumsordnung aus.
ThreeSum
Das durchgehende Beispiel des Kapitels: Wie viele Tripel in einer Liste von Zahlen ergeben zusammen null?
| Ansatz | Wachstumsordnung |
|---|---|
| Alle Tripel prüfen | N³ |
| Sortieren, dann für jedes Paar die dritte Zahl binär suchen | N² log N |
| Sortieren, dann mit zwei Zeigern von außen nach innen | N² |
Dasselbe Problem, drei Algorithmen, und für eine Million Zahlen der Unterschied zwischen Jahrzehnten und Minuten.
Speicher
Das Kapitel analysiert auch den Speicherbedarf in Java: Objekt-Kopf, Referenzen, Auffüllung auf Vielfache von acht Bytes. Ein Integer braucht ein Mehrfaches eines int; eine verkettete Liste mit N Elementen ein Vielfaches eines Arrays. Die genauen Zahlen hängen von der JVM ab, etwa von komprimierten Referenzen. Project Valhalla, an dem Goetz arbeitet, soll diesen Overhead für Wertklassen künftig verringern.
Einordnung
Das Verdopplungsexperiment ist das empirische Vorgehen, das McConnell und Accelerate auf Projekte anwenden, hier auf Code. Wer Leistungsprobleme vermutet, sollte zuerst messen, wie Goetz u.a. und Fowler empfehlen, heute mit JMH.
Fallstudie Union-Find
Das erste Kapitel endet mit einer Fallstudie, die das Vorgehen des ganzen Buchs zeigt: ein Problem, eine einfache Lösung, Analyse, eine bessere Lösung, wieder Analyse.
Das Problem
Dynamische Zusammenhangskomponenten: Gegeben sind N Objekte. Nach und nach werden Verbindungen zwischen Paaren gemeldet. Jederzeit soll man fragen können: Sind zwei Objekte, direkt oder über andere, verbunden? Anwendungen sind Netzwerke, soziale Beziehungen, Pixel in Bildern oder Kruskals Algorithmus für Spannbäume.
public interface UnionFind {
    void union(int p, int q);      // p und q verbinden
    int find(int p);               // Vertreter der Komponente von p
    boolean connected(int p, int q);
    int count();                   // Anzahl der Komponenten
}
Vier Lösungen
| Verfahren | Idee | union | find |
|---|---|---|---|
| Quick-Find | jedes Objekt speichert die ID seiner Komponente | N | 1 |
| Quick-Union | jedes Objekt zeigt auf einen Elternknoten; die Wurzel ist der Vertreter | Baumhöhe | Baumhöhe, im schlechtesten Fall N |
| Gewichtetes Quick-Union | der kleinere Baum wird unter den größeren gehängt | log N | log N |
| Mit Pfadkompression | beim Suchen werden Knoten direkt an die Wurzel gehängt | praktisch konstant | praktisch konstant |
public final class WeightedQuickUnionPC implements UnionFind {
    private final int[] parent, size;
    private int count;

    public WeightedQuickUnionPC(int n) {
        parent = new int[n]; size = new int[n]; count = n;
        for (int i = 0; i < n; i++) { parent[i] = i; size[i] = 1; }
    }

    public int find(int p) {
        while (p != parent[p]) {
            parent[p] = parent[parent[p]];   // Pfadhalbierung: Großelternteil
            p = parent[p];
        }
        return p;
    }

    public void union(int p, int q) {
        int rp = find(p), rq = find(q);
        if (rp == rq) return;
        if (size[rp] < size[rq]) { parent[rp] = rq; size[rq] += size[rp]; }   // klein unter groß
        else                     { parent[rq] = rp; size[rp] += size[rq]; }
        count--;
    }

    public boolean connected(int p, int q) { return find(p) == find(q); }
    public int count() { return count; }
}
Mit Gewichtung und Pfadkompression ist der Aufwand pro Operation so nahe an konstant, dass der Unterschied in der Praxis keine Rolle spielt; theoretisch wächst er mit der inversen Ackermann-Funktion, die für alle denkbaren Eingaben kleiner als fünf bleibt.
Die Lehre
Der Unterschied zwischen Quick-Find und der letzten Variante ist für Milliarden Objekte der Unterschied zwischen Jahrzehnten und Sekunden. Erreicht wird er nicht durch Mikrooptimierung, sondern durch zwei kleine Ideen: kleine Bäume unter große hängen und Pfade abkürzen. Das Buch nennt das als Grundmuster guter Algorithmenentwicklung.
Als Anwendung zeigt das Buch das Perkolationsproblem: Ab welchem Anteil offener Zellen gibt es in einem Gitter einen Weg von oben nach unten? Eine Monte-Carlo-Simulation mit Union-Find liefert einen Schwellwert von etwa 0,593, für den keine geschlossene Formel bekannt ist.
Sortieren
Sortieren ist das ausführlichste Kapitel, weil es alle Grundtechniken der Algorithmenanalyse an einem vertrauten Problem zeigt.
Die Verfahren im Überblick
| Verfahren | Vergleiche, ungefähr | Zusatzspeicher | Stabil | Bemerkung |
|---|---|---|---|---|
| Selection Sort | N²/2 | keiner | nein | unabhängig von der Eingabe immer gleich langsam |
| Insertion Sort | N²/4 im Mittel, N bei fast sortierten Daten | keiner | ja | sehr gut für kleine oder fast sortierte Arrays |
| Shellsort | deutlich unter N², genaue Analyse offen | keiner | nein | einfach und überraschend schnell für mittlere N |
| Mergesort | N log N | N | ja | garantierte Laufzeit |
| Quicksort | etwa 1,39 N log N im Mittel | log N für den Stack | nein | in der Praxis meist am schnellsten |
| Heapsort | etwa 2 N log N | keiner | nein | garantiert N log N ohne Zusatzspeicher, aber schlechte Cache-Nutzung |
Das Buch beweist außerdem eine untere Schranke: Jedes Sortierverfahren, das nur Vergleiche verwendet, braucht im schlechtesten Fall mindestens etwa N log N Vergleiche. Mergesort ist in diesem Sinne optimal.
Quicksort
Quicksort, Sedgewicks Promotionsthema, bekommt besondere Aufmerksamkeit. Wichtige Details:
- Vorher zufällig mischen, damit sortierte Eingaben nicht zum quadratischen schlechtesten Fall führen.
- Kleine Teilarrays mit Insertion Sort sortieren, weil der Aufwand des Partitionierens sich dort nicht lohnt.
- Dreiwege-Partitionierung nach Dijkstra für Daten mit vielen gleichen Schlüsseln: kleiner, gleich, größer. Damit wird Quicksort bei vielen Duplikaten sogar linear.
// Quicksort mit Dreiwege-Partitionierung
public static <T extends Comparable<T>> void sort(T[] a, int lo, int hi) {
    if (hi <= lo + 10) { insertionSort(a, lo, hi); return; }
    int lt = lo, gt = hi, i = lo + 1;
    T v = a[lo];
    while (i <= gt) {
        int cmp = a[i].compareTo(v);
        if      (cmp < 0) swap(a, lt++, i++);
        else if (cmp > 0) swap(a, i, gt--);
        else              i++;
    }
    sort(a, lo, lt - 1);      // kleiner als v
    sort(a, gt + 1, hi);      // größer als v; die Gleichen bleiben in der Mitte
}
Prioritätswarteschlangen
Eine Prioritätswarteschlange liefert immer das größte oder kleinste Element. Die Implementierung als binärer Heap in einem Array erlaubt Einfügen und Entnehmen in log N. Heapsort ergibt sich daraus fast von selbst. Das Buch zeigt außerdem indizierte Prioritätswarteschlangen, die später für Dijkstra und Prim gebraucht werden.
Was Java tatsächlich verwendet
Interessant für Java-Entwickler: Das JDK nutzt zwei verschiedene Verfahren.
| Aufruf | Verfahren | Grund |
|---|---|---|
Arrays.sort(int[]) und andere primitive Typen | Dual-Pivot-Quicksort nach Yaroslavskiy | schnell; Stabilität ist bei Primitiven bedeutungslos |
Arrays.sort(Object[]), List.sort, Collections.sort | TimSort, ein Mergesort-Abkömmling | stabil; nutzt vorhandene Ordnung in den Daten |
PriorityQueue | binärer Heap | wie im Buch |
Die Stabilität ist für Objekte wichtig: Wer eine Liste von Bestellungen erst nach Datum und dann nach Kunde sortiert, erwartet, dass innerhalb eines Kunden die Datumsreihenfolge erhalten bleibt. Comparator.comparing(...).thenComparing(...) macht das explizit.
Suchen
Symboltabellen
Eine Symboltabelle speichert Schlüssel-Wert-Paare: in Java eine Map. Das Buch unterscheidet zwei APIs:
- Einfache Symboltabelle:
put,get,delete,contains. - Geordnete Symboltabelle: zusätzlich
min,max,floor,ceiling,rank,selectund Bereichsabfragen. Das entspricht JavasNavigableMap, die McConnell-Zusammenfassung für tabellengesteuerte Methoden genutzt hat.
Implementierungen im Vergleich
| Implementierung | Suchen | Einfügen | Geordnet | Bemerkung |
|---|---|---|---|---|
| Unsortierte verkettete Liste | N | N | nein | nur für sehr kleine Tabellen |
| Sortiertes Array mit binärer Suche | log N | N | ja | gut, wenn selten eingefügt wird |
| Binärer Suchbaum | log N im Mittel, N im schlechtesten Fall | wie Suchen | ja | sortierte Eingaben erzeugen eine lineare Kette |
| Rot-Schwarz-Baum | garantiert log N | garantiert log N | ja | Standard für geordnete Maps |
| Hashtabelle | konstant im Mittel | konstant im Mittel | nein | Standard für ungeordnete Maps |
Balancierte Bäume
Der Abschnitt über balancierte Bäume ist besonders gelungen, weil er die oft gefürchteten Rot-Schwarz-Bäume über einen Umweg verständlich macht:
- 2-3-Bäume: Knoten haben einen oder zwei Schlüssel und zwei oder drei Kinder. Beim Einfügen wird ein überfüllter Knoten geteilt, und der mittlere Schlüssel wandert nach oben. Der Baum wächst nur an der Wurzel und ist deshalb immer perfekt balanciert.
- Linkslastige Rot-Schwarz-Bäume: Ein 2-3-Baum wird als gewöhnlicher binärer Suchbaum dargestellt, bei dem „rote“ Kanten zwei Knoten zu einem 3-Knoten verbinden. Sedgewick hat diese Variante 2008 vorgestellt; sie braucht deutlich weniger Code als klassische Rot-Schwarz-Bäume.
Hashtabellen
Zwei Strategien für Kollisionen:
- Verkettung: Jeder Platz enthält eine Liste der Einträge mit gleichem Hashwert.
- Lineares Sondieren: Bei einer Kollision wird der nächste freie Platz genutzt; die Tabelle muss deutlich größer sein als die Zahl der Einträge.
Die Leistung hängt an einer guten Hashfunktion. Das Buch erklärt, warum hashCode und equals zusammenpassen müssen, genau wie Bloch in Items 10 und 11.
Was Java verwendet
| Klasse | Struktur |
|---|---|
TreeMap, TreeSet | Rot-Schwarz-Baum |
HashMap, HashSet | Verkettung; seit Java 8 werden lange Ketten ab einer Schwelle in kleine Rot-Schwarz-Bäume umgewandelt, damit schlechte Hashwerte nicht zu linearer Suche führen |
LinkedHashMap | Hashtabelle plus verkettete Liste für die Einfügereihenfolge |
ConcurrentHashMap | Verkettung mit feingranularer Synchronisation, wie in der JCiP-Zusammenfassung beschrieben |
IdentityHashMap | lineares Sondieren |
Die Umwandlung langer Ketten in Bäume ist auch eine Abwehr gegen Angriffe, bei denen jemand absichtlich viele Schlüssel mit gleichem Hashwert schickt.
Graphen
Graphen sind für viele Leser der Teil des Buchs mit dem größten praktischen Nutzen, weil erstaunlich viele Probleme Graphenprobleme sind, wenn man genau hinsieht. Das Buch stellt sie in vier Abschnitten vor, alle mit Adjazenzlisten als Darstellung.
Ungerichtete Graphen
| Problem | Lösung |
|---|---|
| Gibt es einen Weg von s nach t? | Tiefensuche |
| Was ist der kürzeste Weg, gemessen in Kanten? | Breitensuche |
| Welche Knoten hängen zusammen? | Zusammenhangskomponenten per Tiefensuche |
| Gibt es einen Kreis? Ist der Graph bipartit? | Varianten der Tiefensuche |
Ein schönes Beispiel: Grade der Trennung, also wie viele Schritte zwei Schauspieler über gemeinsame Filme voneinander entfernt sind, per Breitensuche auf einem Graphen aus einer Filmdatenbank.
Gerichtete Graphen
| Problem | Lösung |
|---|---|
| Welche Knoten sind von s aus erreichbar? | Tiefensuche |
| In welcher Reihenfolge lassen sich Aufgaben mit Abhängigkeiten ausführen? | Topologische Sortierung: umgekehrte Postorder der Tiefensuche |
| Gibt es einen gerichteten Kreis? | Tiefensuche mit Markierung des aktuellen Pfads |
| Welche Knoten erreichen sich gegenseitig? | Starke Zusammenhangskomponenten nach Kosaraju und Sharir |
// Topologische Sortierung: umgekehrte Postorder der Tiefensuche
public static List<Integer> topologicalOrder(Digraph g) {
    var visited = new boolean[g.vertices()];
    var order = new ArrayDeque<Integer>();
    for (int v = 0; v < g.vertices(); v++)
        if (!visited[v]) dfs(g, v, visited, order);
    return List.copyOf(order);
}

private static void dfs(Digraph g, int v, boolean[] visited, Deque<Integer> order) {
    visited[v] = true;
    for (int w : g.adj(v)) if (!visited[w]) dfs(g, w, visited, order);
    order.push(v);                                 // erst nach allen Nachfolgern
}
Das klingt abstrakt, steckt aber in alltäglichen Werkzeugen: Gradle und Maven ordnen Aufgaben und Module topologisch, Spring ordnet die Initialisierung von Beans nach Abhängigkeiten, und wenn ArchUnit oder JDepend Zyklen zwischen Paketen melden, haben sie starke Zusammenhangskomponenten mit mehr als einem Knoten gefunden. Martins Acyclic Dependencies Principle ist eine Aussage über diese Graphen.
Minimale Spannbäume
Ein minimaler Spannbaum verbindet alle Knoten eines gewichteten Graphen mit minimalen Gesamtkosten, etwa beim Verlegen von Leitungen. Beide Verfahren des Buchs beruhen auf derselben Schnitteigenschaft: Die leichteste Kante über jeden Schnitt gehört zum Spannbaum.
- Prim: Der Baum wächst von einem Startknoten aus, immer um die leichteste Kante nach außen; mit einer Prioritätswarteschlange.
- Kruskal: Kanten werden nach Gewicht sortiert und hinzugefügt, wenn sie keinen Kreis bilden; Kreise erkennt man mit Union-Find aus der Fallstudie.
Kürzeste Wege
| Verfahren | Voraussetzung | Wachstumsordnung |
|---|---|---|
| Dijkstra | keine negativen Gewichte | E log V |
| Topologische Reihenfolge | kreisfreier Graph; negative Gewichte erlaubt | E + V |
| Bellman-Ford | keine negativen Kreise | im schlechtesten Fall E·V |
Die Variante für kreisfreie Graphen findet auch längste Wege, und damit den kritischen Pfad in der Projektplanung, ein Thema, das Brooks‘ Zeitplankapitel berührt. Bellman-Ford erkennt negative Kreise; das Buch zeigt damit, wie man Arbitrage bei Wechselkursen aufspürt.
Strings
Das fünfte Kapitel behandelt Algorithmen, die die besondere Struktur von Zeichenketten ausnutzen, statt sie nur als vergleichbare Objekte zu behandeln.
String-Sortierung
| Verfahren | Idee | Einsatz |
|---|---|---|
| Schlüsselindiziertes Zählen | Häufigkeiten zählen, Startpositionen berechnen, verteilen | Grundbaustein; linear für kleine Schlüsselbereiche |
| LSD-Radixsort | Zeichen von rechts nach links, jeweils stabil sortieren | Schlüssel gleicher Länge, etwa Kennzeichen oder Postleitzahlen |
| MSD-Radixsort | Zeichen von links nach rechts, rekursiv | Strings unterschiedlicher Länge |
| Dreiwege-String-Quicksort | Quicksort, aber auf einzelnen Zeichen partitioniert | lange gemeinsame Präfixe, etwa URLs |
Radix-Verfahren unterlaufen die untere Schranke von N log N, weil sie nicht nur vergleichen, sondern die Zeichen direkt verwenden.
Tries
Ein Trie speichert Strings als Baum, in dem jeder Knoten ein Zeichen darstellt. Suchen kostet höchstens so viele Schritte, wie der Schlüssel Zeichen hat, unabhängig von der Zahl der gespeicherten Schlüssel. Tries unterstützen außerdem Präfixabfragen, etwa für Autovervollständigung. Das Buch zeigt R-Wege-Tries, schnell aber speicherhungrig, und ternäre Suchtries, platzsparender.
Teilstringsuche
| Verfahren | Idee |
|---|---|
| Brute Force | jede Position prüfen; im schlechtesten Fall M·N, in der Praxis oft gut |
| Knuth-Morris-Pratt | ein endlicher Automat merkt sich, wie viel schon passt; liest den Text nie zurück |
| Boyer-Moore | Muster von rechts vergleichen und bei Fehlschlag weit springen; sublinear in der Praxis |
| Rabin-Karp | Hashwert eines gleitenden Fensters mit dem des Musters vergleichen |
Reguläre Ausdrücke
Das Buch implementiert reguläre Ausdrücke über einen nichtdeterministischen endlichen Automaten nach Thompson. Die Laufzeit wächst garantiert nur linear mit der Textlänge mal der Musterlänge.
Das ist für Java-Entwickler eine wichtige Einsicht, weil java.util.regex anders arbeitet: Es verwendet Backtracking. Das erlaubt mehr Funktionen, etwa Rückverweise, kann aber bei ungünstigen Mustern exponentiell langsam werden. Angreifer nutzen das für Denial-of-Service-Angriffe, bekannt als ReDoS.
// Exponentielles Backtracking in java.util.regex
Pattern p = Pattern.compile("(a+)+b");
p.matcher("a".repeat(30)).matches();          // kann sehr lange dauern: kein b, viele Zerlegungen

// Abhilfen: einfachere Muster, Possessive Quantifier, Eingabelänge begrenzen
Pattern safe = Pattern.compile("a++b");      // possessiv: kein Zurückgehen
Bibliotheken wie RE2/J, eine Java-Portierung von Googles RE2, arbeiten automatenbasiert wie im Buch und schließen dieses Problem aus.
Kompression
| Verfahren | Idee |
|---|---|
| Lauflängenkodierung | Wiederholungen als Anzahl speichern; gut für Bitmaps |
| Huffman | häufige Zeichen erhalten kurze Codes; optimal für Präfixcodes |
| LZW | wiederkehrende Teilstrings werden in einem Wörterbuch gesammelt und durch Codes ersetzt |
Das Buch beweist außerdem, dass es keinen Kompressionsalgorithmus geben kann, der jede Eingabe verkleinert. Die Verfahren in GZIP, ZIP oder PNG sind Kombinationen dieser Grundideen.
Kontext
Das letzte Kapitel zeigt, wie die Algorithmen des Buchs in größeren Zusammenhängen auftauchen, und führt an die Grenzen des Berechenbaren.
| Thema | Inhalt | Bezug |
|---|---|---|
| Ereignisgesteuerte Simulation | Teilchenkollisionen werden mit einer Prioritätswarteschlange von Ereignissen simuliert statt in festen Zeitschritten | dasselbe Prinzip wie Timer-Warteschlangen und Scheduler |
| B-Bäume | Bäume mit sehr vielen Schlüsseln pro Knoten, damit jeder Zugriff auf langsamen Speicher möglichst viel liefert | Grundlage fast aller Datenbankindizes, wie Kleppmann beschreibt |
| Suffix-Arrays | sortierte Liste aller Suffixe eines Textes; erlaubt schnelle Suche nach Teilstrings und längsten Wiederholungen | Textsuche, Bioinformatik |
| Netzwerkflüsse | maximaler Fluss und minimaler Schnitt nach Ford-Fulkerson | Planung, Zuordnungsprobleme |
| Reduktion | ein Problem durch Umwandlung in ein anderes lösen | gemeinsames Werkzeug hinter vielen Algorithmen |
| Unlösbarkeit | NP-vollständige Probleme, P gegen NP | Grenzen dessen, was effizient lösbar ist |
Reduktion
Reduktion ist das vielleicht mächtigste Denkwerkzeug des Kapitels: Wer erkennt, dass ein neues Problem eigentlich ein bekanntes ist, bekommt die Lösung geschenkt. Beispiele aus dem Buch: Den Median findet man durch Sortieren; Planung mit Abhängigkeiten ist topologisches Sortieren; viele Optimierungsprobleme sind lineare Programmierung. Das ist die Algorithmen-Version von Musterkatalogen: einen Namen für ein Problem zu haben, ist oft schon der halbe Weg.
Unlösbarkeit
Das Buch schließt mit einem kurzen Überblick über NP-Vollständigkeit: Für Probleme wie das Erfüllbarkeitsproblem, das Problem des Handlungsreisenden oder die optimale Einteilung ist kein effizienter Algorithmus bekannt, und wenn einer existierte, gäbe es ihn für alle zugleich. Die praktische Lehre: Wer ein solches Problem erkennt, sucht nicht weiter nach einer exakten effizienten Lösung, sondern nach Näherungen, Heuristiken oder Einschränkungen der Eingabe.
Einordnung
Die B-Bäume schlagen die Brücke zu Kleppmanns Speicherkapitel, das B-Bäume mit LSM-Bäumen vergleicht. Netzwerkflüsse und lineare Programmierung führen in die Optimierung, die bei den KI-Büchern wieder auftaucht.
Was Java heute mitbringt
Im Alltag implementiert kaum jemand Rot-Schwarz-Bäume oder Heaps selbst. Der Wert des Buchs liegt darin, zu verstehen, was die Bibliotheken tun und wann man welche Struktur wählt.
| Aufgabe | Im Buch | Im JDK oder verbreiteten Bibliotheken |
|---|---|---|
| Stack, Queue | größenveränderliches Array, verkettete Liste | ArrayDeque; nicht Stack |
| Liste | Array, verkettete Liste | ArrayList; LinkedList fast nie |
| Sortieren | Mergesort, Quicksort | TimSort, Dual-Pivot-Quicksort |
| Prioritätswarteschlange | binärer Heap | PriorityQueue |
| Geordnete Map | Rot-Schwarz-Baum | TreeMap, ConcurrentSkipListMap |
| Ungeordnete Map | Hashtabelle | HashMap, ConcurrentHashMap |
| Union-Find | gewichtet mit Pfadkompression | nicht im JDK; selbst schreiben, es sind 30 Zeilen |
| Graphen | Adjazenzlisten | nicht im JDK; JGraphT oder Guava graph |
| Teilstringsuche | KMP, Boyer-Moore | String.indexOf, in der JVM stark optimiert |
| Reguläre Ausdrücke | NFA nach Thompson | java.util.regex mit Backtracking; RE2/J automatenbasiert |
Die Messungen des Buchs gelten mit Vorsicht: Moderne CPUs mit Caches bevorzugen zusammenhängenden Speicher. Deshalb ist ArrayList fast immer schneller als LinkedList, auch bei Operationen, bei denen die Wachstumsordnung für die verkettete Liste spricht. Das Buch erwähnt Speicherhierarchien, misst aber vor allem Operationen. Wer heute vergleicht, nutzt JMH.
Kritik und Einordnung
Stärken
- Echter Code: Jeder Algorithmus ist vollständig in Java implementiert, getestet und frei verfügbar.
- Wissenschaftliches Vorgehen: Hypothese, Experiment, Analyse statt nur Beweise.
- Hervorragende Grafiken: Die Visualisierungen von Sortierverfahren, Bäumen und Graphen gehören zu den besten in Lehrbüchern.
- Praxisnähe: Anwendungen aus Physik, Biologie, Finanzwesen und Netzwerken.
- Begleitmaterial: Website, Bibliothek und frei zugängliche Online-Kurse.
Kritikpunkte
1. Eigenes Ökosystem. Der Code verwendet die Bibliothek algs4 mit eigenen Klassen wie StdIn, StdOut und eigenen Collections statt der Standardbibliothek. Für das Lernen ist das konsequent, für die Übertragung in Projekte etwas umständlich.
2. Altes Java. Der Code entspricht Java 6: keine Lambdas, keine Streams, keine Records, Generics mit Arrays über unchecked Casts. Die Algorithmen gelten unverändert, der Stil ist überholt.
3. Lücken. Dynamische Programmierung, die in vielen Algorithmenkursen ein Kernthema ist, kommt kaum vor. Ebenso fehlen probabilistische Datenstrukturen wie Bloom-Filter und HyperLogLog, die in verteilten Systemen wichtig sind.
4. Wenig über Hardware. Cache-Effekte, Parallelität und SIMD bestimmen heute oft mehr als die Zahl der Vergleiche.
5. Umfang. Fast 1000 Seiten; als Nachschlagewerk gut, zum Durchlesen schwer.
Gesamturteil
Für Java-Entwickler ist es das zugänglichste Algorithmenbuch: verständlich, gründlich, mit Code, den man ausführen kann. Wer es durcharbeitet, versteht, was hinter TreeMap, HashMap, Collections.sort und PriorityQueue steckt, erkennt Graphenprobleme im eigenen Code und weiß, wann eine Wachstumsordnung ein System zum Stillstand bringt. Wer tiefer in Theorie und dynamische Programmierung will, ergänzt es mit Cormen u.a. oder Kleinberg und Tardos.
Bezüge zur Reihe
| Thema bei Sedgewick und Wayne | Bezug in der Reihe |
|---|---|
| API zuerst, Implementierung dahinter | Ousterhout: tiefe Module; Parnas; Bloch: Schnittstellen bevorzugen |
| Veraltete Referenzen vermeiden | Bloch, Item 7 |
hashCode und equals | Bloch, Items 10 und 11 |
| Messen statt vermuten | McConnell: Empirie; Goetz u.a.: erst messen, dann optimieren |
| Wachstumsordnung schlägt Hardware | Brooks: kein Wundermittel; Kleppmann: Skalierbarkeit |
| Rot-Schwarz-Bäume, Hashtabellen | TreeMap, HashMap; Goetz u.a.: ConcurrentHashMap |
| B-Bäume | Kleppmann: Speicher-Engines, B-Bäume gegen LSM-Bäume |
| Zyklen in gerichteten Graphen | Martin: Acyclic Dependencies Principle; Fitness Functions mit ArchUnit |
| Topologische Sortierung | Build-Werkzeuge; Brooks: Zeitplanung und kritischer Pfad |
| Union-Find | Kruskal; Zusammenhangskomponenten in Netzen |
| Prioritätswarteschlangen | Goetz u.a.: PriorityBlockingQueue; SRE: Kritikalität bei Überlast |
| Reguläre Ausdrücke, Backtracking | Nygard: Antipatterns, die unter Last kippen; Sicherheit |
| Reduktion | Gang of Four, EIP: Muster als Namen für wiederkehrende Probleme |
| Funktionale Varianten | Weidig: Rekursion, unveränderliche Datenstrukturen |
Diskussionsfragen
- Wachstumsordnung im Alltag: Wo hat in deinen Projekten eine quadratische Stelle ein System ausgebremst, etwa eine verschachtelte Schleife über zwei Listen oder
List.containsin einer Schleife? - Collections: Wann hast du zuletzt bewusst zwischen
ArrayList,LinkedList,ArrayDeque,HashMapundTreeMapgewählt? Nach welchem Kriterium? - Graphen: Welche Probleme in eurem Code sind eigentlich Graphenprobleme: Abhängigkeiten, Freigabeketten, Berechtigungen, Routen?
- Reguläre Ausdrücke: Prüft ihr Benutzereingaben mit regulären Ausdrücken? Sind die Muster gegen exponentielles Backtracking gesichert?
- Messen: Wie verifiziert ihr Leistungsannahmen, mit JMH, Profilern oder Bauchgefühl?
- Interviews: Algorithmenaufgaben sind in Bewerbungsgesprächen umstritten. Wie viel Algorithmenwissen braucht ein Java-Entwickler im Alltag wirklich?
- KI-Werkzeuge: Wenn ein Assistent eine Datenstruktur vorschlägt, wie prüfst du, ob die Wachstumsordnung stimmt?
- Weiter: Damit sind es 31 Bücher. Als Nächstes die KI-Reihe mit Chip Huyens AI Engineering, oder noch ein klassisches Buch?