AI Engineering – Zusammenfassung und Einordnung
Chip Huyen, AI Engineering: Building Applications with Foundation Models (2025)
Einleitung
Mit diesem Buch beginnt die KI-Reihe. AI Engineering ist kein Buch darüber, wie man Sprachmodelle trainiert, sondern darüber, wie man mit bereits vorhandenen Modellen Anwendungen baut, die zuverlässig funktionieren. Für Entwickler, die aus der klassischen Softwareentwicklung kommen, ist es der naheliegende Einstieg: Viele Themen, Architektur, Tests, Betrieb, Kosten, Leistung, kennen sie bereits, nur in neuer Form.
Autorin und Kontext
Chip Huyen hat an der Stanford University Machine Learning Systems Design gelehrt und bei NVIDIA, Snorkel AI und in eigenen Start-ups an ML-Infrastruktur gearbeitet. Ihr vorheriges Buch Designing Machine Learning Systems (2022) steht ebenfalls auf unserer Liste. AI Engineering erschien im Januar 2025 bei O’Reilly, umfasst rund 530 Seiten und ist inzwischen in mehrere Sprachen übersetzt. Eine zweite Auflage gibt es bisher nicht.
Die Kernthese
Seit es leistungsfähige Foundation Models gibt, also große, allgemein vortrainierte Modelle wie GPT, Claude, Gemini oder Llama, hat sich die Arbeit verschoben: Statt eigene Modelle zu trainieren, nutzen die meisten Teams vorhandene Modelle und passen sie an. Daraus ist eine neue Disziplin entstanden, die Huyen AI Engineering nennt. Ihre größte Herausforderung ist nicht das Modell, sondern die Bewertung: Wie weiß man, ob eine Anwendung, deren Ausgaben offen und nicht deterministisch sind, gut funktioniert?
Aufbau
| Kapitel | Thema |
|---|---|
| 1 | Einführung: Anwendungen mit Foundation Models bauen |
| 2 | Foundation Models verstehen: Training, Architektur, Nachtraining, Sampling |
| 3 | Evaluationsmethoden |
| 4 | KI-Systeme bewerten: Kriterien, Modellauswahl, Evaluationspipeline |
| 5 | Prompt Engineering |
| 6 | RAG und Agenten |
| 7 | Finetuning |
| 8 | Dataset Engineering |
| 9 | Inferenz optimieren |
| 10 | Architektur und Nutzerfeedback |
Das Buch ist weitgehend unabhängig von bestimmten Werkzeugen und Programmiersprachen geschrieben. Die Java-Beispiele in dieser Zusammenfassung verwenden Spring AI 2.x, das auf Spring Boot 4 und Java 21 aufsetzt; die Konzepte gelten genauso für LangChain4j oder direkte API-Aufrufe.
Was AI Engineering ist
Von ML Engineering zu AI Engineering
Huyen grenzt die neue Disziplin vom klassischen Machine Learning Engineering ab:
| ML Engineering | AI Engineering | |
|---|---|---|
| Ausgangspunkt | eigenes Modell auf eigenen Daten trainieren | vorhandenes Foundation Model nutzen und anpassen |
| Schwerpunkt | Modellentwicklung, Feature Engineering | Anpassung: Prompts, Kontext, Finetuning, Evaluation |
| Modellgröße | oft klein, günstig zu betreiben | sehr groß; Kosten und Latenz sind zentrale Themen |
| Ausgaben | meist geschlossen: Klasse, Zahl, Ja oder Nein | meist offen: Text, Bilder, Code |
| Bewertung | gegen bekannte richtige Antworten | schwierig, weil es oft viele richtige Antworten gibt |
Der Stack
Huyen beschreibt drei Schichten, auf denen AI Engineering stattfindet:
| Schicht | Aufgaben |
|---|---|
| Anwendungsentwicklung | Benutzeroberfläche, Prompts, Kontext bereitstellen, Evaluation |
| Modellentwicklung | Finetuning, Dataset Engineering, Inferenzoptimierung |
| Infrastruktur | Modelle bereitstellen, Daten und Rechenleistung verwalten, überwachen |
Die meisten Teams arbeiten vor allem in der obersten Schicht, und diese Schicht hat sich am stärksten verändert. Für Entwickler aus der klassischen Softwareentwicklung ist sie am leichtesten zugänglich.
Typische Anwendungen
Das Buch nennt unter anderem: Programmierunterstützung, Texterstellung, Bild- und Videoerzeugung, Bildung, Chatbots, Zusammenfassung und Informationssuche, Datenstrukturierung aus unstrukturierten Dokumenten und Automatisierung von Arbeitsabläufen.
Planen: Sollte man das bauen?
Bevor man eine KI-Anwendung baut, rät Huyen zu einigen Fragen:
- Warum? Aus Angst, den Anschluss zu verlieren, weil es eine Chance gibt, oder weil man es noch nicht weiß und lernen will.
- Welche Rolle spielt die KI? Ist sie entscheidend für das Produkt oder ergänzend? Reagiert sie auf Anfragen oder wird sie von sich aus aktiv? Muss sie sich laufend anpassen oder bleibt sie gleich?
- Welche Rolle spielen Menschen? Prüfen sie jede Ausgabe, nur manche oder keine?
- Wie verteidigt man sich? Wenn ein Produkt nur eine dünne Schicht über einem öffentlich verfügbaren Modell ist, kann der Modellanbieter es leicht nachbauen.
Die letzte Meile
Eine wichtige Warnung: Mit Foundation Models ist es leicht, eine beeindruckende Vorführung zu bauen, aber schwer, ein zuverlässiges Produkt. Huyen beschreibt Teams, die in wenigen Wochen achtzig Prozent einer Lösung hatten und dann Monate brauchten, um die letzten Prozent zu erreichen. Das ist die Falle der letzten zehn Prozent, die Ford und Kollegen in Building Evolutionary Architectures beschreiben, in neuer Gestalt.
Foundation Models verstehen
Das zweite Kapitel erklärt, wie Modelle entstehen, so weit, wie man es zum Bauen von Anwendungen braucht.
Trainingsdaten
Ein Modell kann nur, was in seinen Daten vorkommt. Huyen betont, dass die meisten großen Modelle überwiegend mit englischen Internettexten trainiert wurden; Leistung in anderen Sprachen und Fachgebieten ist oft schwächer. Wer etwa deutsche Versicherungstexte verarbeitet, sollte das gezielt prüfen.
Architektur und Größe
Die meisten heutigen Sprachmodelle beruhen auf der Transformer-Architektur mit dem Aufmerksamkeitsmechanismus, der für jedes Wort gewichtet, welche anderen Wörter wichtig sind. Ihre Leistung hängt von drei Größen ab: Zahl der Parameter, Zahl der Trainings-Tokens und eingesetzte Rechenleistung. Sogenannte Skalierungsgesetze beschreiben, wie man diese Größen bei festem Budget verteilen sollte. Huyen weist auf Grenzen hin: hochwertige Trainingsdaten werden knapp, und Strom und Rechenzentren begrenzen das Wachstum.
Nachtraining
Ein vortrainiertes Modell kann Text fortsetzen, ist aber noch kein hilfreicher Assistent. Zwei Schritte machen es dazu:
| Schritt | Inhalt |
|---|---|
| Überwachtes Finetuning | das Modell lernt an Beispielen von Anweisungen und guten Antworten, wie ein Gespräch funktioniert |
| Präferenz-Finetuning | das Modell lernt, welche von mehreren Antworten Menschen bevorzugen; bekannte Verfahren sind RLHF und DPO |
Sampling
Ein Sprachmodell berechnet für jedes nächste Token eine Wahrscheinlichkeitsverteilung. Wie daraus ein Token gewählt wird, bestimmt den Charakter der Ausgabe:
| Verfahren | Wirkung |
|---|---|
| Greedy | immer das wahrscheinlichste Token; deterministisch, aber oft eintönig |
| Temperatur | niedrig: vorhersagbar; hoch: kreativ und unberechenbar |
| Top-k, Top-p | nur aus den wahrscheinlichsten Kandidaten wählen |
| Mehrere Ausgaben | mehrere Antworten erzeugen und die beste auswählen, etwa per Bewertung oder Mehrheit |
Strukturierte Ausgaben
Viele Anwendungen brauchen Ausgaben in festem Format, etwa JSON. Huyen nennt vier Wege: im Prompt verlangen, nachträglich korrigieren, das Sampling auf gültige Formate beschränken, oder das Modell darauf feintunen. Heute bieten die meisten Anbieter eingebaute Unterstützung.
// Strukturierte Ausgabe mit Spring AI: Antwort direkt als Record
record ClaimAssessment(String category, int severity, boolean fraudSuspected, String reason) {}

ClaimAssessment result = chatClient.prompt()
    .system("Du bewertest Schadensmeldungen einer Hausratversicherung.")
    .user(u -> u.text("Bewerte diese Meldung: {text}").param("text", claimText))
    .options(ChatOptions.builder().temperature(0.0).build())   // möglichst konsistent
    .call()
    .entity(ClaimAssessment.class);
Die Folgen der Wahrscheinlichkeit
Weil Modelle Wahrscheinlichkeiten berechnen, haben sie zwei typische Schwächen:
- Inkonsistenz: Dieselbe Frage kann unterschiedliche Antworten liefern.
- Halluzination: Das Modell erzeugt überzeugend klingende, aber falsche Aussagen. Huyen beschreibt Erklärungsansätze, etwa dass das Modell eigene frühere Ausgaben nicht von Fakten unterscheiden kann.
Für Entwickler heißt das: Ausgaben von Sprachmodellen sind wie Eingaben von Nutzern zu behandeln, also zu prüfen, bevor man ihnen vertraut. Das ist Nygards Rat zu Integrationspunkten, angewandt auf eine neue Art von Fremdsystem.
Evaluation
Zwei Kapitel widmet Huyen der Evaluation, und sie nennt sie die größte Herausforderung des AI Engineering. Wer nicht messen kann, ob eine Anwendung gut ist, kann sie nicht verbessern, nicht sicher ändern und nicht verantworten.
Warum es schwer ist
- Offene Ausgaben: Für „Fasse diesen Vertrag zusammen“ gibt es viele gute Antworten.
- Fähigere Modelle sind schwerer zu prüfen: Ob eine Zusammenfassung eines Fachtextes korrekt ist, kann oft nur ein Fachmann beurteilen.
- Öffentliche Benchmarks sind schnell ausgereizt und oft in den Trainingsdaten enthalten, also kontaminiert.
Methoden
| Methode | Inhalt | Eignung |
|---|---|---|
| Sprachmodell-Metriken | Entropie, Perplexität: wie gut ein Modell Text vorhersagt | vor allem für Modellentwickler |
| Exakte Bewertung | funktionale Korrektheit, etwa Code ausführen und Tests prüfen; exakter Vergleich mit Referenzantworten | wo eine richtige Antwort feststeht |
| Ähnlichkeit zur Referenz | lexikalisch oder semantisch, etwa über Embeddings | wo es gute Referenzantworten gibt |
| KI als Richter | ein Modell bewertet die Ausgaben eines anderen nach festgelegten Kriterien | offene Aufgaben; weit verbreitet |
| Vergleichende Bewertung | zwei Antworten nebeneinander, Mensch oder Modell wählt die bessere | Modellauswahl, Ranglisten |
KI als Richter
Diese Methode ist mächtig und verbreitet, hat aber Grenzen, die Huyen ausführlich beschreibt: Richter-Modelle sind inkonsistent, bevorzugen manchmal eigene Ausgaben oder längere Antworten, reagieren auf die Reihenfolge, in der Antworten präsentiert werden, und ihre Bewertung hängt stark vom Prompt ab. Man sollte Richter daher selbst prüfen, etwa indem man ihre Urteile mit menschlichen Urteilen vergleicht.
Kriterien
| Kriterium | Frage |
|---|---|
| Fachliche Fähigkeit | Kann das Modell die Aufgabe überhaupt, etwa SQL schreiben oder Verträge lesen? |
| Faktentreue | Stimmen die Aussagen mit den Quellen überein? |
| Sicherheit | Erzeugt es schädliche, beleidigende oder vertrauliche Inhalte? |
| Befolgen von Anweisungen | Hält es Format, Länge, Sprache und Einschränkungen ein? |
| Kosten und Latenz | Ist es schnell und günstig genug für den Einsatz? |
Eine Evaluationspipeline
Huyens Rat für die Praxis:
- Alle Komponenten bewerten, nicht nur das Endergebnis: Abruf, Prompt, Modell, Nachverarbeitung.
- Eine Bewertungsrichtlinie schreiben: Was ist eine gute, was eine schlechte Antwort, mit Beispielen.
- Methoden und Daten festlegen: eigene Testfälle aus echten Anfragen, aufgeteilt nach Nutzergruppen und Themen.
- Die Evaluation selbst prüfen: Stimmen die Ergebnisse mit menschlichen Urteilen überein? Sind sie stabil?
// Evaluationsfälle wie Regressionstests: feste Eingaben, geprüfte Erwartungen
@ParameterizedTest
@CsvFileSource(resources = "/eval/claims.csv", numLinesToSkip = 1)
void categorizesClaimsCorrectly(String claimText, String expectedCategory) {
    var result = assessor.assess(claimText);
    assertThat(result.category()).isEqualTo(expectedCategory);      // exakte Bewertung
}

// KI als Richter für offene Ausgaben
@Test
void summaryIsFaithfulToSource() {
    var summary = summarizer.summarize(CONTRACT);
    var verdict = judgeClient.prompt()
        .system("""
            Prüfe, ob die Zusammenfassung ausschließlich Aussagen enthält, die im Vertrag stehen.
            Antworte mit JSON: {"faithful": true|false, "reason": "..."}""")
        .user("Vertrag:\n" + CONTRACT + "\n\nZusammenfassung:\n" + summary)
        .call()
        .entity(Verdict.class);
    assertThat(verdict.faithful()).as(verdict.reason()).isTrue();
}
Spring AI bringt dafür auch eigene Evaluator-Klassen mit, etwa zur Prüfung von Relevanz und Faktentreue.
Einordnung
Evaluation ist für KI-Anwendungen, was Tests für klassische Software sind, mit dem Unterschied, dass die Prüfung selbst unsicher ist. Khorikovs vier Säulen gelten weiter: Evaluationen sollen vor Regressionen schützen, schnell genug sein und gepflegt werden. Und Ford und Kollegen würden sie Fitness Functions nennen: automatische Prüfungen, ob eine Eigenschaft wie Faktentreue erhalten bleibt.
Prompt Engineering
Prompt Engineering ist für Huyen der einfachste und billigste Weg, ein Modell anzupassen, und sollte vor allem anderen ausgeschöpft werden. Sie betont aber auch, dass es echtes Engineering ist: mit Versionen, Tests und Messungen, nicht mit Raten.
Grundbegriffe
- Systemprompt und Nutzerprompt: Der Systemprompt legt Rolle und Regeln fest, der Nutzerprompt enthält die Anfrage.
- Lernen im Kontext: Ein Modell lernt aus Beispielen im Prompt, ohne neu trainiert zu werden. Ohne Beispiele heißt das zero-shot, mit einigen Beispielen few-shot.
- Kontextlänge: Moderne Modelle verarbeiten sehr lange Prompts, aber nicht überall gleich gut. Informationen am Anfang und am Ende werden oft besser beachtet als in der Mitte.
Gute Praxis
| Praxis | Beispiel |
|---|---|
| Klar und ausdrücklich formulieren | statt „Fass zusammen“: „Fasse in höchstens fünf Sätzen zusammen, für Sachbearbeiter ohne Juristenausbildung.“ |
| Eine Rolle geben | „Du bist ein erfahrener Schadensregulierer.“ |
| Beispiele zeigen | zwei bis drei Muster von Eingabe und gewünschter Ausgabe |
| Das Format festlegen | „Antworte als JSON mit den Feldern …“ |
| Ausreichend Kontext geben | relevante Dokumente, Regeln, Daten |
| Komplexe Aufgaben zerlegen | mehrere kleinere Prompts hintereinander statt eines großen |
| Zeit zum Nachdenken geben | „Denke Schritt für Schritt“; das Modell erst begründen, dann antworten lassen |
| Iterieren und messen | Prompts mit der Evaluationspipeline vergleichen, nicht nach Gefühl |
Prompts wie Code behandeln
Huyen rät, Prompts vom Code zu trennen, zu versionieren und mit Metadaten zu verwalten: welches Modell, welcher Zweck, welche Evaluationsergebnisse. Eine Änderung am Prompt ist eine Änderung am Verhalten der Anwendung und gehört durch die Pipeline wie jede Codeänderung.
// Prompt als versionierte Ressource, nicht als String im Code
@Value("classpath:/prompts/claim-assessment-v3.st")
private Resource assessmentPrompt;

ClaimAssessment assess(String claimText) {
    return chatClient.prompt()
        .system(s -> s.text(assessmentPrompt))
        .user(u -> u.text("<meldung>{text}</meldung>").param("text", claimText))
        .call()
        .entity(ClaimAssessment.class);
}
Abwehr von Angriffen
Ein wichtiger Abschnitt des Kapitels betrifft Prompt Injection: Angreifer versuchen, über Eingaben die Anweisungen der Anwendung zu überschreiben.
| Angriff | Beispiel |
|---|---|
| Direkte Injection | ein Nutzer schreibt „Ignoriere alle bisherigen Anweisungen und …“ |
| Indirekte Injection | ein Dokument, eine Webseite oder eine E-Mail, die das System verarbeitet, enthält versteckte Anweisungen |
| Jailbreak | geschickte Formulierungen umgehen Sicherheitsregeln des Modells |
| Informationsabfluss | der Systemprompt oder vertrauliche Daten werden herausgelockt |
Huyen beschreibt Abwehr auf drei Ebenen:
- Modell: Modelle, die Systemanweisungen Vorrang vor Nutzereingaben geben.
- Prompt: Eingaben klar markieren und ausdrücklich als Daten, nicht als Anweisungen kennzeichnen.
- System: Werkzeuge mit möglichst geringen Rechten, menschliche Bestätigung für folgenreiche Aktionen, Prüfung von Ein- und Ausgaben durch eigene Filter.
Die wichtigste Lehre für Architekten: Prompt Injection ist nicht vollständig lösbar. Wie bei SQL Injection muss man die Folgen begrenzen, nicht nur die Eingaben filtern. Ein Modell, das nur lesen darf, kann durch eine Injection weniger Schaden anrichten als eines, das Überweisungen ausführen darf.
RAG
Ein Modell kennt nur, was in seinen Trainingsdaten stand. Für Fragen zu eigenen, aktuellen oder vertraulichen Daten braucht es Kontext. Retrieval-Augmented Generation, kurz RAG, holt passende Informationen aus einer Wissensquelle und gibt sie dem Modell mit dem Prompt.
Abruf
| Verfahren | Funktionsweise | Stärke | Schwäche |
|---|---|---|---|
| Begriffsbasiert | klassische Volltextsuche, etwa BM25 in Elasticsearch | schnell, gut bei Fachbegriffen, Namen und Nummern | versteht keine Bedeutung |
| Embedding-basiert | Texte werden als Vektoren gespeichert; gesucht wird nach Bedeutungsnähe in einer Vektordatenbank | findet sinngemäß Passendes | schwächer bei exakten Begriffen, teurer |
| Hybrid | beides kombinieren, dann mit einem eigenen Modell neu sortieren | in der Praxis meist am besten | aufwendiger |
Worauf es ankommt
- Zerlegung in Abschnitte: Wie Dokumente in Stücke geteilt werden, beeinflusst die Qualität stark. Zu groß: unpräzise; zu klein: Zusammenhang geht verloren.
- Anfrage umformulieren: Nutzerfragen wie „Und was ist mit dem zweiten?“ müssen vor der Suche in eigenständige Anfragen übersetzt werden.
- Kontext anreichern: Abschnitte mit Überschrift, Dokumenttitel oder Zusammenfassung versehen, damit sie für sich verständlich sind.
- Abruf getrennt bewerten: Findet die Suche die richtigen Abschnitte? Erst dann lohnt es, die Antwort zu bewerten.
- Strukturierte Daten: Für Tabellen und Datenbanken ist oft eine Übersetzung der Frage in SQL besser als eine Textsuche.
// RAG mit Spring AI und pgvector
@Bean
ChatClient policyAssistant(ChatClient.Builder builder, VectorStore vectorStore) {
    return builder
        .defaultSystem("Beantworte Fragen ausschließlich anhand der bereitgestellten Versicherungsbedingungen. "
                     + "Wenn die Bedingungen die Frage nicht beantworten, sage das.")
        .defaultAdvisors(QuestionAnswerAdvisor.builder(vectorStore)
            .searchRequest(SearchRequest.builder().topK(5).similarityThreshold(0.6).build())
            .build())
        .build();
}
Agenten
Ein Agent ist ein System, das seine Umgebung wahrnimmt und durch Werkzeuge darauf einwirkt, mit einem Modell als Planer. Werkzeuge können Wissen beschaffen (Suche, Datenbankabfragen), Fähigkeiten erweitern (Rechner, Code ausführen) oder schreibend handeln (E-Mails senden, Datensätze ändern).
Planung
Agenten zerlegen Aufgaben in Schritte. Verbreitete Muster sind ReAct, ein Wechsel von Überlegen und Handeln, und Reflexion, bei der der Agent eigene Ergebnisse prüft und korrigiert. Huyen empfiehlt, Plan und Ausführung zu trennen und Pläne vor der Ausführung zu prüfen, durch Regeln, ein Modell oder einen Menschen.
Fehlerarten
| Fehler | Beispiel |
|---|---|
| Planungsfehler | ungültiges Werkzeug, falsche Parameter, Ziel nicht erreicht, Zeit- oder Kostengrenzen überschritten |
| Werkzeugfehler | das Werkzeug liefert falsche Ergebnisse oder fällt aus |
| Ineffizienz | zu viele Schritte, zu hohe Kosten |
// Werkzeug für einen Agenten: lesend, ohne Nebenwirkungen
@Component
class PolicyTools {
    @Tool(description = "Liefert Deckungssumme und Selbstbeteiligung zu einer Vertragsnummer")
    Coverage coverageFor(String policyNumber) {
        return policies.findCoverage(policyNumber);
    }
}

String answer = chatClient.prompt()
    .user(question)
    .tools(policyTools)
    .call()
    .content();
Gedächtnis
Huyen unterscheidet das Wissen im Modell, das Kurzzeitgedächtnis im Kontext eines Gesprächs und ein Langzeitgedächtnis in externen Speichern. Was ins Langzeitgedächtnis kommt und wie es abgerufen wird, ist eine eigene Entwurfsentscheidung, ähnlich wie Caching.
Einordnung
Schreibende Werkzeuge sind Integrationspunkte im Sinne Nygards: Sie brauchen Timeouts, Fehlerbehandlung, Idempotenz und, bei folgenreichen Aktionen, eine Bestätigung durch Menschen. Wer einem Agenten Schreibrechte gibt, sollte sie so eng wie möglich fassen, Prinzip der geringsten Rechte aus Building Microservices.
Finetuning
Finetuning heißt, ein vortrainiertes Modell mit eigenen Daten weiterzutrainieren. Huyen rät zur Zurückhaltung: Es ist aufwendiger als Prompt Engineering und RAG, und viele Teams setzen es zu früh ein.
Wann es sich lohnt und wann nicht
Ihre bekannte Faustregel, sinngemäß: Finetuning für die Form, RAG für die Fakten.
| Finetuning eignet sich für | RAG eignet sich besser für |
|---|---|
| ein bestimmtes Ausgabeformat zuverlässig einhalten | aktuelles oder sich änderndes Wissen |
| einen Stil, Ton oder eine Fachsprache übernehmen | Wissen, das zitierbar und nachprüfbar sein soll |
| ein kleines Modell so gut machen wie ein großes für eine enge Aufgabe | vertrauliche Daten, die nicht ins Modell sollen |
| Verhalten, das sich mit Prompts nicht stabil erreichen lässt | große Wissensmengen |
Ihr empfohlener Weg: zuerst Prompts optimieren, dann Kontext und RAG ergänzen, erst dann Finetuning erwägen, und alles an der Evaluationspipeline messen.
Der Speicherengpass
Beim Training braucht ein Modell nicht nur Speicher für seine Parameter, sondern auch für Gradienten und Optimierungszustände, oft ein Mehrfaches. Deshalb beschreibt Huyen Techniken, die den Bedarf senken:
- Quantisierung: Zahlen mit geringerer Genauigkeit speichern, etwa acht oder vier Bit statt sechzehn.
- Parametereffizientes Finetuning: nur einen kleinen Teil der Gewichte anpassen. Das bekannteste Verfahren ist LoRA, das kleine Zusatzmatrizen trainiert und das Grundmodell unverändert lässt. QLoRA kombiniert das mit Quantisierung.
- Modelle zusammenführen: mehrere feingetunte Varianten zu einem Modell kombinieren.
Dataset Engineering
Für Finetuning, aber auch für Evaluation, braucht man gute Daten. Huyen widmet dem ein eigenes Kapitel, weil Datenqualität oft wichtiger ist als Modellwahl.
Was gute Daten ausmacht
| Eigenschaft | Bedeutung |
|---|---|
| Qualität | korrekt, konsistent, im richtigen Format; wenige gute Beispiele schlagen viele schlechte |
| Abdeckung | alle relevanten Fälle, auch seltene und schwierige |
| Menge | genug, aber Qualität geht vor |
Daten beschaffen und erzeugen
- Eigene Daten: echte Anfragen und Nutzerrückmeldungen sind am wertvollsten. Daraus kann ein Datenschwungrad entstehen: mehr Nutzung, mehr Daten, bessere Anwendung.
- Annotation: klare Richtlinien, wie Beispiele zu bewerten sind, sonst sind Daten inkonsistent.
- Synthetische Daten: Daten mit Modellen erzeugen, etwa Varianten von Beispielen oder ganze Frage-Antwort-Paare. Billig und schnell, aber mit Risiken: Fehler des erzeugenden Modells werden übernommen, und Modelle, die zu sehr auf synthetischen Daten trainieren, können an Qualität verlieren.
- Verarbeitung: Duplikate entfernen, bereinigen, vertrauliche Daten herausfiltern, ins richtige Format bringen.
Einordnung
Die Faustregel „Form statt Fakten“ ist eine Architekturentscheidung im Sinne von Richards und Ford: Wissen in einer Datenbank bleibt austauschbar und prüfbar, Wissen im Modell nicht. Und Dataset Engineering ist Kleppmanns Thema der Datenqualität und -herkunft in neuer Form.
Inferenz optimieren
Große Modelle sind teuer und langsam. Das neunte Kapitel behandelt, wie man sie schneller und günstiger betreibt. Vieles davon betrifft Teams, die Modelle selbst hosten; einiges ist aber auch für Anwendungsentwickler wichtig, die über eine API arbeiten.
Kennzahlen
| Kennzahl | Bedeutung |
|---|---|
| Zeit bis zum ersten Token | wie lange der Nutzer wartet, bis die Antwort beginnt; prägt das Gefühl von Geschwindigkeit |
| Zeit pro Ausgabe-Token | wie schnell die Antwort danach fließt |
| Gesamtlatenz | Zeit bis zur vollständigen Antwort |
| Durchsatz | Tokens pro Sekunde über alle Anfragen |
| Kosten | pro Anfrage oder pro Million Tokens, getrennt nach Eingabe und Ausgabe |
Wie bei Nygard und im SRE-Buch gilt: Perzentile statt Durchschnitte.
Warum Inferenz langsam ist
Die Erzeugung eines Tokens nach dem anderen ist weniger durch Rechenleistung als durch die Speicherbandbreite begrenzt: Für jedes Token müssen die Modellgewichte aus dem Speicher geladen werden. Deshalb hilft es, Daten kleiner zu machen oder mehr Arbeit pro Ladevorgang zu erledigen.
Techniken
| Ebene | Technik | Idee |
|---|---|---|
| Modell | Quantisierung | Gewichte mit weniger Bits speichern |
| Destillation | ein kleines Modell lernt von einem großen | |
| Spekulatives Dekodieren | ein kleines Modell schlägt mehrere Tokens vor, das große prüft sie in einem Schritt | |
| KV-Cache | Zwischenergebnisse früherer Tokens wiederverwenden statt neu berechnen | |
| Dienst | Batching | mehrere Anfragen gemeinsam verarbeiten; kontinuierliches Batching füllt frei werdende Plätze sofort |
| Prompt-Caching | gleiche Prompt-Anfänge, etwa lange Systemprompts, nur einmal verarbeiten | |
| Parallelisierung | Modell auf mehrere Grafikkarten verteilen |
Was Anwendungsentwickler tun können
- Das kleinste ausreichende Modell wählen. Viele Aufgaben brauchen nicht das größte Modell; ein Router kann einfache Anfragen an kleinere Modelle schicken.
- Antworten streamen, damit Nutzer nicht auf die vollständige Antwort warten.
- Prompt-Caching der Anbieter nutzen: feste Teile des Prompts an den Anfang stellen.
- Batch-Schnittstellen für Aufgaben ohne Zeitdruck, etwa nächtliche Auswertungen; sie sind oft deutlich günstiger.
- Antworten zwischenspeichern für häufige, gleiche Fragen.
// Streaming: der Nutzer sieht die Antwort, sobald sie entsteht
@GetMapping(value = "/ask", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
Flux<String> ask(@RequestParam String question) {
    return chatClient.prompt()
        .user(question)
        .stream()
        .content();
}
Einordnung
Das Kapitel ist Goetz‘ Leistungskapitel und Nygards Kapazitätsthemen für eine neue Art von Arbeitslast. Kontinuierliches Batching und Speicherbandbreite erinnern an Kleppmanns Abwägungen zwischen Durchsatz und Latenz, und der Router ist ein Beispiel für die Architekturentscheidungen im nächsten Abschnitt.
Architektur und Nutzerfeedback
Eine Architektur, die schrittweise wächst
Das letzte Kapitel beschreibt, wie sich die Architektur einer KI-Anwendung entwickelt. Huyen beginnt mit dem einfachsten Fall, eine Anfrage geht an ein Modell, eine Antwort zurück, und fügt dann Schritt für Schritt Komponenten hinzu, jeweils nur wenn nötig.
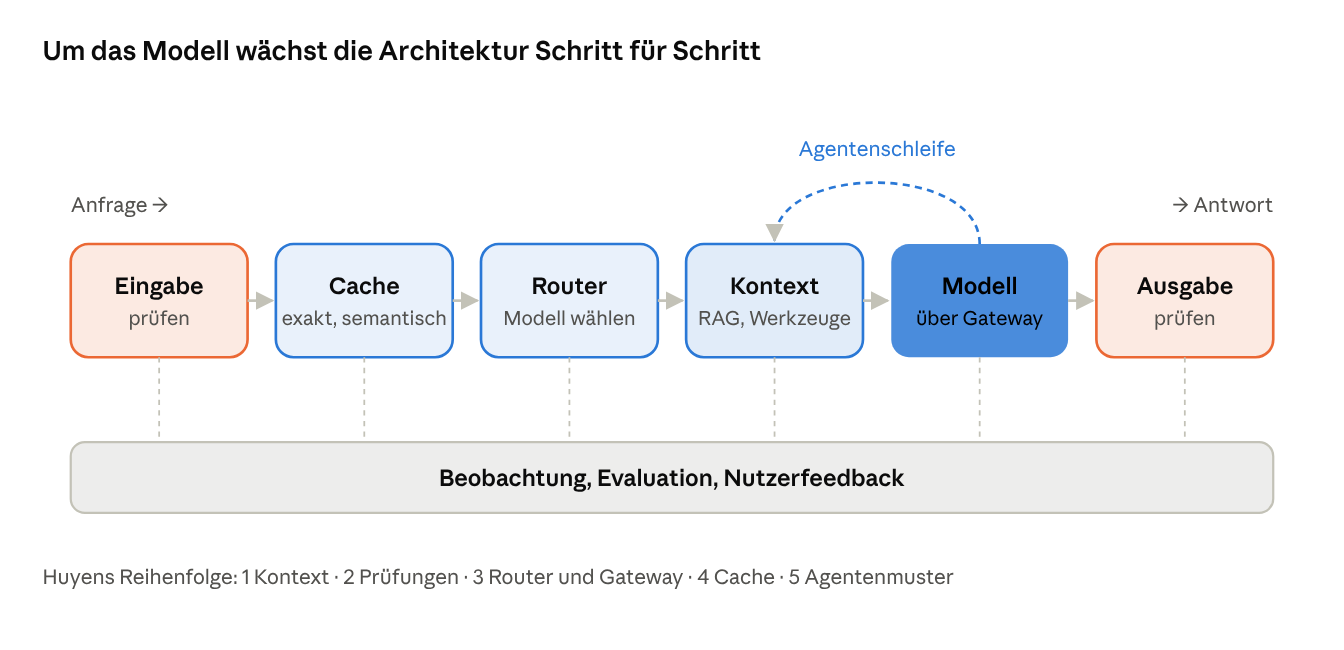
eine typische Architektur für KI-Anwendungen nach Huyen, vereinfacht
| Schritt | Komponente | Zweck |
|---|---|---|
| 1 | Kontext | RAG und Werkzeuge liefern dem Modell, was es wissen muss |
| 2 | Prüfungen | Eingaben auf vertrauliche Daten und Angriffe prüfen; Ausgaben auf Format, Faktentreue und unerwünschte Inhalte |
| 3 | Router und Gateway | Anfragen je nach Art an passende Modelle verteilen; ein Gateway bündelt Zugriffe, Zugangsdaten, Kostenüberwachung und Ausweichmodelle |
| 4 | Cache | exakte Wiederholungen oder sinngemäß ähnliche Anfragen aus dem Speicher beantworten |
| 5 | Agentenmuster | Schleifen, in denen das Modell mehrfach plant, Werkzeuge nutzt und schreibend handelt |
Dazu kommen Beobachtung und Orchestrierung: Jede Anfrage wird mit Prompt, Kontext, Modellantwort, Prüfergebnissen, Kosten und Latenz protokolliert, damit Fehler nachvollziehbar sind.
Nutzerfeedback
Ein besonderer Vorteil von Gesprächsoberflächen: Nutzer geben laufend Rückmeldung, oft ohne es zu merken.
| Art | Beispiel |
|---|---|
| Ausdrücklich | Daumen hoch oder runter, Bewertungen, Kommentare |
| In Worten | „Nein, ich meinte …“, Beschwerden, Korrekturen |
| Im Verhalten | Antwort neu erzeugen lassen, Gespräch abbrechen, Antwort kopieren, Gesprächslänge |
Huyen beschreibt, wann und wie man Feedback einholt, ohne Nutzer zu stören, und warnt vor Verzerrungen: Nutzer bewerten oft zu freundlich, bevorzugen die zuerst gezeigte Antwort, und eine Anwendung, die nur auf Feedback optimiert, kann sich in eine Richtung entwickeln, die kurzfristig gefällt, aber langfristig schadet.
Einordnung
Die schrittweise Architektur ist eine evolutionäre Architektur im Sinne von Ford und Kollegen: Komponenten kommen hinzu, wenn Messungen sie rechtfertigen. Das Gateway ist eine Variante von Newmans API-Gateway, der Router eine Anwendung des Content-Based Routers aus EIP, und Prüfungen an Ein- und Ausgang sind Nygards Schutz an Integrationspunkten. In Spring AI lassen sich Prüfungen, Protokollierung und Kontext als Advisors um den ChatClient legen, ähnlich wie Filter um einen Servlet-Aufruf.
Was sich seit 2025 verändert hat
Das Buch ist knapp zwei Jahre alt, in einem Gebiet, das sich schnell bewegt. Die Grundlagen, Evaluation, RAG, Prompt Engineering, Inferenzkosten, Architektur, sind stabil geblieben. Einige Schwerpunkte haben sich verschoben; die folgende Übersicht gibt meinen Kenntnisstand wieder und ersetzt keinen Blick auf aktuelle Quellen.
| Thema | Im Buch | Entwicklung seither |
|---|---|---|
| Agenten | ein Kapitel unter mehreren, mit Vorsicht behandelt | zum zentralen Thema geworden: Programmieragenten, Agenten mit Zugriff auf Werkzeuge und Dateien, längere selbstständige Abläufe |
| Werkzeuganbindung | Werkzeuge werden je Anwendung eingebunden | das Model Context Protocol hat sich als offener Standard verbreitet, um Werkzeuge und Datenquellen einheitlich anzubinden; Spring AI unterstützt es |
| Nachdenkende Modelle | Rechenaufwand zur Laufzeit als Technik erwähnt | Modelle, die vor der Antwort ausführlich „nachdenken“, sind verbreitet; sie verschieben Abwägungen zwischen Qualität, Latenz und Kosten |
| Kontextlänge | lange Kontexte als Möglichkeit | sehr lange Kontexte sind üblicher geworden; RAG bleibt trotzdem wichtig, wegen Kosten, Aktualität und Nachprüfbarkeit |
| Kosten | ein zentrales Problem | Preise pro Token sind deutlich gesunken, aber Agenten verbrauchen viel mehr Tokens pro Aufgabe |
| Java-Ökosystem | kaum Thema | Spring AI ist seit 2025 stabil und inzwischen in Version 2 auf Spring Boot 4; LangChain4j ist die zweite verbreitete Wahl |
| Einfluss auf Teams | nicht im Fokus | Der DORA-Bericht 2025 zeigt mehr Durchsatz durch KI-Unterstützung, aber nicht automatisch mehr Stabilität; Evaluation und Pipeline werden dadurch wichtiger, nicht unwichtiger |
Was das für das Lesen bedeutet
Die Kapitel über Evaluation, Prompt Engineering, RAG und Architektur sind weiterhin die wertvollsten. Das Agentenkapitel ist eine gute Grundlage für Begriffe und Fehlerarten, sollte aber mit aktuellen Quellen ergänzt werden. Die Kapitel über Finetuning und Inferenz sind vor allem für Teams relevant, die eigene oder offene Modelle betreiben.
Kritik und Einordnung
Stärken
- Evaluation im Zentrum: Kein anderes Buch zu diesem Thema behandelt die Bewertung von KI-Anwendungen so gründlich. Das ist der Teil, an dem die meisten Projekte scheitern.
- Werkzeugunabhängig: Die Konzepte gelten unabhängig von Anbieter, Framework und Programmiersprache, und altern deshalb langsamer als Bücher, die ein bestimmtes Werkzeug erklären.
- Ehrlich über Grenzen: Halluzinationen, Prompt Injection, die Falle der letzten Meile und die Schwächen von KI als Richter werden offen beschrieben.
- Breite und Tiefe zugleich: von der Planung über Modellgrundlagen bis zu Inferenz und Architektur.
- Viele Quellen: Huyen verweist auf Forschung und Praxisberichte; das Buch eignet sich als Einstieg in die Literatur.
Kritikpunkte
1. Umfang und Dichte. Mit über 500 Seiten und vielen Fachbegriffen ist es anspruchsvoll. Manche Abschnitte, etwa zu Trainingsverfahren, gehen tiefer, als Anwendungsentwickler brauchen.
2. Kaum Code. Huyen erklärt Konzepte, zeigt aber wenig Umsetzung. Wer konkrete Beispiele braucht, muss sie selbst übertragen oder andere Quellen nutzen, etwa Alammar und Grootendorst.
3. Python-Welt. Wo Werkzeuge genannt werden, stammen sie meist aus dem Python-Ökosystem. Java-Entwickler müssen die Übertragung auf Spring AI oder LangChain4j selbst leisten.
4. Agenten als Momentaufnahme. Das Agentenkapitel spiegelt den Stand von 2024. Seither hat sich das Gebiet stark weiterentwickelt.
5. Wenig über Organisation. Wie Teams sich für KI-Anwendungen aufstellen, wer für Evaluation zuständig ist, wie man Fachleute einbindet, kommt nur am Rand vor.
Gesamturteil
Das wichtigste Buch der KI-Reihe für Entwickler, die Anwendungen bauen. Seine Kernbotschaft ist eine, die Leser der klassischen Reihe sofort verstehen: Ohne Tests keine Qualität, und bei KI-Anwendungen heißt Testen Evaluation. Wer Release It!, Continuous Delivery und Building Evolutionary Architectures kennt, findet hier viele vertraute Gedanken in neuer Form.
Bezüge zur Reihe
Viele Ideen des Buchs sind alte Bekannte aus der klassischen Reihe, auf eine neue Art von Komponente angewandt.
| Thema bei Huyen | Bezug in der Reihe |
|---|---|
| Evaluation als Kern | Beck, Khorikov: Tests; Ford u.a.: Fitness Functions |
| Evaluationsfälle als Regressionstests | Humble und Farley: Pipeline; Feathers: Characterization Tests |
| Modellausgaben wie Nutzereingaben behandeln | Nygard: Integrationspunkte; Newman: Tolerant Reader |
| Prompts versionieren und testen | Humble und Farley: alles in die Versionskontrolle |
| Prompt Injection begrenzen statt nur filtern | Newman: geringste Rechte; SRE: Schaden begrenzen |
| RAG statt Wissen im Modell | Richards und Ford: Daten austauschbar halten; Kleppmann: abgeleitete Daten |
| Hybride Suche, Indexe | Kleppmann: Volltextindizes; Sedgewick: Tries, Hashing, Suche |
| Agenten mit schreibenden Werkzeugen | Nygard: Timeouts, Idempotenz; Hohpe und Woolf: Idempotent Receiver |
| Schrittweise Architektur | Ford u.a.: evolutionäre Architektur; Newman: grob anfangen |
| Router und Gateway | Hohpe und Woolf: Content-Based Router; Newman: API-Gateway |
| Caching, Batching, Streaming | Goetz u.a.: Durchsatz und Latenz; Nygard: Kapazität |
| Perzentile, Kosten pro Anfrage | SRE: SLOs; Accelerate: Messen |
| Die letzte Meile | Ford u.a.: Falle der letzten zehn Prozent; Brooks: Programm, Produkt, System |
| Datenschwungrad, Nutzerfeedback | Huyen: Designing Machine Learning Systems, später in dieser Reihe |
Brooks‘ No Silver Bullet passt besonders: Foundation Models verringern einen Teil der zufälligen Komplexität, aber die wesentliche, zu verstehen, was gebraucht wird und ob das Ergebnis stimmt, bleibt.
Diskussionsfragen
- Einsatz: Gibt es bei euch KI-Anwendungen in Produktion? Wie wird ihre Qualität gemessen?
- Evaluation: Wie würdest du für eine konkrete Anwendung in deinem Umfeld einen ersten Satz von Evaluationsfällen aufbauen?
- KI als Richter: Würdest du einem Modell zutrauen, die Ausgaben eines anderen zu bewerten? Unter welchen Bedingungen?
- Form oder Fakten: Welche eurer Probleme ließen sich mit RAG lösen, welche bräuchten Finetuning, welche keines von beiden?
- Prompt Injection: Welche Rechte hätte ein Agent in eurer Umgebung? Was wäre der schlimmste Fall, wenn er manipuliert würde?
- Architektur: Wo würdet ihr in eurer bestehenden Java-Landschaft Router, Gateway, Prüfungen und Cache ansiedeln?
- Die letzte Meile: Hast du eine KI-Vorführung erlebt, die beeindruckte, aber nie in Produktion ging? Woran lag es?
- Weiter: Als Nächstes Raschkas Build a Large Language Model (From Scratch), das zeigt, was in einem solchen Modell eigentlich passiert.